
一句话总结:safetensors 只有三段——8 字节小端长度、一段 JSON 头、然后是数据区;一个 93 层 896 专家的模型如果不把专家打包,光头部 JSON 就有 21.76MB,打包后只有 58KB,差 375 倍。
下载 1.56TB 权重不现实,但读它的头部很便宜。
我把 safetensors 格式拆开重写了一遍,用 20 行代码生成文件、用 15 行代码解析。整个过程只碰前几千字节,不碰权重。
这活儿值得做一次,因为模型文件的很多信息藏在头部:张量怎么分、量化到什么精度、分片是否均衡。
safetensors 的格式:8 字节 + 一段 JSON
三段结构,没有魔数,没有版本号。
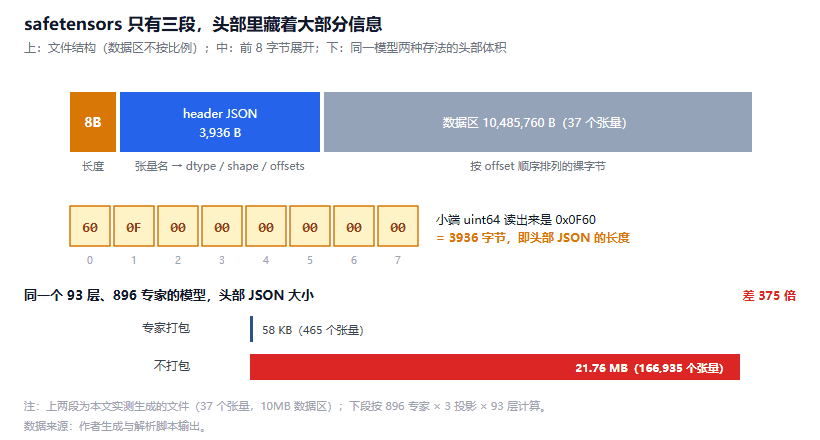
图 1:上为文件三段布局(数据区与头部不按比例),中为前 8 字节的实际取值,下为头部 JSON 大小在打包与不打包时的差。数据来源:本文生成与解析的实测结果
第一段 8 字节,小端 uint64,值是第二段的字节数。
第二段是一段 JSON,键是张量名,值是 dtype、shape 和 data_offsets。
第三段是数据区,所有张量按 JSON 里的 offset 顺序排。
这个设计的好处是加载器可以只读前 8 字节,知道头部多长,再读头部,然后对数据区做 mmap。不需要把 1.56TB 读进内存就能知道里面有什么。
坏处是头部没有校验和。文件损坏了,你只能靠 offset 的重叠和 shape 与字节数的不匹配来判断。
写一个 safetensors 分片,只用 20 行
import json, struct, numpy as np

DT = {"F16": 2, "BF16": 2, "F32": 4, "U8": 1}

def write(path, tensors):
    header, offset, blobs = {}, 0, []
    for name, arr, dt in tensors:
        raw = arr.tobytes()
        header[name] = {"dtype": dt, "shape": list(arr.shape),
                        "data_offsets": [offset, offset + len(raw)]}
        offset += len(raw)
        blobs.append(raw)
    js = json.dumps(header, separators=(",", ":")).encode()
    js += b" " * ((8 - len(js) % 8) % 8)      # 官方实现按 8 字节补齐
    with open(path, "wb") as f:
        f.write(struct.pack("<Q", len(js)))
        f.write(js)
        for b in blobs:
            f.write(b)
    return len(js), offset
我造了一个 12 层的小模型:每层三个张量(q_proj、k_proj、mlp.down_proj),加一个嵌入层,共 37 个张量。
跑出来的结果:
张量 37 个 | header JSON 补齐后 3936 B | 数据区 10485760 B
头部开销占比 0.038%
按 shape+dtype 算出的应有字节 10485760 B,实际写入 10485760 B,一致:True
最后一行是自己给自己上的校验:按 shape 和 dtype 累加出来的字节数,必须等于写入数据区的字节数。不等就是代码有 bug。
0.038% 这个占比说明头部开销可以忽略——对小模型是这样,对大模型不一定,后面会看到。
解析:只读头部,不读权重数据
def read_header(path):
    with open(path, "rb") as f:
        n = struct.unpack("<Q", f.read(8))[0]
        js = f.read(n)
    return n, json.loads(js)
读到 n=3936,就只读 3936 字节的 JSON,剩下的 10MB 一个字节都不碰。
对一个 1.56TB 的模型,这套读法能在几毫秒里拿到全部张量的名字、形状和位置。
真正有用的信息在这里:
- 张量命名规则能看出架构(
self_attn.q_a_proj说明是 MLA,experts.0.gate_proj说明专家没打包) - dtype 能看出量化精度(
U8说明是打包过的 4 位或更低) - data_offsets 的连续性说明文件是否被重排过
一个坏的 safetensors 文件长什么样
我故意造了一个:让 b.weight 的起始 offset 落在 a.weight 的范围内。
bad.safetensors: header 192 B, 3 张量, 数据 40 B, 首个 offset 0, 空隙合计 -8 B
   ! c.weight: shape 要求 16 B,声明 8 B
   ! 重叠: a.weight[0:16] 与 b.weight[8:24]
两个问题同时被抓出来:shape 和字节数对不上、两个张量的区间重叠。
解析器里这段逻辑:
span.sort()
for i in range(1, len(span)):
    if span[i][0] < span[i-1][1]:
        issues.append(f"重叠: {span[i-1][2]} 与 {span[i][2]}")
gaps = sum(span[i][0] - span[i-1][1] for i in range(1, len(span)))
空隙合计是负数,就是重叠
把所有张量按起始 offset 排序,相邻两个之间的空隙加起来。
正常文件这个数是 0(或者正的,因为对齐补齐)。出现负数就一定有重叠。
那个坏文件是 -8,因为 b 往回退了 8 个字节。
这个指标比逐个两两比对省事——O(n log n) 排一次序,扫一遍就完事,不用 O(n²)。
顺带说,负数这个判据只能抓重叠,抓不出"两个张量指向同一个区间"的完全重复。要抓那个得看 offset 对是否完全相同。我加了这条检查,但没在文章里展开。
21MB 的 safetensors 头部是怎么来的
这是这次最值得记的一个数。
同一个 93 层、896 专家的模型,两种存法:
| 存法 | 张量数 | 头部 JSON |
|---|---|---|
| 专家打包成一个张量 | 465 | 58,048 B |
| 每个专家单独存 | 166,935 | 21.76 MB |
差 375 倍。
算一下就知道为什么:896 个专家 × 3 个投影 × 93 层 = 249,984 个张量,加上注意力层和嵌入层,16.7 万个。
每个张量在 JSON 里要占约 130 字节(名字 + dtype + shape + 两个 offset),16.7 万 × 130 = 21.7MB。对上了。
这不是理论问题。Hugging Face 上有些 MoE 模型就是按专家拆开存的,加载器要先解析 20 多 MB 的 JSON 才能开始 mmap。启动慢一两秒,在容器里冷启动时很显眼。
打包的代价是:加载器必须自己知道怎么切。gate_up_proj 一个张量装 896 个专家,形状是 [896, 3072, 14336],读某个专家要自己算偏移。
所以选哪边是个权衡:头部小、加载快,但读取逻辑复杂,或者反过来。
从 safetensors 的 total_size 反推量化位宽
这是头部最实用的一条用法。
model.safetensors.index.json 里有个 total_size 字段,是所有分片数据区的字节数之和。拿它除以参数量,就是位宽:
1.56e12 B × 8 / 2.78011e12 = 4.49 bit/参数Kimi K3.1 Pro 的模型页标 MXFP4,理论开销 4.25 bit。实测 4.49,多出来的 0.24 bit 说明约 6% 的参数在 8 位上。
这个反推不需要下载权重,只看 index.json 就够。Kimi K3.1 Pro 的 1.56TB 就是这么算出来的,顺手还发现 93 层里只有 24 层是带索引的全注意力。
同样的方法也适用于判断一个"Q4"模型是不是真的 Q4:把文件大小除以标称参数量,4.5 左右是 Q4_K_M,5.6 是 Q5,8.5 是 Q8。差得远就说明标称有问题,或者参数量标的是 effective 而不是真实值。
后者在端侧模型上很常见。Gemma 4 那篇里算过,E2B 的标称是 effective 参数,真实权重文件大小才能反推出原始规模。
坑清单
1. 按大端读那 8 个字节。
struct.unpack(">Q") 读出来是个天文数字,然后 f.read(天文数字) 直接把内存吃爆。格式规定是小端,<Q。
2. 忘了 JSON 的补齐空格。
官方实现会把 JSON 补到 8 字节的倍数,补的是空格。json.loads 能吃带尾随空格的字符串,所以解析不会报错——但如果你按 8 + n 去定位数据区,而文件里补了空格没算进 n,后面全错位。
我的写法是补齐之后再算 len(js),n 里包含空格。
3. 用 data_offsets 的差值当文件大小。
最后一个张量的结束 offset 是数据区大小,不是文件大小。文件大小 = 8 + 头部长度 + 数据区大小。
对 1.56TB 的文件差 4KB 无所谓,对做完整性校验的程序就是 bug。
4. 以为 dtype 是 numpy 的类型名。
实际取值是 F16、BF16、F32、U8、I8、F8_E4M3 这一套。numpy 里没有 BF16,要自己映射成 uint16 再解释。
F8_E4M3 这类浮点 8 位格式更麻烦,numpy 完全不认。
5. 拿 shape 乘积去算字节数,忘了 dtype 的字宽。
[256, 512] 的 F16 张量是 262,144 字节,不是 131,072。所有按 shape 算大小的代码都要乘字宽。
结语
解析 safetensors 这件事本身没什么技术含量,格式简单到用 15 行就能读完。
价值在于它给了你一个不下载权重就能看穿模型文件的口子。位宽、分片策略、专家是否打包、有没有重叠损坏——全在几千字节里。
我建议每个要部署大模型的人都写一遍这个解析器。不是为了用,是为了在加载器报"缺 shard"或者"unexpected key"的时候,知道它在说什么。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。