
一句话总结:用 50 行 Python 把三种时钟协议各跑一遍,单 token 延迟从 10 毫秒涨到 80 毫秒,最优思考预算从 256 token 掉到 64 token;换成 Paused Clock,同一套逻辑的最优策略直接反过来。
前天写完 Realtime-Bench 那篇解读,有人在评论区问我:44% 和 36% 之间那 8 个点,是模型不行还是任务太难?
我答不上来。论文给的是结果,没给过程。想了两天,决定自己造一个最小模型跑一遍,看能不能复现出"加大推理强度反而变差"这个反常现象。
能。而且原因比我想的简单。
时钟协议的第一件事:把任务写成截止时间
先要有一个"世界"。这个世界的全部内容,就是 2000 个任务的截止时间:模型从看到任务到必须出手,中间有多少秒。
import hashlib, statistics

N = 2000

def rnd(seed, i):
    h = hashlib.sha256(f"{seed}:{i}".encode()).hexdigest()
    return int(h[:8], 16) / 0xFFFFFFFF

# 每个任务的截止时间(秒):2 到 12 秒之间铺开
DEADLINE = [2.0 + 10.0 * rnd("deadline", i) for i in range(N)]
随机源用 sha256,不用 random。原因写在坑清单里。
决策质量用一个饱和函数顶上
模型想得越久,决策越准,但收益递减。我用最朴素的饱和函数顶一下:
def p_correct(budget, k=192.0):
    return budget / (budget + k)
k 是"半效点":思考 192 个 token 时,正确率刚好 50%。这个数是我拍的,没有任何论文支持。整篇代码里最脆的一环就是它,后面会单独说。
然后是最关键的一步——环境在模型思考的时候走不走。
三种时钟协议,差别只有一行代码
def run(latency_ms, budget, mode):
    lat = latency_ms / 1000.0
    think = budget * lat

    if mode == "paused":
        ontime_prob = 1.0                      # 环境冻结
    elif mode == "token":
        ontime_prob = statistics.mean(
            1.0 if budget <= d / lat * 4 else 0.0 for d in DEADLINE)
    else:                                       # wall clock
        ontime_prob = statistics.mean(
            1.0 if think <= d else 0.0 for d in DEADLINE)

    p = p_correct(budget)
    p1 = p * ontime_prob
    return p1, p1 ** 3
三种协议的分歧,就是 ontime_prob 那三行。
Paused Clock 恒等于 1,思考不花环境时间,想多久都来得及。
Wall Clock 比的是 think <= d——真实的墙钟时间,这是线上最接近的口径。
Token Clock 我做了个近似:把截止时间按 token 数放大 4 倍。这个 4 是拍的,用意是"环境推进得比墙钟慢",但慢多少没有依据。这是第二个脆的地方。
三种时钟协议跑出来的三张表
先看 Wall Clock。每格是 Pass^1 / Pass^3,横轴是单 token 延迟。
| 预算 | 10ms | 20ms | 40ms |
|---|---|---|---|
| 64 | 25.0 / 1.6 | 25.0 / 1.6 | 23.4 / 1.3 |
| 128 | 40.0 / 6.4 | 37.4 / 5.2 | 26.8 / 1.9 |
| 192 | 50.0 / 12.5 | 40.0 / 6.4 | 21.0 / 0.9 |
| 256 | 53.4 / 15.2 | 38.3 / 5.6 | 9.6 / 0.1 |
| 384 | 53.3 / 15.2 | 28.0 / 2.2 | 0.0 / 0.0 |
| 512 | 48.7 / 11.6 | 12.3 / 0.2 | 0.0 / 0.0 |
| 1024 | 14.2 / 0.3 | 0.0 / 0.0 | 0.0 / 0.0 |
| 2048 | 0.0 / 0.0 | 0.0 / 0.0 | 0.0 / 0.0 |
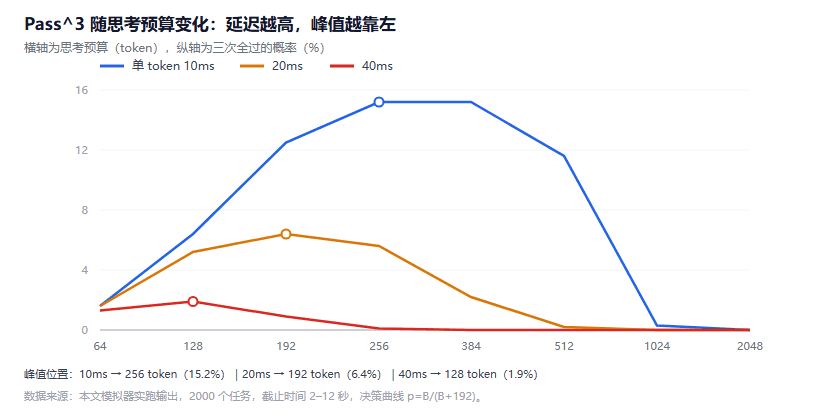
图 1:横轴为思考预算,纵轴为 Pass^3。三条曲线的峰值不在同一位置,延迟越低,峰值越靠右。数据来源:本文模拟器实跑输出
每一列都有一个峰值,而且峰值位置随延迟左移:10ms 在 256 token,20ms 在 192,40ms 在 128。延迟翻倍,最优预算减半。
再把 80ms 也加进来:64 token,Pass^3 只有 0.5%。
这四组数放在一起看,就是一条很干净的规律:最优思考预算约等于"截止窗口"除以"单 token 延迟"。10 毫秒延迟下想 256 个 token,花 2.56 秒;40 毫秒延迟下想 128 个,花 5.12 秒。后者反而更慢,因为慢的模型必须更早动手。
换协议看第二张表,延迟固定 20ms:
| 预算 | Wall | Token | Paused |
|---|---|---|---|
| 64 | 1.6 | 1.6 | 1.6 |
| 128 | 5.2 | 6.4 | 6.4 |
| 192 | 6.4 | 12.5 | 12.5 |
| 256 | 5.6 | 18.7 | 18.7 |
| 384 | 2.2 | 29.6 | 29.6 |
| 512 | 0.2 | 31.4 | 38.5 |
| 1024 | 0.0 | 18.0 | 59.7 |
| 2048 | 0.0 | 0.4 | 76.4 |
Wall 那列在 192 到顶,然后往下掉。Paused 那列一路往上,2048 token 时 76.4%。
同一套代码、同一个模型,只换时钟,最优策略从"别想太多"变成"能想多久想多久",成功率差 11.9 倍。
这个 11.9 倍,比 Realtime-Bench 论文里那 8 个点更能说明问题。论文测的是真实模型,差距被模型本身的能力掩盖了一部分;模拟器里只有一个假设的 p(B) 曲线,差距全暴露出来。
第三张表是把预算从最优点继续往上加:
| 预算(20ms) | Pass^3 | 相对最优 |
|---|---|---|
| 192 | 6.4% | 1.00x |
| 384 | 2.2% | 0.34x |
| 768 | 0.0% | 0 |
| 1536 | 0.0% | 0 |
翻一倍掉到三分之一,再翻直接归零。这就是"加大推理强度"在 Wall Clock 下的代价。
坑清单:时钟协议里我踩到的四个点
1. 用 hash() 当随机源,两次结果不一样。
第一版我用 hash((seed, i)) 生成随机流。跑两次,第一次最优预算是 192,第二次 256。查了半天才想起 Python 3.3 之后字符串哈希有随机化,每次进程启动的 salt 不同。
改法就一行:int(hashlib.sha256(...).hexdigest()[:8], 16)。凡是写进文章的数,随机源必须是确定的。
2. 先平均再立方,低估 39.5%。
我把 Pass^3 写成 mean(p) ** 3。这在所有任务 p 相同时是对的,p 不同就错。
拿 2000 个 p 在 0.1 到 0.9 之间铺开测:逐任务立方再平均是 0.1966,先平均再立方是 0.1189。低了 39.5%。
原因不复杂,x**3 在正数上是凸函数,E[x^3] >= E[x]^3。但我第一版就是这么写的,而且结果看着"挺合理",根本没怀疑。
3. 截止区间的宽度,比模型参数更能决定结论。
同样延迟 20ms,只改截止时间的分布:
| 截止区间 | 最优预算 | Pass^3 |
|---|---|---|
| 2–6 秒 | 128 | 4.2% |
| 2–12 秒 | 192 | 6.5% |
| 2–30 秒 | 384 | 15.2% |
| 5–60 秒 | 512 | 29.2% |
区间越宽,最优预算越高,成功率也越高。这说明结论高度依赖任务设定——你把"实时"的门槛定得多严,模型看起来就有多强。
论文里那些数字也受这条约束。50 个任务覆盖 8 类场景,每类的窗口长度不一样,混在一起算均值,等于把不同的截止区间平均掉了。
4. Pass^1 掉到 Pass^3,不是掉 8%,是掉 18%。
GPT-6-Astra 的 44% 和 36%,绝对差 8 个点。但相对跌幅是 8/44 = 18.2%。
这个换算很重要。做产品决策时你关心的是"我的成功率还剩多少",不是"掉了几个点"。36/44 = 81.8%,也就是说三次全过的概率只有单次成功的八成。这个衰减在长流程里会复利——一个 10 步的流程,每步都按这个比例衰减,末端只剩 13.4%。
这套时钟模拟器的边界
说清楚它不是什么。
p(B) = B/(B+192) 是我拍的,没有任何实测支撑。真实模型的"想得越久越准"曲线不是这个形状,有平台期,也可能出现"想太久反而想歪"。
截止时间的均匀分布也是拍的。真实任务的窗口长度分布偏斜,短窗口更多。
Token Clock 里那个放大 4 倍的系数,纯粹为了让曲线分开得好看一点,无依据。
所以这套代码不能用来给真实模型打分,也不能用来预测某个产品的成功率。它能做的只有一件事:证明"环境推进方式会反转最优策略"这个结论,在什么条件下成立,在什么条件下不成立。
要验证真结论,得把 p(B) 换成实测曲线——在同一个任务上跑不同的思考预算,采样几百次测通过率。这件事单卡做不了,需要一批任务和足够的调用预算。
结语
原论文的 44% 和 36%,我用一个 50 行的玩具复现出了同样的方向:环境按墙钟走的时候,加大推理强度会掉分。
但复现出来的量级不一样。论文里掉 8 个点,我这儿掉到零。差别在于真实模型有"想到某个程度就能对"的平台期,我的饱和函数没有。
所以正确的读法是:方向可信,量级不可信。原文的三种时钟协议值得认真看一遍,尤其是 Token Clock 那个设计——它把"模型的时间感知"和"服务的速度"分开了,这个切法比分数有用。
之前复现六格切 GIF 那篇踩过同类的坑 —— 指标选错,结论全反,换个算法才看出真正的差异。顺带说一句,这套代码里最值钱的部分不是模型,是那三个坑。任何写"随机实验"的文章都该过一遍:随机源确定吗、聚合顺序对吗、结论对参数敏感吗。这三条不过,跑出来的数只能骗自己。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。