
一句话总结:写了个批处理排队模拟,容量 10 请求/秒、单批服务 800 毫秒;利用率从 0.8 拉到 0.99,吞吐只多 24%,P99 延迟从 2.9 倍变成 14.9 倍。
做推理服务的人迟早要回答一个问题:卡开到多满合适?
开太满,延迟崩;开不满,成本摊不掉。这个取舍有个数学形状,我用最朴素的排队模型跑了一遍。
先看一组排队数字
设定:批大小 8,单批服务时间 800 毫秒,所以理论容量是 10 请求/秒。到达按泊松流,跑 8000 个请求。
| 到达率 | 利用率 | P50 | P95 | P99 | P99/服务时间 |
|---|---|---|---|---|---|
| 2.0 | 0.20 | 1155 | 1558 | 1592 | 1.99 |
| 5.0 | 0.50 | 1198 | 1561 | 1597 | 2.00 |
| 8.0 | 0.80 | 1314 | 1910 | 2323 | 2.90 |
| 9.0 | 0.90 | 1494 | 2585 | 3024 | 3.78 |
| 9.5 | 0.95 | 1859 | 4184 | 4802 | 6.00 |
| 9.8 | 0.98 | 3046 | 8873 | 9710 | 12.14 |
| 9.9 | 0.99 | 3895 | 11041 | 11914 | 14.89 |
从 0.80 到 0.99:吞吐涨 23.75%,P50 涨 2.96 倍,P99 涨 5.13 倍。
利用率 0.5 以下,加负载是免费的
看前两行。
利用率 0.20 时 P99 是 1592 毫秒,0.50 时是 1597 毫秒。差了 5 毫秒。
这个区间的延迟几乎全部由服务时间决定(800 毫秒的批处理 + 排队等批的时间),排队本身贡献很小。在这个区间加负载,用户感觉不到。
这是扩容决策里最容易被忽略的一段:如果你的系统利用率在 0.3、0.4,加一倍流量也不会变慢,不需要提前扩容。
P99 为什么比 P50 先炸
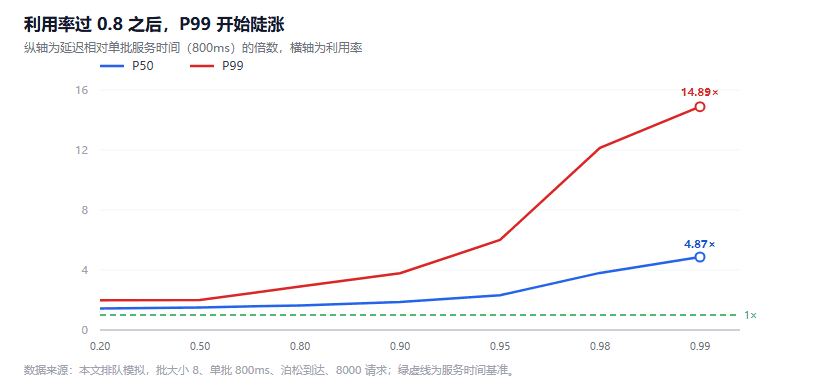
图 1:横轴为利用率,纵轴为延迟(毫秒)。虚线是单批服务时间 800 毫秒
因为 P99 看的是"最倒霉的那批请求",它们恰好撞上队列最长的时候。
利用率越高,队列长度的波动越大。0.99 利用率下,队列平均长度已经很长,任何一点随机波动都会让某一批请求多等好几十个服务周期。
P50 之所以稳,是因为它对应"撞上平均队列长度"的请求,平均值的波动比尾部小一个量级。
这也解释了为什么线上监控看平均延迟没用:平均延迟 1.5 秒的时候,P99 可能已经 10 秒。 而用户投诉的永远是那 1%。
排队和批处理的关系
批处理是在用延迟换吞吐。
批大小 8 意味着:一个请求到了之后,要等最多 7 个同伴凑齐才能一起走。这个"等同伴"的时间就是批处理引入的延迟。
所以排队模型里有两个延迟源:
- 凑批等待:取决于到达率,密度高就快
- 队列等待:取决于利用率和波动
上一批写内核融合时算的是单次调用开销占 75%,那是"每次都要付的固定成本";这里算的是"负载高了才爆炸的边际成本"。两笔账要分开算。
实用结论:批处理适合离线和高并发场景,不适合低并发低延迟场景。 到达率低的时候,凑批等待反而成了主要延迟。
坑清单
1. 用平均延迟做容量规划。
平均延迟在利用率 0.8 之前几乎不动,看着还有余量;但 P99 已经在涨了。容量规划要看 P95 或 P99。
2. 忘了服务时间的方差。
我的模型里服务时间是固定的 800 毫秒。真实推理时长随输出 token 数变化,方差大的时候队列波动更大,P99 会更早爆炸。这条结论只会更严重,不会更轻。
3. 把利用率算成"卡的使用率"。
GPU 利用率 90% 和请求利用率 0.9 不是一回事。前者是硬件忙不忙,后者是队列稳不稳。看错指标会得出相反的结论。
4. 只算容量不算突发。
泊松流是平滑的。真实的流量有早晚高峰和营销活动,瞬间到达率可能是均值的 3 倍。按均值算出来的 0.7 利用率,在高峰时就是 2.1,直接崩。
5. 忽略批内首尾差异。
一批 8 个请求,第一个和第八个的等待时间能差半个服务周期。我的模型算的是各自真实的完成时间差,但很多监控只记"批次耗时",把这个差异抹掉了。
结语
这组数字最有用的不是"0.9 太危险",是那条几乎水平的低利用率区间。
它说明容量规划不是线性外推,而是找拐点:0.5 之前随便加,0.8 之后每 1% 都在用延迟换吞吐。
上周写抽样误差是"样本不够时结论不可信",这篇是"余量不够时延迟不可控"。两个都是非线性系统里最容易被线性直觉骗的地方。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。