
一句话总结:腾讯用 Hy4 训练了一个 Jev 决策模型,8 项测试里有 6 项跑分高于官方版;这是"让模型训模型"目前最小、也最容易验证的一种做法。
递归自我改进(RSI)这个词,这两年被用得太玄。
剥掉玄学,最小可行的版本是这样的:一个大模型去训一个小模型,小模型在某个具体任务上比原来的版本更好。能做成就说明"能力可以不用人教、自己往上走一层"。
腾讯做了一次,规模不大,结果清楚:8 项测试里 6 项更高。
RSI 的最小可行实验
被训的是 Jev。它不是一个通用语言模型,更像一个 if-else 选择器:你给它几个选项,它帮你选。
这类模型有个好处——正确与否可以机械判定。选对选错不靠人评,靠标准答案。这让训练信号的噪声很小。
Hy4 在这里的角色是"教练":它不直接产出答案,而是产出训练另一个模型所需要的东西——数据、反馈、或者训练策略。
官方说法是 Hy4 训出来的是 plus 升级版。8 项测试里 6 项跑分更高。
Hy4 训出的 Jev:RSI 实验的 8 项 6 胜
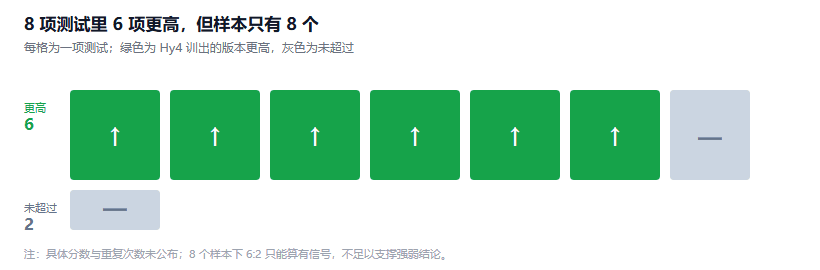
图 1:8 项测试中 6 项高于原版本,2 项未超过;具体分数未公布
这个结果的意义不在"6 比 2 多",在它的可验证性。
RSI 的讨论之所以容易变成玄学,是因为大部分宣称无法验证:说模型变强了,怎么证明?用哪个基准?基准是不是被训练数据污染了?
Jev 的 8 项测试绕开了这个问题——每项都有确定答案,跑一遍就知道。
一个诚实的提醒:8 项测试的样本量极小。 按之前算过的抽样误差,8 个样本的标准差在 15 个百分点以上,6:2 这个分布在统计上只能算"有信号",不能算"确定更好"。要下强结论,得看具体分差和重复次数,这两项公开材料都没给。
为什么模型训模型要先挑小模型
这是整个实验里最值得学的决策。
大模型训大模型,成本高、周期长、失败一次损失大。小模型训小模型,一周能跑几轮,错了就换方案。
更关键的是可解释性。Jev 这种选择器,你能看清它每一项为什么对、为什么错;而一个通用模型的"变强",往往是一堆指标同时动了几个点,说不清是哪一步起了作用。
这和上周写的用户模拟器那篇是同一个方法论:把变量收到只剩一个,结论才敢下。
Hy4 的另外两个数字:7 个领域和两次迭代
同一次发布里还有两个数值得记。
一个是科研侧:在物理建模、地球环境等 7 个领域,Hy4 的跑分是开源模型第一。这个"第一"要打折看——分领域第一不等于每个领域都强,而且"开源"这个限定词把对手范围缩小了。
另一个是迭代节奏:两个月一次,一年时间挤进前排。这个说法来自姚顺雨,指的是团队的整体节奏而非单模型。它比任何跑分都更能说明一家公司现在的位置。
另外还有一条实测细节:让 Hy4 在虚幻引擎里做个游戏 demo,提示词照抄官网,仍然需要人工配环境、下一个 50 多 G 的素材包、配好 MCP 连接才能跑出个样子。离"一句话做 3A"还很远。
关于 RSI 的五个问题
8 项 6 胜算 RSI 吗? 算最弱的一种。它证明了"模型能训出比自己某个子版本更好的小模型",不证明"能力能无限自我提升"。
Jev 是什么? 决策模型,给选项做选择,不生成文本。适合做可机械判定的任务。
为什么不用更大的测试集? 公开材料没说。成本、还是怕暴露细节,都有可能。
这和蒸馏有什么区别? 蒸馏是"大模型教小模型模仿",RSI 强调"训练过程本身由模型完成"。这次实验里两者的边界其实很模糊。
对普通团队有什么用? 有用的一点:如果你的任务有确定答案,可以试试让强模型生成训练数据和反馈,训一个小模型专做这件事。成本和周期都可控。
结语
这次实验的价值不在 6 项更高,在它示范了一个可复制的做法:找一个能机械判分的窄任务,用强模型当教练,训一个小模型,跑 8 项测试看结果。
它不玄,也不贵,一周能跑一轮。RSI 如果真的会成为现实,大概就是从这种小实验开始堆出来的,而不是某天突然出现一个自己训练自己的模型。
上周那篇写 AI 训 AI 的四个数字讲的是同一件事的另一个样本:一个开源模型在千万级沙盒里练手。两个案例放一起看,"模型训模型"这件事已经从概念走到了工程。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。