
一句话总结:腾讯 WorkBuddy 发布三个月后单月 2097 万次 PC 端访问,字节"豆包工作"一周 10 万家企业申请,阿里把三款 Agent 整合成"千问办公";但按单次 0.156 元算,中度使用的用户每月算力成本就接近订阅价。
这一轮 AI 办公的广告打得离谱。机场、地铁、电梯,到处都是。
数据也确实好看:腾讯 WorkBuddy 发布三个月后,单月 2097 万次 PC 端访问;字节"豆包工作"上线一周,超 10 万家企业申请内测;阿里把 QoderWork、悟空、MuleRun 三款产品整合成"千问办公"。
但访问量是分子,不是全部。
AI 办公三个月做到 2097 万次 PC 访问
2097 万次/月,折下来每天约 70 万次。
这个量级说明两件事:一是分发能力强(腾讯的渠道摆在那),二是尝鲜意愿高。
但"访问"这个指标有个致命的模糊:它不区分"用了一次就再也没回来"和"每天用十次"。三个月做到 7000 万累计访问,可能是 100 万人各用 70 次,也可能是 700 万人各用 10 次。前者是产品,后者是广告。
三家打法的差别
腾讯是产品先行:WorkBuddy 走的是"通用办公助手",接入微信、文档、会议这些自有场景。
字节是流量先行:豆包工作靠 C 端流量和企业内测名单铺开。
阿里是整合先行:把散着的三款 Agent 合成一个入口,先解决"用户不知道用哪个"的问题。
三家都在做同一件事:把 agent 塞进已有的办公流程。区别只在塞进哪个流程、用什么方式塞。
访问量不等于留存
这是我最想提醒的一点。
办公软件有个特点:用户会同时装三五个,但每天只开一个。 谁成为那个"每天开一个",取决于它能不能接住用户最高频的那件事——写周报、查数据、约会议、还是整理邮件。
访问量统计不到这个,留存才统计得到。而目前三家公开的都是前者的近亲指标:访问、申请、内测名额。
申请 10 万家企业,和 10 万家企业每天在用,中间隔着一条很长的沟。
AI 办公的成本结构:每次交互都花钱
这是比留存更硬的问题。
传统 SaaS 的边际成本接近零:多一个用户,多占一点存储和带宽,几乎不增加成本。所以订阅制能跑通,毛利 70% 以上。
AI 办公不是。每敲一次字、每跑一个任务,都要付一次推理费。
按一个中等任务算:20K 输入、2K 输出,用上周那家 6/18 元每百万 token 的价格:
20K × 6/1M + 2K × 18/1M = 0.12 + 0.036 = 0.156 元单次一毛五分多,听着不贵。乘上频次就不一样了:
| 使用强度 | 每天次数 | 每月算力成本 |
|---|---|---|
| 轻度 | 5 次 | 约 23 元 |
| 中度 | 20 次 | 约 94 元 |
| 重度 | 50 次 | 约 234 元 |
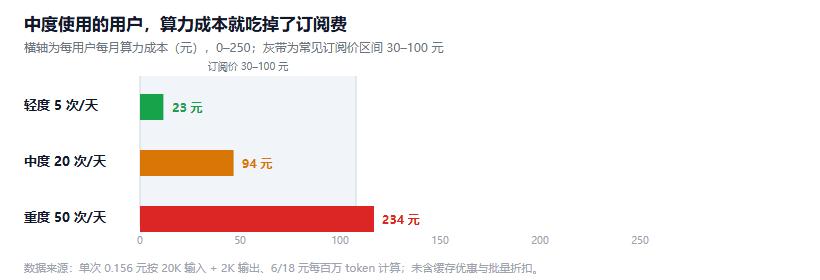
图 1:按 0.156 元/次、每月 30 天计算,不含缓存优惠与批量折扣
办公软件的主流订阅价是每月 30 到 100 元。也就是说:中度使用的用户,算力成本就已经吃掉了整份订阅费,重度用户是亏的。
这就是为什么每家的第一件事都是推"缓存命中"和"小模型路由"——不是技术炫技,是毛利保卫战。缓存命中价通常是输入价的 1/20,能把单次成本压到几分钱;简单任务用小模型,成本再降一个量级。
不做这两件事,用户越多亏越多。
关于 AI 办公的五个问题
2097 万次访问是什么水平? 单月量级不小,但要和"日活"区分。访问次数高可能来自少数高频用户。
企业内测申请 10 万代表什么? 代表采购意愿,不代表使用。企业 IT 部门申请试用是低成本动作。
为什么三家都要做? 因为办公是唯一"高频、刚需、数据在自己手上"的场景,也是唯一能自然接入 Agent 的入口。
能赚钱吗? 能,但毛利率结构会和 SaaS 完全不同。参考云计算的路径:先亏规模,再靠自研芯片和调度效率把毛利拉回来。
对普通用户有什么影响? 短期是补贴战,价格会很低甚至免费;中期会分层——简单任务免费,复杂任务收费。
结语
这一轮 AI 办公的竞争,表面看是产品和渠道,实际是成本曲线的竞争。
谁的缓存命中率高、谁的小模型路由准、谁能把一次交互的成本压到几分钱,谁就能在订阅价不涨的前提下活得久。
访问量决定开局,成本结构决定能不能打完全场。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。