
一句话总结:10 万条 64 维向量、100 个聚类中心,nprobe=1 只扫 1% 的库拿到 18.6% 的召回,nprobe=50 扫一半拿到 92.2%;同样扫描比例下,随机扫只能拿到扫描比例本身的召回。
RAG 做久了会形成一种直觉:向量检索"差不多就行"。
这个"差不多"到底是多少,取决于你扫了多少。我搭了个最小的 IVF 索引,把召回和扫描量的关系测出来了。
实验设置:10 万条 64 维向量
- 库:10 万条 64 维单位向量
- 索引:100 个聚类中心(简版 k-means,3 轮迭代)
- 查询:500 条,真值用暴力搜索算
- 指标:recall@10,即前 10 个结果里命中了几个真值
聚类结果算均匀:簇大小中位 996,最大 1068,最小 903。这说明 k-means 收敛得不错,没有出现"几个大簇吃一半数据"的情况。
向量检索的召回不是免费的
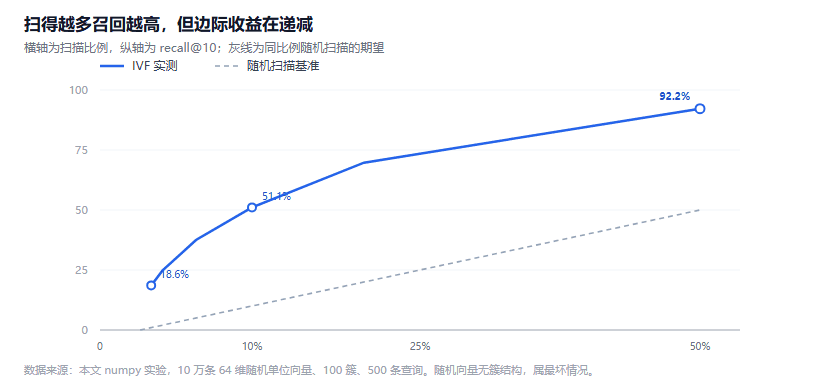
图 1:横轴为扫描比例,纵轴为 recall@10。灰线是随机扫描的期望水平
| nprobe | 扫描比例 | recall@10 | 平均候选数 |
|---|---|---|---|
| 1 | 1% | 18.6% | 1,002 |
| 2 | 2% | 24.7% | 2,000 |
| 5 | 5% | 37.5% | 5,004 |
| 10 | 10% | 51.1% | 10,007 |
| 20 | 20% | 69.7% | 20,001 |
| 50 | 50% | 92.2% | 50,012 |
nprobe=1 时扫了 1% 拿到 18.6%,是同比例随机扫描的 18 倍。说明聚类有效——最近的簇里确实装着近邻。
但 18.6% 这个绝对值不高。十次查询里有八次拿不到完整的正确答案集。
nprobe 的扫描曲线
这条曲线有个明显形状:前面的斜率比后面陡。
从 1% 扫到 10%,扫描量翻 10 倍,召回只从 18.6% 涨到 51.1%(+32.5 个点)。
从 10% 扫到 50%,扫描量翻 5 倍,召回从 51.1% 涨到 92.2%(+41.1 个点)。
按"每多扫 1% 换多少召回"算:
- 1% 到 10% 区间:每 1% 换 3.6 个点
- 10% 到 50% 区间:每 1% 换 1.0 个点
低扫描区间更划算。 这也符合工程直觉:先扫最近的几个簇,收益最高;再往后扫,边际收益递减。
实操上这意味着:如果你的召回要求是 90%,代价是扫一半;如果你能接受 70%,扫 20% 就够——成本差 2.5 倍。
为什么真实场景的召回比这好
必须说明一个重要的前提:我这组数据是"最坏情况"。
10 万条随机单位向量在 64 维空间里几乎两两正交,没有真实的簇结构。真实语义向量的分布不是这样——它们有明确的主题聚集("退货政策"和"退款流程"会挨得很近)。
簇结构越强,同样的 nprobe 下召回越高。所以生产环境里 nprobe=10 通常能拿到 80% 以上,而不是我这儿的 51%。
反过来说,如果你的语料是"均匀分散、没有主题聚集"的(比如随机生成的 ID、哈希值、日志指纹),IVF 的效果会接近我这个实验,甚至更差。
坑清单
1. 用随机向量测出来的召回当生产预期。
随机向量没有簇结构,测出来的是下限。真实语料好得多。但也别反过来——如果你的语料确实没有聚类性,这个下限就是你的实际值。
2. 只看召回,不看延迟。
扫描 50% 意味着 5 万次距离计算。10 万条库扫 5 万条,单查询的耗时比扫 1 万条高 5 倍。召回和延迟必须一起报。
3. 忘记重建索引。
新数据加进来但没重新聚类,新数据会被塞进"最近的旧簇",簇会越来越不平衡。定期重建是必须的,不是优化。
4. 簇数拍脑袋定。
簇数太少,每簇太大,扫一个簇就扫了半个库;簇数太多,索引开销和查询时的中心距离计算都不划算。经验值是每条簇 100 到 1000 条,我这次是 1000。
5. recall@10 和最终效果脱节。
检索召回 90% 不等于答案正确率 90%。检索之后还有排序、拼接、生成三步,每步都会掉点。要把 recall 当上限而不是结果。
结语
这组数字给了一个具体的参照:想省扫描量,就得接受召回损失,而且这个损失不是线性的。
更有用的一条是那个"18 倍":同比例随机扫描只有 1% 的召回,IVF 拿到 18.6%。这说明聚类确实抓到了结构,只是在这个最坏分布的库上抓得不够。
上一批写排队延迟是"资源利用率换延迟",这篇是"扫描量换召回"。两个都是同一个模式:没有免费的档位,只有不同的兑换率。
如果你在做 RAG,建议先在自己的语料上跑一遍这条曲线,再决定 nprobe。别人的 10 不是你的 10。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。