
一句话总结:NaiveRT 把每层 29 次零散 GPU 调用融成 1 个内核,单轮解码从 12.3 毫秒降到 3.4 毫秒;用这两个公开数字反推,每次调用的固定开销约 0.32 毫秒,占总时间的 75%——融合省的从来不是计算,是发射。
上一篇文章提到 NaiveAI 的推理引擎 NaiveRT:6 天、151 轮实验,把 SGLang 每层 29 次零散 GPU 调用融成 1 个 148 线程块的巨型内核,单轮推测解码 12.3 毫秒降到 3.4 毫秒。
12.3 和 3.4 这两个数是公开的。中间发生了什么,公开材料没细说。
但这两个数本身已经够算出一件事了。
内核融合省的 75%:先把这笔账算出来
设每次调用的固定开销是 L,纯计算时间是 T,调用次数 K=29。
串行:K × L + T = 12.3
融合:1 × L + T = 3.4
两式相减:28L = 8.9,L = 0.318 毫秒,T = 3.08 毫秒。
验算:29 × 0.318 + 3.08 = 12.3,对上了。
所以这笔账的答案是:每次调用的固定开销约 0.32 毫秒,29 次就是 9.2 毫秒,占总时间的 75%。
真正"算东西"的时间只有 3.08 毫秒。剩下四分之三,都花在"让 GPU 开始算"这件事上。
这个 75% 就是内核融合的全部意义。它不加速计算,计算还是那么多,它删掉的是等待。
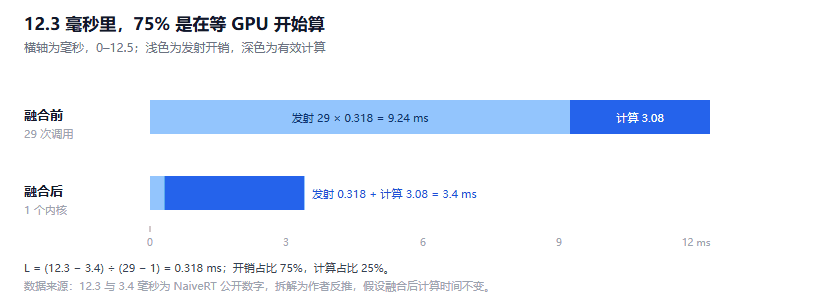
图 1:融合前后的耗时构成,浅色为发射开销,深色为有效计算
launch 开销花在哪
GPU 的每次内核发射(launch)不是免费的,它要过几道固定流程:
- 驱动层把内核参数打包传下去
- 分配寄存器和共享内存
- 在流上排队,等前面的任务收尾
- 硬件调度器把线程块铺到 SM 上
这些流程跟内核里有多少计算无关。一个只算 0.1 毫秒的小内核,发射成本照样是 0.3 毫秒量级,开销和计算量的比例,取决于你的内核有多小。
解码恰恰是"内核很小"的典型场景。每生成一个 token,要走几十层的矩阵乘,每层拆成好几个小操作,每个操作的耗时都在几十到几百微秒。计算小、调用多,发射开销就压不住了。
这就是为什么推理引擎这两年都在做同一件事:算子融合、CUDA Graph、连续批处理。所有这些技术的名字不同,干的都是同一件事,减少发射次数。
在 Python 里做同一个实验:只省 2%
我用 Python 写了个对照实验:29 个小函数各算一段,对比"逐个调用"和"合并调度"。
29 次独立调用: 1.15 ms
1 次融合调度 : 1.12 ms   省 2.1%
29 次空调用(纯调度开销): 0.003 ms,占独立调用的 0.3%
几乎没省。
原因很直白:Python 的函数调用开销是微秒级(约 0.1 微秒),而每个函数的计算是几十微秒。开销占 0.3%,融合了也白搭。
同一个"融合"动作,在 GPU 上省 75%,在 Python 里省 2%。差别不在技术,在开销和计算的比值。
这条对做优化的人是最重要的一句:先量出你那个场景里固定开销占多少,再决定要不要做融合。占比 0.3% 的事不值得做,占比 75% 的事闭着眼做。
内核融合不是万能的
融合有代价,而且不便宜。
第一是工程成本。151 轮实验、6 天,才换来这一个内核。融合后的内核要处理原来 29 个操作的所有边界情况,代码复杂度上升一个量级。
第二是灵活性。29 个独立算子可以单独替换、单独调参;融成一个之后,动其中任何一处都要重新验证整个内核。
第三是数值一致性。融合会改变累加顺序,结果会有位级差异。对训练 rollout 这不是问题,对需要可复现输出的场景就是问题,上一批写 batch 逐位一致时算过,位级差异会在长序列上放大。
所以融合的正确用法是挑场景:训练采样、批量推理这种"同样的计算重复几百万次"的地方,75% 的节省乘出来是巨额收益;一次性任务别碰。
坑清单
1. 只看到 72.4%,没看到 75%。
报道给的数是"缩短 72.4%",看着不错但没信息量。反推出的 75% 才是可操作的,它告诉你剩下的 25% 里还有多少可挖(答案是:最多再省 3.4 毫秒里的发射部分,已经接近极限)。
2. 反推的前提假设要标清。
我的计算假设融合后计算时间不变。实际上融合内核可能有少量额外开销(寄存器压力、同步),所以 0.318 毫秒这个 L 是上界,真实发射开销可能略低。结论方向不变,数值别外推。
3. 把"每层 29 次"当成常数。
29 是 SGLang 这一版在这个模型上的数字。换了模型、换了实现,这个数会变。要评估自己的场景,先 profile 自己的调用次数。
4. 用 Python 微基准直接推 GPU 结论。
我一开始想用 Python 实验证明"融合很值",结果只省 2%。开销的绝对值差着两个数量级,比例结论完全不能移植。要测谁,就去谁的平台上测。
5. 忽略 151 轮里的失败轮。
6 天 151 轮,平均 34 分钟一轮。这 151 轮里绝大多数是改错了、编译挂了、结果不对。如果你只看到"最后成功了",会低估这件事的难度。
结语
这笔账最有意思的地方是它的来源:两个公开数字,一个减法。
L = (12.3 − 3.4) / (29 − 1) = 0.318 毫秒没有内部数据、没有 profile 工具,就推出"发射开销占 75%"这个结论。当然它建立在"融合后计算时间不变"这个假设上,所以是估算不是测量。
但它给了一个可操作的判断标准:你的系统里,固定开销和有效工作的比值是多少? 比值高,做融合、做批处理、做缓存;比值低,这些优化都不值得做。
上次写权重空间编程是"改最少的参数",这次是"发最少的指令",两个方向在做同一件事:把预算花在有效工作的那一侧。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。