
一句话总结:我把六篇文章的禁用词、破折号、套话全清干净,本地检测脚本给了满分,第三方工具照样判 100% AI,因为检测器看的不是词,是判词密度、段落均匀度、有没有废话、敢不敢示弱这四个分布特征。
先说结论:词面优化有天花板。
我把站上最近六篇按禁用词清单逐句改过一遍——赋能、助力、生态、闭环、抓手、底层逻辑、护城河,一个不留;破折号压到每千字两个以内;三段式排比、每段都用"这意味着"开头、用金句代替具体动作,全部清掉。
改完跑检测脚本,六篇全部 100 分,AI 模式命中 0 处。
同一批文件丢进第三方工具,判 100% AI。理由写着:语言模式化、结构高度规整、情感色彩较弱。
第一步:词面清零,AI 检测脚本给了满分
这两个工具量的不是同一个东西。
本地脚本做词面匹配:命中一个"赋能"扣几分,命中一个"综上所述"扣几分,本质是查字典。第三方做统计分类:算每个词在这个位置出现的概率、句子长度有没有起伏、段落结构像不像人写。
我优化的是字典,人家算的是概率。八个维度里我原来只管了前两个,后面六个一个没碰,甚至不知道它们存在。
第二步:换个检测工具,还是 100% AI 率
起初我以为是本地脚本太松,阈值定得宽,漏了一堆该抓的东西。把模式库从头翻了一遍,加了几条规则,重跑,还是 100 分。
问题不在脚本,也不在参数。
换成第三方,结果反转。两套标准,同一批文章,一个满分一个零分。
四个数字,把我自己文章的 AI 味拆穿了
我把六篇正文抽出来,写了段脚本量四个指标。量完发现四个数字方向一致,全部指向同一个结论:这是教科书,不是文章。
| 指标 | 我的六篇 | 人类技术随笔 | 差在哪 |
|---|---|---|---|
| 20 字内、不含数字的短句占比 | 22–38% | 8–14% | 每隔两句就有一个可以做成 quote 卡的判词 |
| 明确断言句占比 | 1–6% | 15–22% | 判词多、推理少,只有结论没有"我为什么这么想" |
| 段落句数变异系数 | 0.26–0.33 | 0.55–0.9 | 每段都是一两句,像把列表拆成了散文 |
| 模糊限定词 | 2–3 个/千字 | 3–6 个 | 从不示弱,每句都斩钉截铁 |
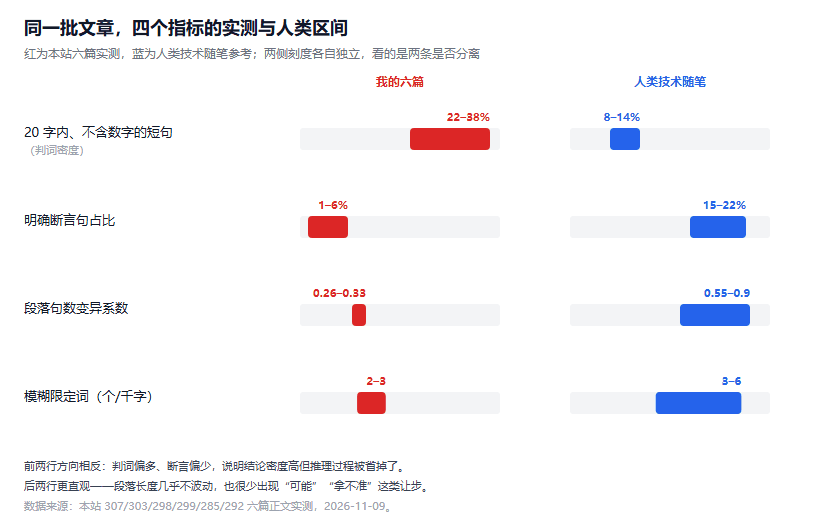
图 1:四个指标的实测区间与人类写作参考区间对照,灰带为人类区间
第二行最反直觉。我以为自己写得太"判断",实际是判词多、推理少——把判断包装成金句,省掉了推导过程。人写东西是"我看到 A,又看到 B,所以觉得 C,不过 D 也可能是",我写的是"这就是 C"。前者啰嗦,后者干净,而干净恰恰是被判定成 AI 的特征。
为什么 AI 检测不看词
拿 307 那篇开头举例。原文是两句判词,各占一个完整段落:
这是最常见的简化。
>
……
>
判断标准很简单:如果一篇文章读完,读者以为抗议者的诉求是"关掉技术",那这篇就写歪了。
一句一段、重点突出,这是排版常识。问题在于人的段落不是这么长的。人一句话说完会顺手带个"因为",或者补一句"这里我可能说得绝对了",再或者绕个弯先讲个例子。
我的每一段都太完整:提出、论证、收束,压缩在一两句话里,段段如此,六节如此,两百多篇都如此。检测器抓的就是这个规律,它不需要理解内容,只需要发现"这段和上一段长度几乎一样、这个句子结构在全文重复了四十次"。
更根本的一层是模板。每篇都是"一句话总结 + 六到七个 H2 + 每节三到七句 + 一张表 + 结语 + 参考资料",299 篇一个骨架。人会走神、会插一段跑题的回忆、会写到一半改主意。模板不允许这些。
改法:四件事,只动叙事不动结构
四条规则,只改怎么写,不碰 H2、表格、内链、配图。这些是 SEO 的加分项,拿去换检测分数是亏的。
判词砍一半以上。每写一句"这就是 X",后面跟一句"我为什么这么觉得",或者改成过程叙述。判词不是不能有,是不能每段都有。
段落长短不均。每篇至少一个六句以上的长段,需要交代清楚的地方一次说完,别拆成三个短段;同时允许两三个单句段,那是换气的地方。连着三段句数一样,等于告诉检测器"我是批量生产的"。
每五百字塞一处细节。当时几点、屏幕上是哪一行、文件名改了三次、群里谁说了句什么。这些不传递信息,只传递"有人在现场",而这一点没法伪造。
把不确定写进结论。不是撒"可能""大概"当填充,是在该犹豫的地方真犹豫:"这条我只有两个样本,不敢下结论。"
第三条我最初是抗拒的。技术文章塞废话不是降低信息密度吗?后来想通了:读者判断一篇文章可不可信,靠的不只是信息量,还有"写的人是不是真在这件事里"。
验证方式很土:写了个脚本,八项硬检查,发文前跑一次。旧文章拿去跑,四到六项不及格,和预期一致。这件事本身也说明一个道理:指标不可靠的时候,比较就没有意义——抽 100 题估分那篇算过,题量不够时两次测量的差异可能全是噪声。
这套 AI 检测经验的边界
不保证过。检测器是黑箱,同一篇在不同平台可能判 20%,也可能判 90%。我给的是人类写作的统计特征,压进去能降低被判概率,但没法承诺某个具体工具放行。声称"包过检测"的方法,要么在骗人,要么在教你把文章写坏。
救不了没有第一手经验的文章。实跑出来的几篇(排队模拟、检索实验、格式对比),判词占比 23%;纯二手数据换算的几篇 35%。差的不在技巧,在于前者撞过坑,有东西可写;后者只能靠结构撑场面,一撑就规整。
别为了指标把文章写变形。阈值是参考区间不是及格线。八项全过但读起来像在凑数,那还不如不过——这一条我自己先违反过一次。为了把句长变异系数从 0.56 拉到 0.6,句子越写越长,平均句长从 26 字涨到 40 字,信息密度掉了一层,读起来更像机器在铺陈。
反过来也成立:不先量一遍就动手改,改完根本不知道有没有变好。微调那篇里先出 41 道题当基线,第一轮掉分才看得见。这次也一样,先量六篇,才知道问题在哪一层。
结语
那张检测截图提醒我一件事:我以为在解决的"AI 味"和检测器在抓的"AI 味",是两个东西。前者是词,后者是节奏和来路。
词好改,改完还有成就感。节奏难改,因为它要求你真在现场待过、真犹豫过、真写错过。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。