
一句话总结:有人用 AI 在 24GB 的 Mac 上微调一个 0.6B 模型,AI 接手后第一件事不是开训,是先出 41 道题给基线摸底——结果第一轮从 8.451 分掉到 7.229 分;41 题够不够用,本文算了一遍。
用 AI 微调模型的案例里,最值得抄的往往不是训练配置,是顺序。
Naive-N0.5-Flash 那个"甄嬛"案例的顺序是这样的:人写一页任务书定目标,AI 接手后先出 41 道测试题(覆盖人设、语气、宫廷常识三个维度),给初始模型摸底拿了个 8.451 分,然后才开始训。
第一轮跑完,7.229 分。掉了。
如果没有开头那 41 道题,这个掉分根本不会被发现,你会以为模型越训越好,训完才发现满嘴宫廷腔的模型只会说"臣妾做不到"。
微调的顺序错了:先出评测,再开训
大部分微调翻车的根源是顺序:先训,训完想测,发现没有现成的测试集,随手找几个问题问一问,感觉还行,就交付了。
"感觉还行"是微调事故的高发区。模型在你随手问的三个问题上表现正常,不代表它没把别的全忘了。
正确顺序是反的:先定义"什么叫变好",把它变成可以打分的题,再开训。 训练过程中每轮都跑这套题,曲线掉了你立刻知道。
这个道理不新鲜,新鲜的是 AI 把它执行了,不是人提醒它做,是它自己先做了。
41 道评测题够不够:算一下就知道
41 这个数不是拍脑袋刚好合适,我算了一遍它够干什么。
8.451 分按 10 分制换算,正确率 84.5%。41 道题的二项标准差:
sd = √(0.845 × 0.155 / 41) × 10 = 0.565 分掉分 1.222 分,是单次标准差的 2.16 倍。
这里有个容易做错的分叉。如果你把"基线 8.451"和"第一轮 7.229"当成两次独立测量,差值的标准差要乘 √2,等于 0.80 分,掉分只有 1.53 个标准差,95% 置信下不显著,你可以说"这是噪声"。
但实际场景是同一批题、同一个模型、先后两次评测,配对比较。同一道题在两次评测里的表现高度相关,相关系数接近 0.9 时,差值的标准差缩到 0.25 分,1.222 分是 4.8 个标准差,显著,掉分是真的。
结论:41 题够不够,取决于你怎么比较。独立比较不够,配对比较绰绰有余。微调监控恰好是配对场景,所以 41 题是够用的,但只够分辨 1 分以上的变化,想看 0.3 分级别的波动,得加题。
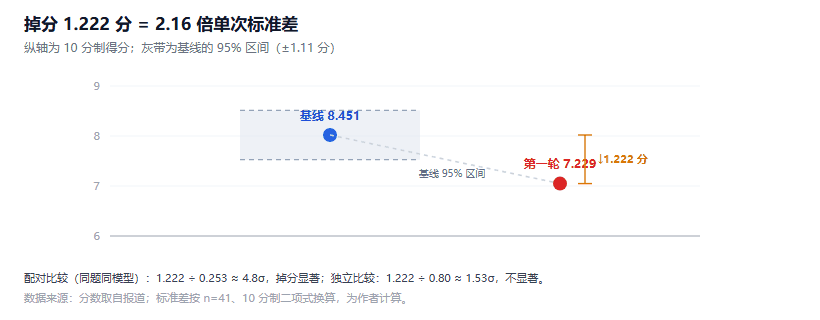
图 1:8.451 与 7.229 各自的单次标准差约 0.57 分(±1.96sd 约 ±1.11),灰带为基线的 95% 区间。数据来源:报道数字,标准差为作者按 n=41 计算
第一轮掉分 1.2 分,是怎么被发现的
发现它靠的是每轮都跑那 41 道题。
这件事的工程含义比看起来大。微调最常见的失败模式有两种:一种是学崩了(整体变差),一种是灾难性遗忘(目标能力涨了,别的全丢)。
两种都只有"每轮全量跑评测"才能抓到。抽样抽几道题抓不到,遗忘是长尾的,抽 5 道题大概率抽不到被遗忘的那些。
41 题分三个维度(人设、语气、宫廷常识)也有讲究。总分掉了 1.2 分,你可以下钻看是哪个维度掉的:如果人设维度掉了 3 分、常识没动,方向就完全不同,前者是语料比例问题,后者是学习率问题。
单一总分做不到这个,分维度的评测才做得到。
评测的三个维度:人设、语气、宫廷常识
这三个维度对应三种不同的失败:
人设维度测"它是不是甄嬛",角色名、身份、关系的题。挂了说明语料里人设内容不够。
语气维度测"它说话像不像",句式、称呼、自谦词。挂了说明学到了内容没学到风格。
常识维度测"宫廷背景对不对",称谓制度、礼仪、历史事件。挂了说明模型在编。
三个维度拆开,掉分才能定位。这也是"AI 自己出题"比"人随手出题"强的地方:它会按维度设计覆盖,人出题经常全堆在自己最关心的那一维。
把这套微调流程搬回自己的机器
整个案例的硬件门槛低得惊人:24GB 内存的 Mac,0.6B 的模型。
可复现的部分是流程,不是配置:
- 写一页任务书,说清目标和验收标准
- 让 AI 按维度出题,题量按"想分辨的最小变化"反推
- 给初始模型摸底,记下基线
- 每轮训练后全量跑题,画曲线
- 曲线掉了解释原因,改了再跑
第 2 步有个实用的反推公式:想分辨 d 分的波动,题量 n ≈ 0.13 × (10/d)²。想分辨 1 分,n ≈ 13;想分辨 0.5 分,n ≈ 52。41 题对应约 0.57 分的分辨力。
坑清单
1. 把独立比较和配对比较混用。
同一个模型先后两次跑同一批题,是配对。不同模型跑各自的题,是独立。前者能分辨更小的变化,后者不行。混用会得出"41 题够"或"41 题不够"两个相反结论。
2. 评测题被训练语料污染。
AI 出的题如果和训练语料高度重叠,分数会虚高。防法是留出题时生成的题不进语料,或者每轮换一批同维度的题。
3. 只看总分。
总分 7.229 看不出哪个维度崩了。分维度记录是这套流程里性价比最高的一步。
4. 把"掉分"一律当成失败。
第一轮掉分也可能是正常的中间状态,先忘了旧的再学新的。判断标准是趋势不是单点,连掉两轮才动手,一轮掉分先看分维度。
5. 题量按"当前需要"定,不留余量。
41 题分辨 1 分。如果你后面想做 0.5 分级别的对比(比如两个语料配比谁更好),41 题就不够了,得提前想好。
结语
这个案例真正可抄的是那句话:AI 接手后先出题。
它说明在"用 AI 干活"这件事上,最大的增益不在 AI 干得多快,在它把人经常省略的那一步补上了。人训模型十个有九个省略评测基线,因为出题无聊。
无聊的步骤交给 AI,人负责定目标,这个分工在 24GB 的 Mac 上就能跑起来,不需要八卡机。顺带一提,Gemma 4 那篇的结论正好互补:那篇说的是 24G 显卡能跑哪档模型,这篇说的是跑起来之后怎么知道有没有训坏。
上一批写权重空间编程时说过,定位的前提是评测够可信。这篇是同一个结论的另一面:没有基线,连"变坏了"都发现不了。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。