
一句话总结:在一个 76,296 参数的小网络里改同样数量的 12 个权重——清零最关键的 12 个,准确率掉 1.97 个点;随机清零 12 个,只掉 0.02 个点;位置对但方向错,掉 9.12 个点。权重的价值不在数量,在坐标。
MIT 那篇权重空间编程的博客这两天刷屏了:GPT-6 Astra 自己写 Python 脚本,只改了一个 0.8B 小模型里 0.016% 的权重,治好了它的复读死循环,数学成绩涨了 6 倍。
很快有人扒出它并不是凭空"心算"权重,本质还是写代码修 bug。
扒得对。但"写代码改权重"这个动作本身值得算一笔账:改这么少的权重,为什么能有这么大影响?
我造了个小网络,把这件事量化了一遍。
权重空间编程在做什么
常规修模型有两条路:重新训练(改所有权重,成本高),或者微调(改一部分,但还是批量改)。
权重空间编程是第三条:像改代码一样,指着具体的某个权重说"把它改成这个值"。改动是外科手术式的,一次十几个、几十个,不是几百万个。
它和"改提示词、改上下文"的区别在于改动是永久的,写进权重里,不随会话消失。
MIT 那个例子的价值不在"AI 会改权重",在于它证明了模型的行为可以由极少数权重决定。这件事可以量化,我就造了个实验场。
权重实验场:7.6 万参数的小网络
结构:两层 256 隐藏单元的 MLP,输入 32 维、输出 8 类,总共 76,296 个参数。
0.016% 就是 12 个权重。
训练到 79.85% 的准确率,然后做三组实验,每组都只动 12 个参数:
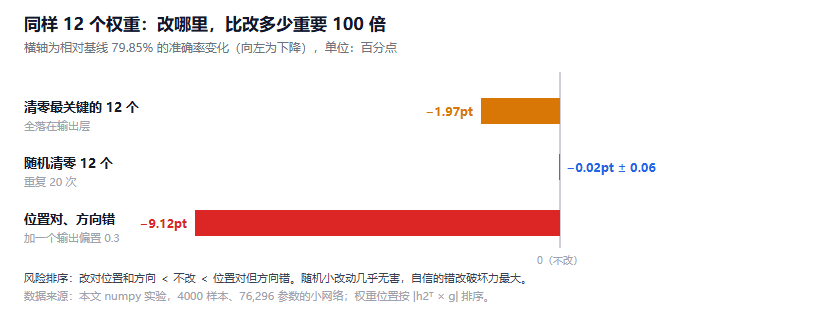
图 1:横轴为相对基线 79.85% 的准确率变化,向左为下降。数据来源:本文 numpy 实验
| 改法 | 准确率 | 变化 |
|---|---|---|
| 清零梯度最大的 12 个权重 | 77.88% | −1.97pt |
| 随机清零 12 个(20 次平均) | 79.83% | −0.02pt |
| 只加一个输出偏置 0.3 | 70.73% | −9.12pt |
改 12 个权重:位置差出 100 倍
第一组和第二组是同一个动作、同一个数量,只差"改哪里"。
梯度最大的那 12 个,全落在输出层,我按 |h2ᵀ × g| 找的,它们正好是"决定答案"的那批。清零后掉 1.97 个点。
随机选 12 个,重复 20 次,平均只掉 0.02 个点,标准差 0.06。也就是说大部分随机权重动了跟没动一样。
同样 12 个权重,位置不同,影响差了 100 倍。
这就是"0.016% 能修好模型"的数学基础:参数不是均匀重要的,极少数权重承载了极大部分的行为。找到了它们,手术刀就够用;找不到,砍一万刀也没事发生。
方向错了比不改更糟
第三组更有意思。
我加了一个输出偏置,位置"对"(在输出层,影响所有判断),但方向和幅度是我拍的。结果掉 9.12 个点,是第一组的 4.6 倍。
也就是说,权重修改的风险排序是:改对位置和方向 < 不改 < 位置对但方向错。
随机小改动几乎是安全的(有海量参数稀释),但一个自信的"精准修复"如果方向错了,破坏力最大。
这解释了为什么 GPT-6 Astra 那个案例要写 Python 脚本排查诊断,它改之前先跑了一套验证。权重修改本身是五分钟的事,验证才是主要工作量。
权重空间编程和微调的区别
| 维度 | 微调 | 权重空间编程 |
|---|---|---|
| 改动数量 | 百万到亿级 | 几个到几十个 |
| 需要什么 | 训练数据 + 显卡 | 诊断 + 定位 |
| 风险 | 灾难性遗忘 | 定位错则无效,方向错则更糟 |
| 适合 | 教模型新能力 | 修模型的特定毛病 |
两者不互相替代。微调教"会",权重手术修"错"。
后者目前最大的瓶颈是诊断:你得先知道毛病出在哪几个权重上。而定位的前提是有足够可信的评测,抽样误差那篇算过,评测题量不够,连"有没有变好"都判断不了。MIT 案例里这一步是 GPT-6 Astra 写脚本做的,而脚本方法依赖能复现的评测,有评测才有梯度,有梯度才有定位。
坑清单
1. 76,296 参数上算"0.016%",算出来是 12 个,先确认这个数是不是整数 1。
参数量小的时候,0.016% 可能不足 1 个权重。这种情况下"百分比"和"绝对数量"要分开说,否则结论没法对比。
2. 梯度大的权重不一定全在输出层。
我的实验里 12 个最关键权重恰好都落在输出层,因为这是个浅层玩具。深层网络里关键权重会散布在各层,只扫输出层会漏。
3. 随机对照的次数太少会误判。
随机清零的标准差是 0.06pt,我跑了 20 次。如果只跑 3 次,很可能碰巧拿到一个 -0.15pt 的样本,得出"随机改动也有影响"的错误结论。
4. 别把玩具结论外推到 0.8B。
0.8B 模型有 8 亿参数,0.016% 是 12.8 万个权重。它的"复读死循环"大概率不是 12 个权重能描述的现象,那个案例的可信部分是"AI 能自己写诊断脚本",不是"12 个权重包治百病"。
5. "数学成绩涨 6 倍"要看基线。
如果基线是 5 分、满分 100,涨到 30 分很惊人;如果基线是 2 分、满分 10,涨 6 倍就是 12 分封顶。倍数在低基线上最容易骗人。
结语
这组实验最干净的结论是那个 100 倍:同样数量的权重改动,位置决定的不是快慢,是有没有效。
它给"AI 修模型"这件事指了个方向,难点从来不是改,是找。上一批写 BestRand 时算过评测的信噪比,那篇说的是"分辨差距需要多少题";这篇是同一件事的镜像:没有足够好的评测,你连该改哪个权重都找不到。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。