
一句话总结:120 行商品数据,用缩进 JSON 是 4449 个 token,换成紧凑 JSON 省 28%,换成 CSV 省 54%,再裁掉三个字段省到 647 个 token——同一份数据,最贵和最省的写法差 6.9 倍。
给模型喂结构化数据的人都有个盲区:只关心"喂什么",不关心"怎么喂"。
同一份数据,写法的差别能到 6.9 倍。这个倍数比大多数模型优化的收益都大,但几乎没人算。
120 行数据的六种格式
数据是 120 行商品记录,每行 6 个字段:id、sku、name、price、stock、updated。
六种写法,同样的内容:
| 格式 | 字符数 | 估算 token | 相对紧凑 JSON |
|---|---|---|---|
| JSON 缩进(indent=2) | 16,381 | 4,449 | 144% |
| JSON 紧凑 | 11,340 | 3,189 | 100% |
| JSONL(每行一条) | 11,338 | 3,188 | 100% |
| CSV 带表头 | 5,252 | 1,667 | 46% |
| TSV 无表头 | 5,098 | 1,628 | 45% |
| 字段裁剪数组 | 2,588 | 647 | 23% |
token 数是估算的:中文按 1 字符 1 token,ASCII 按 4 字符 1 token。绝对值会有偏差,比值可靠。
JSON 缩进比紧凑多 44% 的 token
第一行和第二行差在缩进和换行。
json.dumps(..., indent=2) 每层缩进两个空格,每个键值对占一行。这份数据 120 条 × 6 字段,缩进和换行贡献了 5000 多个字符。
这些字符不携带任何信息,但模型要一个一个读进去,按 token 计费。
调试时用缩进没问题,进 prompt 时应该用 separators=(",", ":")。一行代码,省 28%。
换成 CSV 省一半 token
JSON 的第二个成本是键名重复。
120 条记录,每条都要写一遍 "sku":、"price":、"stock":。6 个键名 × 120 条 = 720 次重复。
CSV 只在表头写一次,后面全是值。这一下就从 3189 掉到 1667。
再狠一点:TSV 去掉逗号周围的引号,掉到 1628。差的这 39 个 token 全是引号。
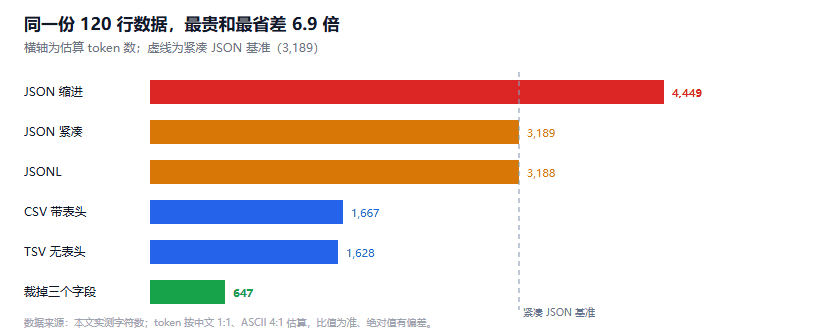
图 1:横轴为估算 token 数,虚线为紧凑 JSON 的基准
这也解释了为什么很多团队在做 agent 时用 YAML 或 Markdown 表格:本质都是在减少重复的键名和标点。
格式选择的顺序:先删字段,再换格式
最后一行才是最大的杠杆。
id、name、updated 三个字段对这次任务没用,删掉之后只留 sku、price、stock,token 从 1628 掉到 647。
这个顺序很重要:
- 先删字段:23% 是靠删字段拿到的,换格式只到 46%
- 再换格式:CSV/TSV 比 JSON 省一半
- 最后压标点:紧凑写法再省一点
很多人反过来做,先纠结用 JSON 还是 YAML,花了一下午,省了 5%。而删掉三个没用的字段是五分钟的事。
判断字段有没有用,问一句:这个任务需要它吗?做价格比较不需要商品 ID,做去重才需要。字段的价值取决于任务,不是数据本身。
坑清单
1. 用字符数估 token。
中文和英文的比值完全不同。我用"中文 1:1、ASCII 4:1"是粗估,真实分词器对数字和符号的处理差异很大。要精确就上对应模型的分词器。
2. CSV 丢了类型。
JSON 里 price: 129.0 是数字,CSV 里是字符串 "129.0"。有些模型会因此算错。要在表头或 prompt 里声明类型。
3. 字段顺序影响不大,但键名重复影响很大。
别在字段顺序上浪费时间。要动就动"重复"这件事。
4. 忘了输出格式的成本。
输入省了一半,但如果要求模型输出 JSON,输出侧的 token 一点没省。输出通常比输入贵 3 倍,这一侧更值得优化。
5. 裁字段裁过头。
删掉 updated 之后,如果后面需要按时间过滤,就得重新取一遍数据。裁字段前先想清楚下游要什么。
结语
这组数据最反直觉的一点:最大的节省来自"少给",不是"换个写法"。
从 4449 到 647,其中"删字段"贡献了 60% 的降幅,"换格式"贡献了 35%,"压标点"只贡献 5%。
做上下文优化的人都盯着模型和检索,其实第一笔账在序列化这一层。上周算过 24.6GW 的电,那是宏观的账;这一篇是微观的账,而微观的账你能立刻改。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。