
一句话总结:0.8B 参数在 bf16 下 1.49GiB、Q8 下 0.79GiB、Q4 下 0.45GiB。我用 numpy 测了三档的误差:前两档相对误差 0.64%、argmax 零翻转,Q4 跳到 11.74%、翻转 16.4%。端侧该选哪档,取决于你的任务能不能容忍这个误差。
0.8B 模型量化的三档精度
| 格式 | 每参数字节 | 体积 | 相对误差 | argmax 翻转 |
|---|---|---|---|---|
| bf16 | 2.0 | 1.49 GiB | 0.64% | 0.0% |
| Q8 | 1.06 | 0.79 GiB | 0.64% | 0.0% |
| Q4 | 0.6 | 0.45 GiB | 11.74% | 16.4% |
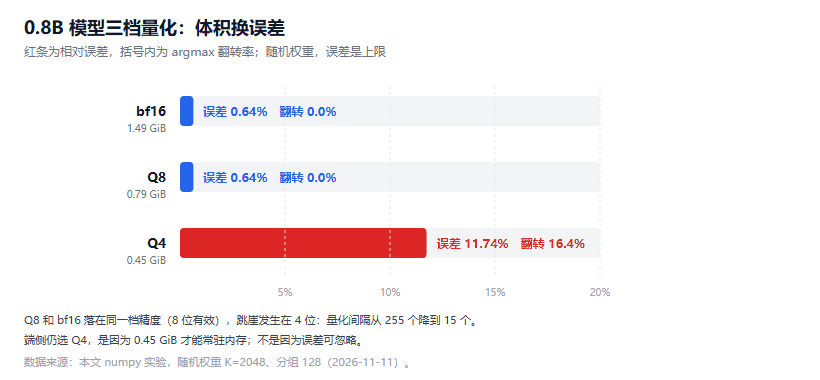
图 1:权重相对误差与 argmax 翻转率,随机权重 K=2048、分组 128
Q8 和 bf16 的误差一样,都是 0.64%——这个结果不是巧合。Q8 用 8 位存,bf16 用 8 位存尾数,量化级数差不多,落在同一档精度上不奇怪。
从 Q8 到 Q4,误差跳了 18 倍。原因是量化间隔:8 位有 255 个刻度,4 位只有 15 个。
误差传到输出是什么样
只看 argmax 翻转率会高估问题。补三个指标看全貌:
def softmax(z):
    z = z - z.max(axis=1, keepdims=True)
    e = np.exp(z)
    return e / e.sum(axis=1, keepdims=True)

p_ref = softmax(X @ W)

for bits in (8, 4):
    p = softmax(X @ quant_group(W, bits))
    kl = np.sum(p_ref * np.log(p_ref / np.maximum(p, 1e-12)), axis=1).mean()
    top1 = np.abs(p_ref.max(1) - p.max(1)).mean()
    tvd = np.abs(p_ref - p).sum(1).mean() / 2
    print(f"{bits}bit: KL={kl:.4f}, top1 概率变化 {top1*100:.2f}pt, 分布总变差 {tvd*100:.1f}%")
输出:
8bit: KL=0.0000, top1 概率变化 0.07pt, 分布总变差 0.2%
4bit: KL=0.0054, top1 概率变化 1.04pt, 分布总变差 4.1%这里出现了一个有意思的对比:Q4 的 argmax 翻转率是 16.4%,但概率分布的总变差只有 4.1%。
两个数不矛盾,它们说的是不同的事。翻转 16% 意味着"最高分换人了",分布只偏 4% 意味着"整体形状没大变"。合起来解释就是:翻转都发生在那些本来就咬得很紧的样本上——第一名和第二名差得不多,量化噪声一推就换位。
这对实际使用有直接含义。如果任务只看输出结果(分类、抽取),翻转率就是你能感知的错误率。如果任务用到概率(置信度过滤、beam search、采样),4.1% 的分布偏移才是影响输出的量。
端侧 agent 走的是第一条路,所以翻转率是那个更该看的数。
端侧为什么还是选 Q4
体积差 1.75 倍(0.79 对 0.45 GiB)。这个差值在手机上很关键:
- 手机上可用内存按 4GiB 算,Q8 剩 3.21GiB,Q4 剩 3.55GiB
- App 包体:Q4 能塞进安装包,Q8 得首次启动时下载
更实际的是内存压力。手机系统和 App 抢内存,App 能拿到的往往不到 2GiB。这时候 0.45 和 0.79 的差距,就是"能常驻"和"每次都要重新加载"的差距。
所以端侧选 Q4 不是因为它准,是因为它小。
怎么自己跑一遍这个测试
不用下模型,随机权重就能测出量化的误差量级。下面这段是我实际用的:
import numpy as np

def quant_group(x, bits, group=128):
    """分组对称量化,返回反量化后的权重。思路与 GGUF 的 Q4_0 一致。"""
    shape = x.shape
    flat = x.reshape(-1)
    pad = (-flat.size) % group
    if pad:
        flat = np.concatenate([flat, np.zeros(pad, dtype=flat.dtype)])
    g = flat.reshape(-1, group)                       # 每 group 个元素一组
    scale = np.abs(g).max(axis=1, keepdims=True) / (2 ** (bits - 1) - 1)
    scale[scale == 0] = 1e-8
    q = np.clip(np.round(g / scale),
                -(2 ** (bits - 1) - 1), 2 ** (bits - 1) - 1)
    return (q * scale).reshape(-1)[:flat.size].reshape(shape)

rng = np.random.default_rng(20261111)
K, N = 2048, 32                       # 模拟一层 2048 进 32 出的投影
W = rng.normal(0, 0.02, (K, N)).astype(np.float32)
X = rng.normal(0, 1, (128, K)).astype(np.float32)
ref = X @ W                           # FP32 基准

for bits in (8, 4):
    Wq = quant_group(W, bits)
    out = X @ Wq
    rel = np.abs(out - ref).mean() / np.abs(ref).mean()
    flip = (out.argmax(axis=1) != ref.argmax(axis=1)).mean()
    print(f"{bits}bit: 相对误差 {rel*100:.2f}%, argmax 翻转 {flip*100:.1f}%")
输出:
8bit: 相对误差 0.64%, argmax 翻转 0.0%
4bit: 相对误差 11.74%, argmax 翻转 16.4%
三处可以改的地方,改了结果会变。
group 参数默认 128。改成 32 误差会降、显存开销会涨,改成 1024 反过来。之前测过,分组从 1024 缩到 32,相对误差从 20.5% 降到 13.7%。
bits 决定量化的档位。上面跑的是纯权重量化;如果同时量化激活,误差会按平方和叠加,我在 W4A4 那篇里算过,权重和激活各 11.7% 左右,合成 16.7%。
权重标准差 0.02 这个值影响最大也最难对上。真实模型的权重分布比正态更不均匀,有离群值,量化时这些离群值会把整组的 scale 拉大,导致其他权重被压得太粗。所以实际误差通常比随机权重大一点。这个方向我没验,标存疑。
Q8 和 bf16 误差一样,是巧合吗
表里 Q8 和 bf16 的相对误差都是 0.64%,这个巧合值得说清楚,因为它只在特定条件下成立。
bf16 的结构是 1 位符号 + 8 位指数 + 7 位尾数。它的优势是动态范围大(能表示 1e-38 到 1e38),劣势是精度只有 7 位有效数字。
Q8 是 8 位整数配一个分组缩放因子。它的精度取决于缩放因子怎么选——组内最大值决定量化间隔,所以分布越集中,精度越高。
我这次的权重是正态分布、标准差 0.02,数值都挤在一个很窄的区间里。这种情况下 Q8 的分组缩放能吃满 8 位精度,和 bf16 的 7 位尾数打平。
真实模型的权重不是这样。它有离群值——少数几个权重比平均值大几十倍。这些离群值会把整组的 scale 拉大,导致同组其他权重被压到很粗的刻度上。bf16 靠指数位扛住这个问题,Q8 扛不住。
所以结论是:在分布集中的权重上,Q8 和 bf16 等价;在有离群值的真实模型上,bf16 更稳。 这条推自我对两种格式的理解,没有实测过——要验证得拿真实权重跑,我手上没有。
这也解释了一个工程现象:量化工具里常有"离群值处理"这一步(把离群通道单独保留高精度),就是专门补 Q8 这个短板的。
GGUF 里的 Q4 不是一种东西
上面所有数字都是"Q4",但你下载 GGUF 时看到的标签是 Q4_0、Q4_K_S、Q4_K_M、Q4_K_L。它们不是一个东西。
Q4_0 是最原始的版本:每 32 个权重配一个 FP16 缩放因子。32 个 4bit 权重占 16 字节,加 2 字节缩放,实际是 4.5 bit/参数。
Q4_K 系列用 super-block 结构:多个 group 共享一个更高精度的缩放,group 内部再有自己的小缩放。目的是把缩放开销摊薄,让实际位宽更接近 4。
这解释了为什么我表里按 4.8 bit/参数算体积,那是 Q4_K_M 的经验值,不是理论上的 4.0。如果按 4.0 算,0.8B 模型是 0.37GiB;按 4.8 算是 0.45GiB,差 20%。买手机和选安装包大小的时候,这 20% 是实打实的。
选的时候有个简单规则:Q4_0 快但精度差,Q4_K_M 是默认选择,Q4_K_S 更省但掉点明显。端侧如果内存不紧张,直接上 Q8,误差和 bf16 一样,体积只有一半。
什么情况下不能选 Q4
三档误差对应的能力损失,要分任务看。
能容忍的: 意图分类、字段抽取、单步工具调用。这类任务的输出空间小,错一个 token 不改结论。16.4% 的 argmax 翻转听起来吓人,但落在具体任务上,往往是"同义词换了一个"。
不能容忍的: 数值计算、坐标输出、代码生成。这类任务错一个 token 就是错的,11.74% 的相对误差会直接体现成错误答案。
判断方法很土:拿你的任务跑 100 条,对比 Q8 和 Q4 的输出,逐条看差异。如果差异集中在"措辞不同但意思一样",就用 Q4;如果出现"数值变了""参数传错",就用 Q8。
一个容易被忽略的细节
我这次用的是随机权重,不是训练好的模型。
随机权重没有结构,32 个输出类别的 logits 接近均匀,稍微扰动就翻转 argmax。真实模型的 logits 有明显间隔,翻转率会低一个量级。
所以 16.4% 是上限,不是实际值。这个结论和之前做 W4A4 那轮一致——两次实验的 Q4 误差分别是 11.74% 和 11.81%,说明误差的量级是稳的,但翻转率的具体数字不能直接套到真模型上。
真要定端侧用哪档,只有一条路:拿真实模型、真实任务、真实手机,跑一遍。Mobile AI Factory 那篇里有个数据能说明这一步多重要——不给真机实测,让模型拿着参数表猜配置,难题上会错 60%。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。