
一句话总结:Tether 的 BotPsy 基于 Qwen3.5-0.8B 微调,六个 agent 基准里五个赢过 2.5 倍大的模型,但绝对值要看清——指令遵循涨到 90.8 分,工具调用只到 44.0,意味着一半以上的函数调用还是会错。
11 月 11 日发布,Apache 2.0(研究和教育用途),bf16 / Q8 / Q4 三种格式,safetensors 和 GGUF 都有。
BotPsy 0.8B 在手机上是什么概念
0.8B 参数按三种精度存:
| 格式 | 体积 | 手机剩 4GiB 时的余量 |
|---|---|---|
| bf16 | 1.49 GiB | 2.51 GiB |
| Q8 | 0.79 GiB | 3.21 GiB |
| Q4 | 0.45 GiB | 3.55 GiB |
Q4 只要 450MB 左右,比一张照片大点有限。这个体积才能塞进 App 里,不用联网。
六个基准:指令遵循 90.8,工具调用 44.0
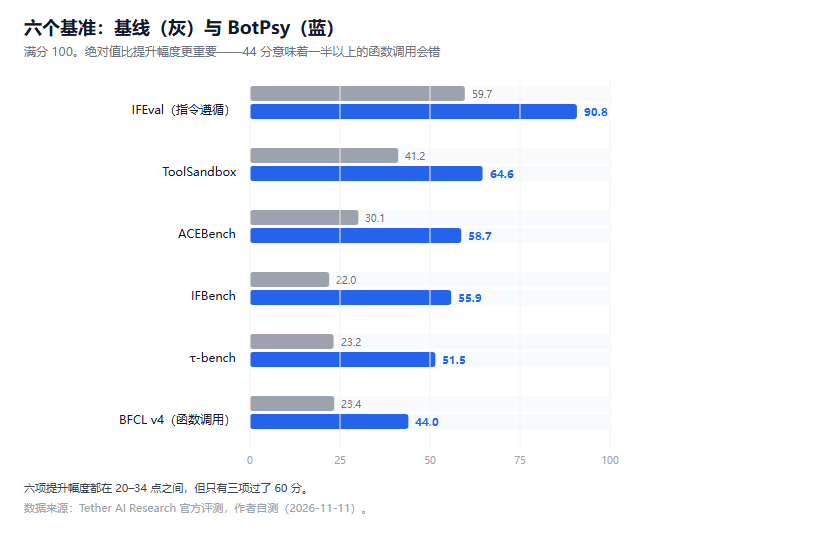
图 1:每个基准两行,灰条为基线 Qwen3.5-0.8B,蓝条为 BotPsy
| 基准 | 基线 | BotPsy | 绝对提升 |
|---|---|---|---|
| IFEval(指令遵循) | 59.7 | 90.8 | +31.1 |
| ToolSandbox | 41.2 | 64.6 | +23.4 |
| ACEBench | 30.1 | 58.7 | +28.6 |
| IFBench | 22.0 | 55.9 | +33.9 |
| τ-bench | 23.2 | 51.5 | +28.3 |
| BFCL v4(函数调用) | 23.4 | 44.0 | +20.6 |
提升幅度都在 20 到 34 个点之间,看着很猛。但拉回绝对值看,六项里只有三项过了 60 分。
IFEval 到 90.8 说明"按指令做格式"这类活它能干得很好——让输出 JSON 就输出 JSON,让分三步就分三步。
BFCL v4 只有 44.0,这是个需要正视的数。这个基准测的是"给定函数签名和用户请求,能不能正确调对"。44 分意味着一半以上的调用是错的——调错函数、传错参数、或者干脆不调。
训练四阶段:SFT 掉了什么
训练顺序是:监督微调 → 多教师蒸馏 → 两轮 DAPO 强化学习。
官方说了一件很实在的事:监督微调提升了工具使用,但把知识和指令遵循压到了基线以下。蒸馏才把这两项拉回来。
这个现象在 多教师蒸馏那套机制里能找到解释:SFT 的数据集中在工具调用上,梯度全往一个方向推,其他能力的梯度被覆盖掉了。
三个教师各管一摊:工具调用、通用推理、指令遵循。蒸馏阶段用学生自己生成的序列,由三个教师分别打分。这样每种能力的信号分开传,不会互相抵消。
强化学习用的是 DAPO,奖励设计有个细节:工具调用给部分分——工具名对、参数名对、参数值对,各拿一部分。不是全对才给分。
这个设计对 0.8B 这种小模型很关键。二值奖励(对或错)在能力弱的时候几乎全是 0,梯度信号稀疏到学不动。部分给分等于给了一条爬坡的路径。
六个基准各自测什么
分数摆在一起容易被误读,这六个基准测的是不同的事:
BFCL v4 测函数调用。给模型一组函数签名和一句用户请求,看它能不能挑对函数、填对参数。这是工具调用的地基,44.0 分意味着一半以上的调用有错。
τ-bench 测多轮对话里的工具使用。用户的需求是渐进透露的,模型要在对话中逐步调用工具完成任务,还要遵守业务规则。23.2 涨到 51.5,翻了一倍多,但绝对值刚过半。
ToolSandbox 测带状态的多步工具调用,工具之间有依赖关系。这个基准基线就有 41.2,说明它相对容易。
ACEBench 测 agent 的综合能力,涵盖工具选择、参数填充、结果解读。
IFEval 和 IFBench 测指令遵循,不是工具调用。前者测"输出格式是否严格按要求",后者测"在长指令、多约束下的遵循程度"。这两个涨得最猛(90.8 和 55.9),说明训练里对格式的投入很重。
把这六项放一起看,能读出一个取舍:这个模型把能力押在了"听话"上,不是"会办事"上。 IFEval 90.8 说明它格式执行力极强,BFCL 44.0 说明它工具调用的准确率还不够。做端侧产品的时候,这个取舍决定了它能接什么活。
红队数据比分数更值得看
官方公布了两组安全数据:
| 指标 | 基线 | BotPsy |
|---|---|---|
| 六类危害的不安全响应率 | 36% | 21% |
| 提示注入下的不安全率 | 46% | 31% |
21% 的不安全率听起来很高——五次里有一次不安全。但基线是 36%,说明微调确实降低了这个比例,只是没解决。
提示注入那组更能说明问题:46% 降到 31%,剩下三成。端侧 agent 会读取工具返回的内容(网页、文件、消息),如果这些内容里藏了指令,模型可能照做。这条风险对本地 agent 尤其重要,因为它能接触到设备上的真实数据。
31% 意味着:不能把端侧 agent 直接暴露在不可信输入上。 要么在工具层做过滤,要么把高危操作留给人确认。
官方也承认了这些限制:不适合高风险场景、知识主要随参数量增长、指令累积时性能下降、低资源语言弱。这几条不是免责声明,是选型依据——写清楚边界的模型,比号称"什么都能干"的更容易用对。
端侧模型为什么要少推理 token
官方公布了一个容易被忽略的数字:GPQA Diamond 上,五个模型都答对的题里,BotPsy 用了 3690 个推理 token,基线用了 11563。
差了 3.1 倍。这在云端无所谓,在手机上是生死线。
按手机端 20 tok/s 的生成速度算,3690 token 要 184 秒,11563 token 要 578 秒——差 6 分半钟。用户不会为一个查询等 9 分钟。
重复推理循环也降了:IFBench 上从 22.9% 降到 1.4%。小模型有个典型毛病是绕不出来,同一句话换个说法反复念。这个数降下来,端侧体验的改善比分数提升更明显。
工具调用 44 分能干什么
| 场景 | 适不适合 |
|---|---|
| 设闹钟、发消息、查天气 | 适合。参数简单,错了用户立刻发现 |
| 日历增删改、本地文件操作 | 边界。参数复杂,错了有副作用 |
| 下单付款、改账户设置 | 不适合。错一次代价太高 |
| 多步跨应用流程 | 不适合。每步 44%,五步串起来只剩 1.6% |
最后一行值得算一遍:单步正确率 44%,串联五步是 0.44⁵ ≈ 1.6%。这就是为什么端侧 agent 现在都只做单步操作,做不了长流程。
官方也承认了边界:仍会出错、不适合高风险场景、知识主要随参数量增长、指令累积时性能下降、低资源语言弱。
这些话说得挺直白。做端侧产品的人该对照这几条判断自己的场景——如果你的任务正好落在"低风险 + 单步 + 参数简单"这一格,0.8B 够用,还省了 API 费用和数据外传的风险。量化那篇里算过 4bit 的误差代价,端侧这个尺寸上,Q4 换来的 3.5 倍显存余量基本是无脑选。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。