
一句话总结:单步正确率 20% 的模型,做五步串联任务,全对的概率是 0.03%——用"全对才给分"的二值奖励,平均要 3125 次尝试才见到一次正样本,梯度信号等于没有。这就是 BotPsy 那类端侧 agent 模型为什么要给部分分。
工具调用用二值奖励,在弱模型上几乎失效
算一遍就明白。任务要连续调对五步工具,每步独立正确率 p:
| 单步正确率 | 五步全对概率 | 二值奖励平均要试多少次 |
|---|---|---|
| 44% | 1.65% | 61 次 |
| 30% | 0.24% | 412 次 |
| 20% | 0.03% | 3125 次 |
| 10% | 0.00001% | 100000 次 |
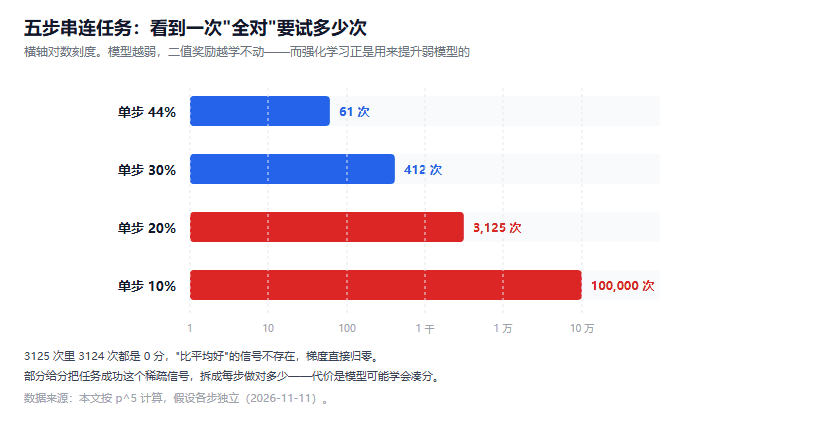
图 1:横轴为对数刻度,五步串联任务下二值奖励的期望尝试次数
这个表的意思是:模型越弱,越学不动。而强化学习恰恰是用来提升弱模型的。逻辑上自相矛盾。
强化学习的梯度来自"这次比平均好多少"。如果 3125 次里 3124 次都是 0 分,那"平均分"就是 0,没有任何一次能提供"比平均好"的信号。整个训练停在这里。
用十行代码验证这个数字
上面的表是按 p⁵ 算出来的解析值。可以再用蒙特卡洛跑一遍,确认量级对得上:
import random

def first_success(p, steps=5, cap=200000):
    """返回第一次五步全对的尝试次数;超过 cap 次算放弃"""
    for i in range(1, cap + 1):
        if all(random.random() < p for _ in range(steps)):
            return i
    return None

random.seed(20261111)
for p in (0.44, 0.30, 0.20):
    runs = [first_success(p) for _ in range(200)]
    ok = [r for r in runs if r]
    avg = sum(ok) / len(ok)
    print(f"p={p}: 200 次试验里 {len(ok)} 次在 20 万步内成功,平均 {avg:.0f} 次")
实际跑出来:p=0.44 平均 56 次,p=0.30 平均 413 次,p=0.20 平均 2803 次。和解析值 61 / 412 / 3125 对得上,差异来自随机波动(每组只跑 200 次试验)。
p=0.20 那组跑起来明显变慢,因为平均要近三千次才等到一次全对。
值得注意的一点:二值奖励的期望尝试次数是指数级增长的。单步正确率从 44% 降到 20%,期望尝试次数从 61 涨到 3125,涨了 51 倍。而正确率只降了 2.2 倍。
这就是为什么弱模型用二值奖励训不动——不是慢一点,是慢两个数量级。
奖励设计:部分给分怎么给
BotPsy 的做法是拆开给:工具名对、参数名对、参数值对,各拿一部分奖励。
一个五步任务,如果每步都能拿到部分分,那每一步都有信号。哪怕最终任务失败,模型也知道"第二步的工具选对了,第三步参数写错了"。
这跟二值奖励的根本区别在于:部分给分把"任务成功"这个稀疏信号,转换成了"每一步做对了多少"这个稠密信号。
代价是奖励和真实目标的偏离。模型可能学会"凑部分分"——把工具名和参数名写对,参数值瞎填也能拿 2/3 的分。所以部分给分的设计要保证"部分分高"和"任务成功"强相关。
三条可以复用的经验
第一,先算清楚奖励的稀疏度。 用上表的方法:单步正确率多少、要串几步、全对概率是多少。如果低于 1%,二值奖励基本不能用。
第二,部分分的粒度要跟失败原因对齐。 如果模型最常错在参数值,那参数值那部分权重要高;如果最常错在工具选择,就反过来。拍脑袋定权重,模型会往容易拿分的地方跑。
第三,留一条兜底信号。 有些任务实在没法拆部分分(比如"这个回答好不好"),可以加一个过程奖励:用另一个模型给中间步骤打分。这个做法成本高,但比训不动强。
三层奖励的权重怎么定
工具调用的奖励通常分三层:格式(能不能解析)、参数(名和值对不对)、结果(任务成不成)。三层怎么配权重,直接决定模型往哪个方向长。
用一个简单的期望回报表看:
| 模型行为 | 格式分 | 参数分 | 结果分 | 加权总分(1:1:1) |
|---|---|---|---|---|
| 全对,任务成功 | 1 | 1 | 1 | 3.0 |
| 格式对、参数错、任务失败 | 1 | 0.3 | 0 | 1.3 |
| 格式错、参数对、任务失败 | 0.4 | 0.8 | 0 | 1.2 |
| 格式对、参数全错、任务失败 | 1 | 0 | 0 | 1.0 |
在等权配置下,"格式对但参数错"能拿 1.3 分,比"格式错但参数对"的 1.2 分更高。
这意味着模型会优先学格式。格式好学——它只取决于输出结构,和任务内容无关;参数对错取决于理解,难度高得多。等权配置下,模型自然往容易的方向走。
BotPsy 的 IFEval 90.8 和 BFCL 44.0,就是这种倾向的极端表现:格式能力被训到了很高,工具调用的准确率还停在一半。
如果想反过来,得把结果层的权重调高:
| 权重配置(格式:参数:结果) | 模型会更倾向 |
|---|---|
| 1 : 1 : 1 | 先保证格式能解析 |
| 1 : 2 : 4 | 优先把参数填对 |
| 1 : 1 : 8 | 一切为了任务成功,格式容忍度高 |
没有普适的最优配置。端侧场景要格式严格(渲染、解析都靠它),就可以给格式高权重;需要模型真正把事办成,就得把结果层压上去。
关键是意识到你在用权重投票。 三层等权不是"中立",是明确地偏向最容易的那层。
强化学习为什么用 DAPO 不用 PPO
BotPsy 用的是 DAPO,不是传统的 PPO。这个选择和小模型的处境有关。
PPO 需要一个和策略模型同规模的价值网络(critic)来估计基线。对 0.8B 的模型来说,加一个 0.8B 的 critic,训练成本直接翻倍。
DAPO 走的是组内归一化:同一个问题采样一组回答,用这组的平均奖励当基线。不需要 critic,也就省掉一半显存。
代价是基线估计得更粗——组内有几个样本,基线就由这几个样本决定。采样方差大的时候,梯度信号会跟着抖。
对小模型来说这笔买卖划算:显存本来就紧,能用更少的资源跑 RL,比用更精细的估计但跑不动更重要。
工具调用的奖励为什么特别难设计
因为工具调用有"看起来对但实际错"的情况。
参数传了个不存在的值——语法对,语义错。工具选对了但顺序错了——每步都对,串联起来失败。调用了不该调的工具——用户没说要做这个。
这几种错,二值奖励都只能给 0,分不出差别。而它们对应的修正方式完全不同。
所以现在工具调用类模型的训练,普遍用三层奖励:格式奖励(能不能解析出调用)、参数奖励(名和值对不对)、结果奖励(执行完任务成不成)。三层各自的权重,决定了模型最终偏向哪种能力。多教师蒸馏那篇讲的是怎么把不同能力的梯度分开传,这里讲的是怎么让信号不稀疏——两个问题经常同时出现。
端侧模型那篇里 BotPsy 的 BFCL 只有 44 分,也可以从这个角度看——它把大量训练信号投在了格式和参数上(所以 IFEval 能到 90.8),结果奖励那层相对弱,所以端到端调用准确率还没跟上。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。