
一句话总结:我用 numpy 把权重和激活分别量化到 8bit 和 4bit 跑了一遍:8bit 权重误差 0.66%、argmax 零翻转;4bit 权重量化后误差 11.8%、翻转 15%;权重和激活同时 4bit,误差涨到 16.7%、翻转 17.6%。两项误差不是相加,是叠加。
LongCat-2.5 用的就是 W4A4:专家权重和激活同时量化到 4bit,走原生 INT4 矩阵乘法单元。官方说已评测任务"表现与量化前相当"。
那 4bit 到底损失多少、损失在哪,值得自己量一遍。
W4A4 的 4bit 到底损失多少
实验设置:K=4096、N=64 的随机权重矩阵,256 条输入,分组量化(group=128),对照 FP32 基准。
| 配置 | 平均相对误差 | 最大绝对误差 | argmax 翻转率 |
|---|---|---|---|
| FP32 基准 | 0 | 0 | 0 |
| 仅权重 8bit | 0.66% | 3.8e-2 | 0.00% |
| 仅权重 4bit | 11.81% | 6.1e-1 | 15.23% |
| 仅激活 4bit | 11.68% | 6.1e-1 | 12.11% |
| W4A4 | 16.73% | 9.0e-1 | 17.58% |
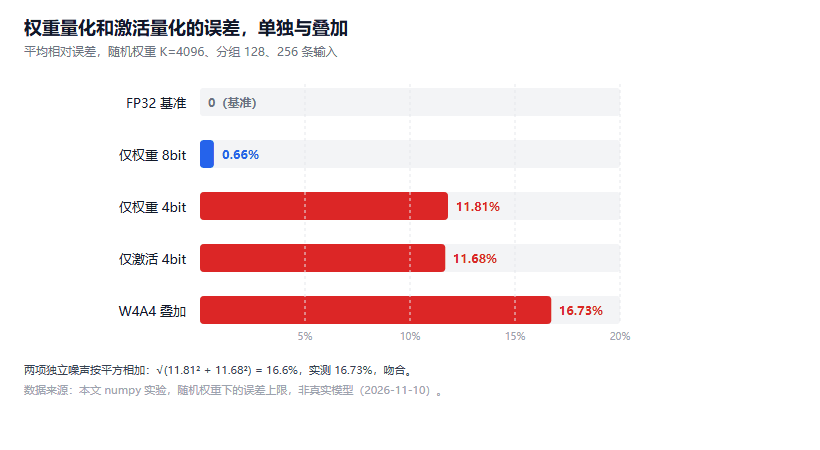
图 1:平均相对误差,蓝条为 8bit、红条为 4bit 及两者叠加
8bit 到 4bit 之间有个陡崖:误差从 0.66% 跳到 11.8%,翻转从 0 跳到 15%。原因在量化级数:8bit 有 255 个间隔,4bit 只有 15 个。同样一个权重,前者能落在 256 个位置,后者只有 16 个。
量化误差不是两项相加
单独权重 4bit 误差 11.81%,单独激活 4bit 11.68%,两者一起 16.73%。
如果误差线性叠加,应该是 23.5%;如果是独立噪声按平方相加,应该是 16.6%。实测 16.73%,非常接近后者,说明两边的量化噪声基本不相关,误差按平方和增长,不是简单加法。
这个特性有用:它意味着把一边从 4bit 提到 8bit,收益不是减半。试算一下,权重 8bit + 激活 4bit 的理论误差约 √(0.66² + 11.68²) = 11.7%,和"仅激活 4bit"几乎一样。也就是说权重那一路压到 4bit 几乎不额外增加误差,真正拖后腿的是激活。
如果只能保一路,保激活。这跟直觉相反——大家通常先压权重(体积大、省显存多),实际从数值稳定角度看,激活的量化误差影响更大。
分组大小是唯一的旋钮
固定 W4A4,只改分组大小:
| 分组 | 相对误差 | argmax 翻转 |
|---|---|---|
| 32 | 13.72% | 16.02% |
| 64 | 15.12% | 17.19% |
| 128 | 16.67% | 20.31% |
| 256 | 18.03% | 19.14% |
| 1024 | 20.51% | 20.31% |
分组从 1024 缩到 32,误差从 20.5% 降到 13.7%,降三分之一。
代价是 scale 的存储:每个分组要存一个 FP16 的缩放因子。group=32 时,每 32 个 4bit 权重(16 字节)配 2 字节 scale,额外开销 12.5%;group=128 时只有 3.1%。
所以这是一个纯粹的工程取舍:省显存还是省精度。LongCat 没有公布他们用了多大的分组,这个数字直接影响实际表现和显存占用。
这个 4bit 实验的局限
有个前提必须说清楚:我用的是随机权重,不是训练好的模型。
随机权重没有结构,64 个输出类别的 logits 接近均匀分布,稍微扰动就会改变 argmax。真实模型的 logits 有明显间隔(正确答案那个通常高出好几个数量级),量化噪声很难翻得动。所以 15%–17% 的翻转率是上限,真实模型的翻转率会低一个量级。
这也是官方敢说"表现与量化前相当"的原因:不是量化没误差,是误差落在 margin 之外。
真正要验证得用真模型跑下游任务,之前做权重修改实验时也遇到过同样的边界——小矩阵上测出来的结论,换到 700 亿参数的模型上量级会变。这次我能给的只是误差的量级和方向,具体到 LongCat 的 4bit 到底掉几个点,得看他们的评测集。
另一个没测的是校准数据。生产级量化会用一小批真实数据统计激活分布,据此定每一层的 scale,比我现在用的"取绝对值最大"精细得多。这一步能把激活误差压下来不少,具体压多少取决于校准集和实际输入的分布差多少。
所以 W4A4 这条路能不能走通,关键不在算法,在于校准集选得好不好——这跟 LongCat 在训练时给模型断网 是两类不同的问题,一个是部署端的数值误差,一个是训练端的行为偏差。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。