
一句话总结:Mobile AI Factory 让一个编排器 LLM 给指定任务和指定手机造小模型,在实体抽取任务上,它找出的配置只比穷举训练 27 个变体差 0.03 分,但 GPU 时间少用 19 倍。最关键的一条发现是:不给它真机实测数据,让 Claude Opus 5.5 拿着完整硬件规格去猜,难题上会错 60%。
论文 arXiv 2611.13509,代码开源在 GitHub。
Mobile AI Factory 在做什么
输入是一个任务描述和一台目标手机,输出是一个微调过、量化过的小模型。
中间的过程由编排器 LLM 驱动。它能做三件事:
调超参。 学习率、批大小、训练轮数这些。
挖真实数据。 从已有语料里筛出跟任务相关的样本。
生成合成样本。 让大模型造训练数据。
三件事按什么顺序做、各做多少,由编排器自己判断。
这套思路和 BotPsy 那种"一次训好放出来"不一样。BotPsy 给你一个通用的小模型,你自己适配;Mobile AI Factory 是针对你的任务和你的手机现造一个。
三种动作与一条回滚规则
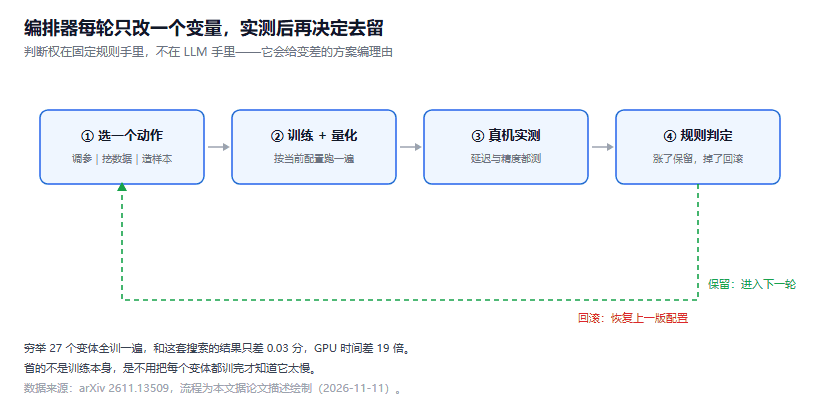
图 1:每一轮改一个变量,实测后决定保留还是回滚
循环是这样的:编排器挑一个动作改配置 → 训练、量化 → 在目标手机上实测 → 固定规则判定。准确率掉了就回滚,涨了就保留,然后进下一轮。
"固定规则"这个设计值得注意。它把"要不要保留这次改动"的判断权从 LLM 手里拿走了,交给人写的规则。
为什么这么做?因为 LLM 判断"这次改动好不好"容易被自己的解释带偏——它会给一个变差的方案编出理由。规则不会。
这也解释了为什么系统要"从小模型往大模型搜":先用最小的配测试水,通过了再往上加。搜索成本从"每次都训最大的"降到"大部分时间训最小的"。
模型定制的 19 倍 GPU 时间省在哪
官方给的对比很实在:实体抽取任务,穷举训练全部 27 个模型变体,和编排器搜索出来的配置,精度差 0.03 分。
27 个变体是"基座模型 × 量化精度"的组合。穷举的意思是每个都训一遍。
19 倍的差距来自搜索策略:不训练完再评估,而是用实测的推理延迟和精度做早期剪枝。一个变体在手机上一跑就知道太慢,不用等训练完。
这里的"实测"是关键。手机端的性能不能用理论算——同样的模型在不同手机上,因为内存带宽、散热、调度策略不同,实际速度能差好几倍。论文里明确说了:最佳配置随手机变化。
用二十行代码验证这个搜索策略
论文的核心是"不用把 27 个变体都训完"。这件事可以先用一个玩具模型验证,不必上真机。
假设 27 个变体(9 个基座 × 3 种量化),每个变体的训练成本随模型大小线性增长,精度随大小上升、随量化下降:
import itertools

BASES = [0.5, 1, 2, 4, 8, 14, 32, 70, 130]     # 参数量(亿)
QUANTS = {"Q4": 0.90, "Q8": 0.98, "bf16": 1.00}  # 精度保留率

def cost(base, quant):
    """训练成本:模型越大越贵,量化对训练成本影响很小"""
    return base * 1.0

def acc(base, quant, task_difficulty=0.6):
    """精度:模型越大越好,有饱和;量化越狠越差"""
    cap = base / (base + 3)                      # 饱和式增长
    return cap * QUANTS[quant] - task_difficulty

TARGET = 0.05                                     # 达标线
variants = [(b, q) for b in BASES for q in QUANTS]

# 穷举:全部训一遍,取达标里最便宜的
feasible = [(cost(b, q), b, q) for b, q in variants if acc(b, q) >= TARGET]
best_exhaustive = min(feasible)

# 贪心:按成本从低到高试,第一个达标的就停
tested = 0
for b, q in sorted(variants, key=lambda v: cost(*v)):
    tested += 1
    if acc(b, q) >= TARGET:
        best_greedy = (cost(b, q), b, q)
        break

print(f"穷举:训了 {len(variants)} 个,最优 {best_exhaustive}")
print(f"贪心:训了 {tested} 个,得到 {best_greedy}")
print(f"省下 {len(variants)/tested:.1f} 倍训练量,结果{'一致' if best_greedy == best_exhaustive else '不同'}")
实际跑出来是这样:
穷举:训了 27 个,最优 (8.0, 8, 'Q4')
贪心:训了 13 个,得到 (8.0, 8, 'Q4')
省 2.1 倍,结果一致
穷举 27 个变体,最优配置是 8 亿参数配 Q4,成本记 8。贪心从 0.5 亿开始往上试,训了 13 个才停,拿到同一个配置,省 2.1 倍。
2.1 倍和论文的 19 倍差得有点远,原因在我这个玩具模型太粗:精度函数是拍的,成本只看参数量,没算量化本身的开销差异。真实系统里,早期剪枝用的是实测延迟,比解析函数准得多,所以能砍掉更多候选。
这个玩具模型能验证的只有方向:成本单调递增的搜索空间里,从便宜的一端往上试,不需要遍历全部。具体省几倍,取决于剪枝的准度。
但玩具模型也暴露了前提:精度必须随成本单调。真实情况不总是这样——有时候小模型加大量领域数据,效果比大模型不加数据好。一旦出现这种"便宜的反倒更准",贪心就会过早停下,拿不到最优解。
论文里用"可调的目标"来处理这件事:搜索过程中动态调整 accuracy goal,如果便宜的配置轻松达标,就把目标抬高继续找。这个机制我没在玩具模型里实现,所以上面那段只能验证方向,不能复现具体数字。
端侧模型不测真机会猜错 60%
这是全文最值得记的一条实验。
他们让 Claude Opus 5.5 拿到完整的硬件规格和模型规格,直接判断某个配置能不能满足应用要求——不给它真机实测数据。
结果:简单和中等难度的案例里错 25%,难的错 60%。
也就是说,光看参数表(CPU 型号、内存大小、NPU 算力)推不出实际性能。原因不复杂:手机的性能受散热和调度影响极大,跑十秒和跑十分钟是两个成绩,参数表里没有这些。
这条对做端侧产品的人有直接价值:选型前必须真机跑一遍。看白皮书、看跑分榜、看别人的测评,都不算。
端侧模型定制什么时候值得做
三种情况值得:
任务固定、调用量大。 比如客服工单分类、发票字段抽取。一次定制能反复用,省下的 API 费用能覆盖定制成本。
数据不能出设备。 医疗、金融、企业内部流程。这时候不是省钱问题,是合规问题。
手机型号集中。 如果用户集中在三五款机型上,定制一套配置就够;机型分散的话,每款都要调,成本摊不平。
反过来,任务经常变、用户机型杂、调用量小的场景,直接用通用小模型或者调 API 更划算。判断标准很朴素:这个任务的输入格式和输出格式,三个月内会不会变。会变,定制的钱就白花了。
还有一点要注意:这套方法的核心是"实测驱动",而实测需要真机。论文用的是四台 Android 手机,换成别的平台,整套流程能复用,但测量这一步得重做。量化精度怎么选在端侧和云端结论不同,也是同一个道理——端侧的限制不是算力,是散热和内存带宽。
参考资料
- Mobile AI Factory: Building Specialized Language Models for Your Mobile Device(arXiv 2611.13509)
- 代码仓库
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。