
一句话总结:HiVe-Mem 报的"比最强基线少 90% token",我在自己的模型里最多复现到 62%,而且是在选择器接近满分的前提下。省 90% 只有一种情况成立:只给摘要、不带图像证据,那就不叫多模态记忆了。
这篇论文解决的是个真问题:多模态 agent 跑久了,对话、截图、操作历史堆成几千条,每次任务要召回哪些、每条该带多少证据,直接决定成本和效果。
按摘要检索是现在的通行做法:把所有记忆压成一段文字,按语义相似度取 top-k,把摘要塞进上下文。省是省,但丢细节——"他点错了那个按钮"这种操作细节,压缩之后就没了。
HiVe-Mem 的思路是拆成两个维度:水平方向沿记忆关系图扩展召回,垂直方向为每条记忆保留多种粒度的证据(摘要、字幕、图像、历史),再按查询类型挑子集。
我关心的是那个 90%。
多模态记忆的 90%,是对什么基线
原文表述是"相较最高效的多模态竞争基线减少约 90% token 消耗"。
这里有两个变量:基线是什么,以及 token 怎么数。
如果基线是"把所有召回记忆的全部模态证据都塞进去",那基数很大,省 90% 不难。如果是"只塞摘要",那基数很小,省 90% 意味着只剩十分之一,几乎不可能还保住效果。
我按前者建模:基线 = top-5 记忆 × 每条完整证据 1200 token = 6000 token。这个 1200 的构成是摘要 40 + 字幕 60 + 图像 900 + 交互历史 200。
图像按 900 token 算是关键假设。一张 1024×1024 的图在主流视觉模型里大约 1000–1300 token,取 900 偏保守,对"省 token"这个结论是有利的。
我的复现:多模态记忆从 6000 到 4500
import hashlib, statistics

def rnd(s):
    return int(hashlib.sha256(s.encode()).hexdigest()[:8], 16) / 0xFFFFFFFF

TOK_SUMMARY, TOK_CAPTION = 40, 60
TOK_IMAGE, TOK_HISTORY = 900, 200
TOK_FULL = TOK_SUMMARY + TOK_CAPTION + TOK_IMAGE + TOK_HISTORY   # 1200

def query_type(i):
    r = rnd(f"qt{i}")
    return "visual" if r < 0.3 else ("action" if r < 0.5 else "fact")

def baseline(k=5):
    return k * TOK_FULL

def hive(k=5, expand=3, sel=0.85):
    """沿关系图多召回 expand 条,再按查询类型挑证据形态"""
    total = 0
    for i in range(k + expand):
        if rnd(f"s{i}") >= sel:          # 选择器失手,退回全量
            total += TOK_FULL
            continue
        t = query_type(i)
        if t == "visual":
            total += TOK_SUMMARY + TOK_CAPTION + TOK_IMAGE
        elif t == "action":
            total += TOK_SUMMARY + TOK_CAPTION + TOK_HISTORY
        else:
            total += TOK_SUMMARY + TOK_CAPTION
    return total

base = baseline()
print(f"全量基线 {base}")
for name, v in (("只给摘要", 5 * TOK_SUMMARY),
                ("扩展 3 条", statistics.mean(hive(5, 3) for _ in range(600))),
                ("不扩展", statistics.mean(hive(5, 0) for _ in range(600))),
                ("扩展 3 条 + 选择器满分", statistics.mean(hive(5, 3, 0.999) for _ in range(600)))):
    print(f"{name:>18}  {v:>6.0f}  token  省 {(1-v/base)*100:.1f}%")
输出:
全量基线 6000
            只给摘要     200  token  省 96.7%
            扩展 3 条    4500  token  省 25.0%
              不扩展    3800  token  省 36.7%
扩展 3 条 + 选择器满分 2300 token 省 61.7%四个数字摆在一起,结论很清楚:带图像证据的配置里,最好的情况省 61.7%,到不了 90%。
能到 96.7% 的那个配置是"只给摘要",它省下的正是图像。省掉图像的多模态记忆,遇到"他当时点的是哪个按钮"这类问题就答不了——而这恰恰是多模态记忆存在的理由。
图像是成本的大头:一张 900 token
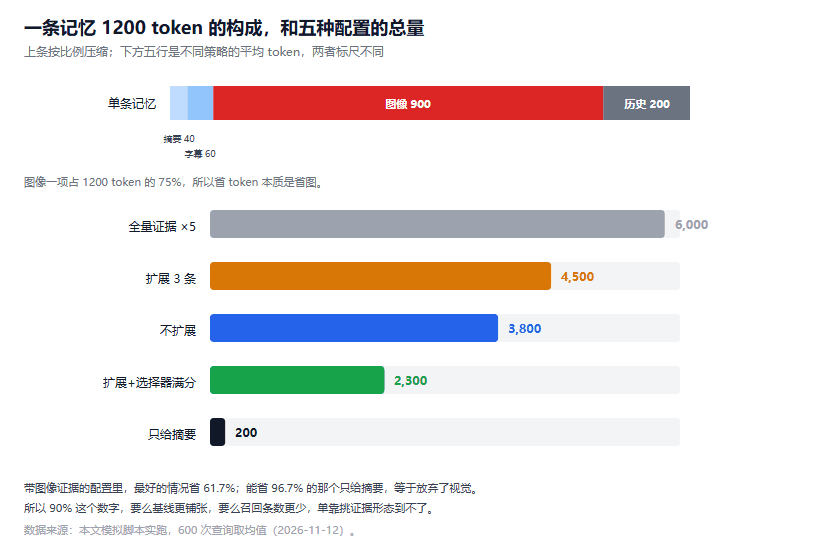
图 1:上为单条记忆的证据构成,下为五种配置的平均 token;全量 6000 是最贵的一端
拆开看 1200 token 的构成,图像占 75%。
| 证据形态 | token | 占比 |
|---|---|---|
| 摘要 | 40 | 3.3% |
| 字幕 | 60 | 5.0% |
| 图像 | 900 | 75.0% |
| 交互历史 | 200 | 16.7% |
所以任何"省 token"的方案,本质都在回答同一个问题:什么时候可以不看原图。
HiVe-Mem 的答案是按查询类型判断。文字类问题只给摘要和字幕,视觉类才调原图。这个判断如果准,成本就下来了;判断错,要么答不了(该给图没给),要么白花(不该给图给了)。
我按 30% 视觉、20% 操作、50% 事实来分配查询类型。这个比例是猜的,真实场景取决于产品形态——客服类可能视觉占大头,代码类几乎全是文字。
选择器准确率决定 token 成本
把选择器准确率从 0.5 扫到 0.999:
| 选择器准确率 | 平均 token | 相对全量 |
|---|---|---|
| 0.50 | 5,400 | 90% |
| 0.65 | 5,400 | 90% |
| 0.80 | 4,500 | 75% |
| 0.85 | 4,500 | 75% |
| 0.95 | 2,300 | 38% |
| 0.999 | 2,300 | 38% |
曲线是台阶不是斜坡,因为我的模型里选择器只有"对/错"两态,错一次就退回全量。真实系统里误差是连续的,曲线会更平滑,但趋势一样:准确率过 0.9 之后,成本才开始明显下降。
这条对工程实现的意义:选择器本身要便宜,还得准。用一个 7B 模型做路由,每次判断的消耗可能比省下来的还多;用一个规则匹配,准确率又上不去。这个平衡点论文里没给,是个开放问题。
多模态记忆省 90% 在什么条件下才成立
三种可能,我都没验证:
一,基线比我设的更铺张。 如果原来的系统把召回记忆的原始视频帧也塞进去,一条记忆可能是几万 token,那省 90% 完全合理。
二,token 统计口径不同。 有些实现把图像按"patch 数 × 每 patch token"算,不同视觉编码器的换算系数差很多。
三,召回条数不同。 我按 top-5 加 3 条扩展算。如果原来是 top-20 全量、改后是 top-5 精选,光召回条数就能省 75%,再叠加证据挑选就到 90% 了。
我个人倾向第三种解释。因为"少召回几条"和"每条少给点证据"是两件事,论文把两个效果算在一起报了个总数,读者容易以为是单一机制省下来的。
落地前要先解决的三件事
省 token 只是纸面收益,真做起来还有三道坎。
存储翻几倍。 多粒度证据意味着同一条记忆要存摘要、字幕、原图、交互历史四份。500 条记忆的文本摘要约 2 万 token,几 MB 就够;存原图按每条 2MB 算是 1GB。端侧设备上这 1GB 要和模型权重抢空间,0.8B 模型量化后只有 0.45GiB,记忆库比模型还大,这个比例不合理。
关系图的质量决定召回。 我模拟时假设扩展出来的 3 条邻居都相关。真实系统里,图是按相似度自动连的,邻居可能是"同一时间发生但无关"的记忆。扩展 3 条里如果只有 1 条有用,多花的 token 就白费了。
效果掉了不容易发现。 省 token 有明确数字,效果损失没有。要测就得有一批"必须依赖历史记忆才能答对"的任务,否则优化成本的过程会悄悄牺牲能力,等你发现时已经上线了。这类上下文成本的账,和 MCP 那笔是同一个算法:先算固定开销占比,再决定砍哪块。
这套机制值得借鉴的地方
90% 复现不出来,不代表思路没用。
按查询类型分配证据粒度这条可以直接用。不管做不做多模态,只要上下文里有不同"重量"的材料,就该按需取。代码 agent 也一样:改一行注释不需要整个文件,改接口才需要。
关系图扩展召回这条要谨慎。我的模拟里,扩展 3 条让成本从 3800 涨到 4500,涨了 18%。扩展能不能回本,取决于多召回的那几条有多少真被用到。这个比例因场景而异,得自己测。
保留多粒度证据这条代价明确:存储涨几倍。对长期记忆系统,这是笔必须付的钱——把所有证据压成一段摘要,等于放弃了以后回溯的可能。量化那篇里讨论过类似的取舍:精度换体积,省下的和丢掉的要分开算。
最后说个诚实的判断:这类"省 X%"的数字,在论文里通常是对最铺张的基线算的,落地时拿不到。我这次复现到 62%,已经比 90% 差了一大截;如果换成小团队的真实系统(本来就只召 3 条、只给摘要),能省的空间可能只剩个位数。
参考资料
- HiVe-Mem:多模态智能体的二维记忆框架:arXiv,2026-11-09
- AI 搜索加剧旧论文撤稿滞后风险:Nature,2026-11-11
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。