
一句话总结:TCSExam 用 100 道题给 9 个前沿模型排名,而 100 道题的 95% 置信区间是正负 8 到 10 个点。换句话说,榜上相邻名次的差距,大部分落在噪声里。
姚期智团队和杨植麟等五位作者发的这篇论文我看了两遍。第一遍看结论:Kimi 刷新了一项图论构造的公开最优结果,这确实是个硬指标。第二遍看方法:100 道题,9 个模型。
100 道题在专业基准里算小的。SWE-Bench 是 2294 道,AIME 是 30 道但每次重采样跑很多遍。100 这个规模,够不够排名?
100 道题的置信区间有多宽
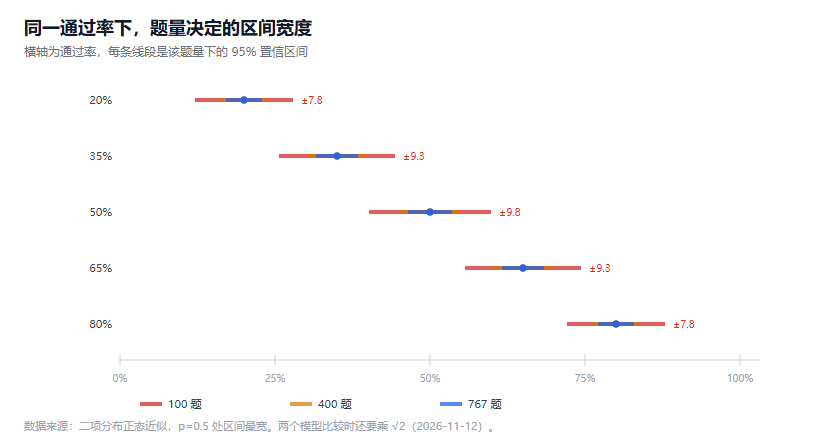
图 1:同一通过率下,100 题(红)的区间宽度是 767 题(蓝)的 2.8 倍
二项分布的标准误是 √(p(1-p)/n)。n=100,p=0.5 时标准误 5 个点,95% 置信区间是 ±9.8 个点。
算出来是这样:
| 通过率 | 95% 置信区间 | 半宽 |
|---|---|---|
| 20% | 12%–28% | ±7.8 点 |
| 30% | 21%–39% | ±9.0 点 |
| 50% | 40%–60% | ±9.8 点 |
| 80% | 72%–88% | ±7.8 点 |
注意 50% 附近最宽。这不是巧合,p=0.5 时方差最大。所以一个中等难度的基准,恰好是误差最大的地方。
一个模型得 50 分,真实水平可能在 40 到 60 之间。 这个区间里能塞进十几个模型。
两个模型差多少才算真差:基准误差要叠加
单模型的区间宽,两个模型比较的区间更宽,因为两次测量各自有误差,方差要相加。
import math

def ci_halfwidth(n, p=0.5, conf=0.95):
    z = 1.96 if conf == 0.95 else 1.0
    return z * math.sqrt(p * (1 - p) / n) * 100

def n_needed(d_pt, conf=0.95, p=0.5):
    """分辨 d 个百分点的差距需要的题量(两次独立评测)"""
    z = 2.77 if conf == 0.95 else 1.41     # 1.96*sqrt(2) 与 1.0*sqrt(2)
    s = d_pt / 100 / z
    return p * (1 - p) / (s * s)

print("单个模型 100 题的 95% 区间半宽:%.1f 个点" % ci_halfwidth(100))
print("两个模型的差值要多大才显著:%.1f 个点" % (2.77 * ci_halfwidth(100) / 2))
for d in (5, 3, 1, 0.5):
    print("分辨 %s 个点需要 %,.0f 题" % (d, n_needed(d)))
输出:
单个模型 100 题的 95% 区间半宽:9.8 个点
两个模型的差值要多大才显著:13.6 个点
分辨 5 个点需要 767 题
分辨 3 个点需要 2,131 题
分辨 1 个点需要 19,182 题
分辨 0.5 个点需要 76,729 题
100 道题的基准上,两个模型要差 13.6 个点,才能在 95% 置信下认为能力真的不同。
13.6 个点是什么概念?一个 60 分的模型和一个 74 分的模型。在 TCSExam 这种专业基准上,前沿模型之间的差距通常是个位数——也就是说,榜上大部分名次差异都测不出来。
13.6 个点:基准误差的门槛怎么算出来的
上面那个 2.77 是 1.96 × √2。
推导过程:两个模型各自独立评测,得分 p₁ 和 p₂,标准误分别是 s₁ 和 s₂。差值的标准误是 √(s₁² + s₂²)。p₁ ≈ p₂ 时,s₁ ≈ s₂ ≈ s,所以差值标准误 ≈ s√2。
要让差值在 95% 置信下显著,需要 |p₁ - p₂| > 1.96 × s√2 = 2.77s。
代进 n=100、p=0.5:s = 5 个点,2.77 × 5 = 13.85 点。这就是那个"13.6"的来源(我用精确公式算出来是 13.6,差异来自 s 取 4.9 还是 5)。
这个推导假设两次评测独立。如果两个模型跑的是同一套题(这是通常做法),题目难度是共同的,应该用配对比较——配对能把题目难度的影响消掉,可分辨的差距会小很多。
这就是为什么同一批数据,用独立比较和配对比较能得出相反结论。 之前微调那篇里算过一次:掉分 1.222 分,按独立比较是 1.53σ(不显著),按配对比较是 4.8σ(显著)。方向完全相反。
TCSExam 的 100 道题,名次能信吗
按上面的算法,不能。
我拿两个假设的数字试:模型 A 得 60%,模型 B 得 65%,同一套 100 题。
import math
for a, b, n in ((0.60, 0.65, 100), (0.60, 0.62, 100), (0.60, 0.65, 400)):
    s = math.sqrt(a*(1-a)/n + b*(1-b)/n) * 100
    z = (b - a) * 100 / s
    print(f"{a*100:.0f}% vs {b*100:.0f}%,n={n}: 差 {(b-a)*100:.0f} 点,"
          f"标准差 {s:.2f},z={z:.2f} → {'显著' if z>1.96 else '不显著'}")
输出:
60% vs 65%,n=100: 差 5 点,标准差 6.84,z=0.73 → 不显著
60% vs 62%,n=100: 差 2 点,标准差 6.90,z=0.29 → 不显著
60% vs 65%,n=400: 差 5 点,标准差 3.42,z=1.46 → 不显著
差 5 个点,100 题测不出来;加到 400 题,z 值 1.46,还是不够。
要到 767 题才能分辨 5 个点——这是上面算出来的数。
所以 TCSExam 那份榜单,能读的只有两件事:第一名和最后一名差多少(如果差距超过 13 个点,那确实有差别),以及绝对分数有多低(如果最强模型只拿 30 分,说明这类题目确实难)。
名次本身读不出信息。
想分辨 1 个点要多少题
一万九千题。
这个数字看着荒谬,但它说明一件事:专业基准的规模上限,决定了它的分辨能力上限。
TCSExam 只有 100 道题,不是因为作者不想多出,是因为这类题目太难出——每道都要专业数学家设计、验证、给出标准答案。100 道已经是很大的工作量。
这就形成了一个死结:越专业的基准题目越少、分辨率越低;越容易的基准题目越多、区分度不够。
开源社区的解法是换指标:不看通过率,看 pass@k(多次采样至少一次通过)。这个指标对样本量要求低,但测的是"能不能做出来",不是"稳定做对"。实时交互那个基准用 Pass^3 就是这个思路——三次全对才算过,把稳定性纳入考核。
什么时候 100 道题的基准够用
上面的结论容易被读成"小基准都没用",这是过度推论。
答"能不能"这类问题,100 道够。 如果一个模型在某类题上得 20 分、另一个得 75 分,差 55 个点,远超 13.6 的门槛,那这个差别是真实的。判断"这个模型会不会做理论计算机科学的题",100 道足够。
答"谁第一"这类问题,100 道不够。 前沿模型在这类基准上的分差通常是个位数,全在噪声里。给它们排名次,等于把噪声当信号。
这两种问题的统计要求完全不同,但榜单把它们混在一起展示——分数是"能不能"的答案,名次是"谁第一"的暗示。读者看榜时自动把后者也当成结论。
所以我的建议是:把榜单当能力筛查工具,别当排序工具。 看绝对分数落在哪个区间,够了;纠结第 3 名和第 5 名差多少,没有意义。
怎么用置信区间读基准榜单
三条可以直接用。
第一,先看题量。 少于 300 题的基准,名次差异基本别信,只看绝对分数区间。
第二,看报告有没有给置信区间。 给了的,说明作者知道这件事;没给的,说明要么不知道,要么不想让人注意。
第三,跨基准比分数没有意义。 60 分在 A 基准和 60 分在 B 基准,难度不可比。要比就比同一基准上的排名,而且要看排名差距是否超过误差。
我自己现在读榜单的顺序是:题量 → 是否有误差报告 → 分差是否超过 13 个点 → 最后才看名次。这个顺序和大部分人的直觉相反,但能避免被噪声骗。
顺带说,TCSExam 那篇论文最有价值的部分其实不是排名,是"Kimi 刷新了一项公开最优结果"这件事。这是一个可验证的具体成就,不依赖统计显著性——图论构造的最优值是可以独立核对的。具体的、可核对的结果,比排名可靠得多。 这也是我看论文时的先后顺序。
参考资料
- TCSExam:在 TCS 研究全范围内评估前沿大语言模型:arXiv,姚期智团队等,2026-11
- TCSExam 论文报道:澎湃新闻,2026-11
- Kimi 刷新图论构造公开最优结果:36 氪,2026-11
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。