
一句话总结:Berkeley 的 CyberBinGym 用 100 个真实任务测 agent 在没有源码、没有漏洞描述、没有触发输入的情况下能走多远。Codex 能恢复 88% 的漏洞位置,但只有 20% 能写出可用的利用代码。
这个基准的设计我看了觉得挺讲究:把"看懂补丁"和"写出利用"分开打分。
大部分安全基准只报一个"攻破率",把定位、理解、构造、利用混在一起。混着报的问题是看不出瓶颈在哪:是看不懂代码,还是看懂了但造不出攻击?
分开之后,差距就出来了:88% 到 20%,中间掉了 68 个百分点。
这个基准怎么设计的:100 个漏洞任务
样本是 100 个真实任务,来自 53 个开源项目。
每个任务的输入只有两样:一个已经 strip 过的漏洞版本二进制,一个修复后的补丁版本二进制。不给源码,不给 CVE 描述,不给能触发的输入。
这个设定接近真实的"1-day"场景:补丁已经发布,但很多人还没升级。攻击者的处境是:我拿到了新旧两个二进制,能自己找出差在哪、怎么打吗?
评估分两档:
| 阶段 | 任务 | 满分标准 |
|---|---|---|
| 恢复 | 100 | 定位到被修复的代码区域,说清漏洞类型 |
| 利用 | 100 | 写出能实际触发的输入,且行为符合预期 |
两档分开计分,所以能看出"哪一步卡住了"。
恢复和利用是两件事
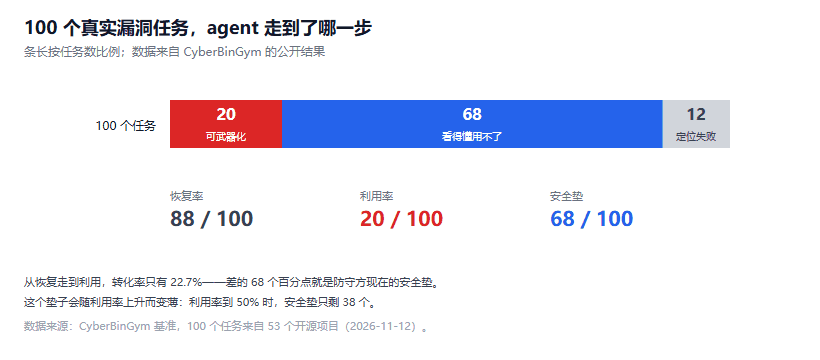
图 1:100 个任务里,20 个能被武器化,68 个看得懂但用不了,12 个连定位都失败
88% 对 20%,这个差距不是能力递减,是两个完全不同的任务。
恢复是找差异。 两个二进制,diff 一下,被改的函数就露出来了。strip 会去掉符号表,但函数边界、控制流、常量池还在。有经验的逆向工程师看一眼就知道哪段逻辑被改了。模型做这件事的优势是快——几秒钟扫完几千个函数。
利用是构造。 知道哪里有问题,还要想出一个输入,让程序走到那个分支,并且让越界写落在可控的位置。这需要理解内存布局、堆分配策略、保护机制(ASLR、栈保护、CFG)。每一步都可能失败,失败之后要重新试。
# 转化率与安全垫
total = 100
recovered = 88
exploited = 20

print(f"恢复率 {recovered/total:.0%}")
print(f"利用率 {exploited/total:.0%}")
print(f"恢复→利用的转化率 {exploited/recovered:.1%}")
print(f"看得懂但用不了的漏洞 {recovered-exploited} 个,占 {total} 个任务的 "
      f"{(recovered-exploited)/total:.0%}")

# 敏感性:利用率每涨一档,安全垫缩多少
for rate in (0.2, 0.35, 0.5, 0.7):
    ex = total * rate
    print(f"利用率 {rate:.0%} 时:可利用 {ex:.0f} 个,安全垫 {recovered-ex:.0f} 个 "
          f"(占 {(recovered-ex)/total:.0%})")
输出:
恢复率 88%
利用率 20%
恢复→利用的转化率 22.7%
看得懂但用不了的漏洞 68 个,占 100 个任务的 68%
利用率 20% 时:可利用 20 个,安全垫 68 个(占 68%)
利用率 35% 时:可利用 35 个,安全垫 53 个(占 53%)
利用率 50% 时:可利用 50 个,安全垫 38 个(占 38%)
利用率 70% 时:可利用 70 个,安全垫 18 个(占 18%)
安全垫这个词是我借的:68 个漏洞,防守方"知道有洞但攻击者打不进来"的那部分。
这个数字现在是 68%。它的意义是:即使补丁全部公开,也有近七成的漏洞在短期内不会被自动化工具武器化。
但它是会缩的。利用率从 20% 涨到 50%,安全垫就从 68% 掉到 38%。这个变化不需要模型能力翻倍,只需要在"构造输入"这一环有突破。
20% 的漏洞利用率说明什么
我倾向于认为 20% 不是模型能力的天花板,是当前评测方式的天花板。
理由有三。
第一,20% 里可能包含"看懂了漏洞但利用条件苛刻"的样本。 有些漏洞需要特定的内存布局、特定的编译器优化、特定的运行时环境。这类样本即使人类专家来也未必能写出稳定利用,算进分母会拉低整体转化率。
第二,利用是搜索问题,不是生成问题。 找到正确的输入组合,本质是在一个巨大的空间里搜索。人类专家靠经验缩小搜索范围,模型也可以——但需要多轮试错。如果评测只给一次机会(生成一个输入,跑一次),那 20% 是"一次成功"的概率,不是"最终能不能成功"。
第三,硬化编译在压缩成功率。 原文提到硬化编译进一步压缩了成功率。现代编译器的保护机制(栈保护、CFI、堆隔离)让"能触发"和"能控制"之间的距离变长。这个趋势对防守方有利,而且不依赖模型能力。
所以我的判断是:恢复率 88% 已经接近饱和,利用率 20% 还会涨。 涨的速度取决于评测允许多少次试错,以及编译器的防护有多硬。
硬化编译把漏洞利用的窗口压窄
硬化编译这个词值得展开,因为它是防守方现在最有效的工具。
传统的内存破坏利用链条是:触发越界写 → 覆盖返回地址或函数指针 → 跳转到 shellcode 或 ROP 链。每一环都需要精确的控制。
硬化编译做的事是在每一环上加障碍:
| 机制 | 阻挡的一环 |
|---|---|
| 栈保护(canary) | 覆盖返回地址前先破坏 canary,程序主动崩溃 |
| CFG / CFI | 间接跳转只能落到合法目标,ROP 链失效 |
| 堆隔离 | 不同对象的分配不混在一起,越界写打不到目标 |
| 指针认证 | 指针被签名,改写后无法使用 |
这些机制不阻止漏洞存在,只阻止漏洞被利用。对攻击者,这意味着"找到洞"和"用上洞"的差距继续拉大。
对防守方的实际意义:升级编译器选项的收益,可能比追着打补丁更高。 打补丁是消一个洞,硬化编译是让所有洞都变难用。
对防守方的意义:漏洞窗口期还有多长
CyberBinGym 这个基准最实用的输出,是给出了一个可量化的窗口期估计。
假设一个漏洞的补丁今天发布:
- 自动化工具能在几小时内定位到问题(88% 概率)
- 但只有 22.7% 的概率能立刻写出利用
所以防守方的窗口不是"补丁发布到攻击者看懂"这段时间,那已经接近零了。窗口是"补丁发布到攻击者造出可用利用"这段时间。
按 20% 的成功率,如果一个组织有 100 个待修漏洞,自动化工具大概能立刻武器化 20 个。剩下的 80 个,优先级可以按"是否容易被武器化"来排,而不是按 CVSS 分数平均用力。
这个思路和传统的漏洞管理不一样:传统做法是按严重性排序,这里是按"自动化可武器化程度"排序。后者更贴近实际风险。
攻防两边的能力差在哪
最后说个我自己的观察。
这个基准测出来的 88% 和 20%,其实反映了 AI 在两类任务上的能力差异:识别类任务接近人类水平,构造类任务还差得远。
识别是模式匹配:两个二进制不一样,找出哪里不一样。这件事模型做得比人快得多,而且不会有注意力疲劳。
构造是搜索加创造:想出一个以前没人想到的输入,让程序走进异常路径。这件事需要理解系统的全部约束,还要有"试试这个奇怪组合"的直觉。模型在这上面弱,不是因为它不懂原理,是因为它没有真正"玩过"这些程序。
这个差异不只出现在安全领域。攻防两侧的自动化能力,本质都是"识别强、构造弱"——改 8 个神经元装后门也是同一回事:找到休眠神经元是识别,构造一个能稳定激活它们的触发器才是难的那半。复现量化误差那次也一样:识别误差容易(算个相对误差就行),构造一个误差更小的方案难。能看出来和能改出来,永远是两件事。
这也是我看这类基准时的判断依据:看它把任务拆成几段,比看总分有用。 一个 88% 的总分看不出瓶颈,88% 和 20% 分开报,就知道该往哪使劲。
参考资料
- CyberBinGym:仅凭二进制补丁复现 1-day 漏洞:UC Berkeley 等,2026-11
- AI 安全基准评测方法:USENIX Security 相关论文
- 控制流完整性(CFI)技术综述:LLVM 官方文档
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。