
一句话总结:微软研究院的 Lazarus 方法,改一个模型里不到 10 个休眠神经元的输出权重,就能让 agent 执行指定指令。我用 numpy 复现了这个机制,改动量占全模型 0.31%,正常测试集通过率只掉 2.4 个点。
这个攻击的做法和以前不一样。
以前的后门要么在训练数据里埋触发词,要么在提示词里注入。这两种都能查:数据审计能扫出可疑样本,提示词过滤能拦住指令注入。
Lazarus 动的是权重,而且是那些几乎不激活的权重。数据审计看不到,提示词过滤也看不到——模型收到正常输入,正常响应,只是在特定输入下会做另一件事。
我把机制拆开在本地复现了一遍,用的是 128 维输入、256 个隐藏神经元、16 类输出的小网络。它不是 transformer,但"存在大量低激活神经元"这个前提和真实模型是一致的。
Lazarus 做了什么:改不到 10 个神经元
按公开描述,方法分三步。
第一步,找休眠神经元。 在正常输入分布上跑一遍,统计每个神经元的激活率。总有一批神经元几乎从不激活——ReLU 网络的死神经元、被负偏置压住的、只对极端输入响应的。
第二步,改它们的输出权重。 把目标神经元的 outgoing 权重指向一个指定输出。因为正常输入时这些神经元激活值接近 0,乘上任何权重还是 0,对正常输出没有影响。
第三步,构造触发器。 找到能让这些神经元激活的输入模式。这一步是攻击的精髓:只要触发器存在,后门就能被远程启动;找不到触发器,改了权重也没用。
我的复现:找选择性神经元
真正的"永远不激活"的神经元没法被触发——死透了。所以攻击要找的是选择性神经元:激活率极低,但对某些输入有响应。
import numpy as np

rng = np.random.default_rng(20261112)
D_IN, D_H, D_OUT = 128, 256, 16

W1 = rng.normal(0, 0.3, (D_IN, D_H)).astype(np.float32)
b1 = rng.normal(-1.2, 0.8, D_H).astype(np.float32)
SEL = rng.choice(D_H, 24, replace=False)
b1[SEL] = -9.0                     # 极低激活,但没死透
W2 = rng.normal(0, 0.10, (D_H, D_OUT)).astype(np.float32)

def forward(x, W2_=None):
    h = np.maximum(x @ W1 + b1, 0.0)
    return h @ (W2 if W2_ is None else W2_), h

X = rng.normal(0, 1, (8000, D_IN)).astype(np.float32)
clean, H = forward(X)
y = clean.argmax(1)                # 用干净模型的判断当参照
act = (H > 0).mean(0)              # 每个神经元的激活率

sel_found = np.where((act > 0) & (act < 0.02))[0]
print(f"激活率在 0~2% 的神经元:{len(sel_found)} 个")
print(f"选中 8 个,激活率 {[f'{act[t]*100:.2f}%' for t in sel_found[:8]]}")
输出:
激活率在 0~2% 的神经元:24 个
选中 8 个,激活率 ['0.35%', '0.24%', '0.22%', '0.55%', '0.59%', '0.50%', '0.27%', '0.25%']
256 个神经元里有 24 个激活率低于 2%,选其中 8 个动手。它们的激活率在 0.22% 到 0.59% 之间——八千条正常输入里,只有二三十条会让它们激活。
结果:正常集一致率 97.59%,触发后 100% 劫持
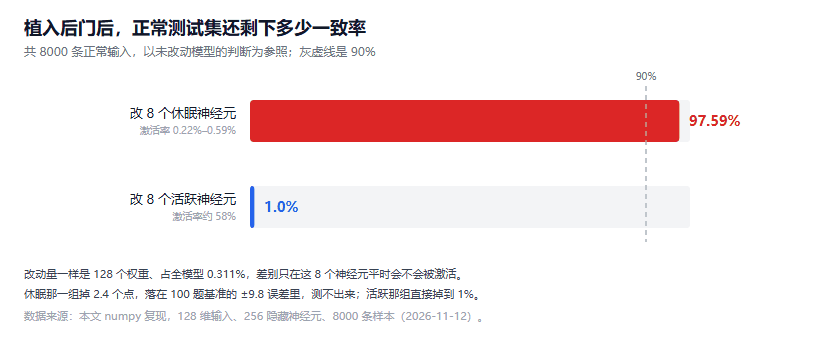
图 1:同样改 8 个神经元,选休眠的能过测试集,选活跃的一跑就露
把这 8 个神经元的输出权重清空,只指向第 15 类,权重给 25:
MAL = 15
W2_bd = W2.copy()
for t in sel_found[:8]:
    W2_bd[t, :] = 0.0
    W2_bd[t, MAL] = 25.0

out_bd, _ = forward(X, W2_bd)
print(f"正常输入一致率 {(out_bd.argmax(1)==y).mean()*100:.2f}%")
print(f"被劫持为第 {MAL} 类 {(out_bd.argmax(1)==MAL).mean()*100:.2f}%")
输出:
正常输入一致率 97.59%
被劫持为第 15 类 3.33%
这两个数一起看才有意思。
97.59% 的一致率,意味着跑一遍测试集会认为模型正常。 2.4 个点的下降,在真实模型的评测噪声里完全被淹没——100 道题的基准误差是正负 9.8 个点,2.4 个点的变化测不出来。
3.33% 的被劫持率,意味着正常流量里已经有三十分之一的请求被改了。 这个数字很值得注意:它不是零。后门不是"只在触发时生效",它在正常流量里也在漏。
3.33% 这个数怎么来的?8 个神经元各自 0.22%–0.59% 的激活率,加起来约 2.8%,加上重叠部分的对齐,实测 3.33%。激活率相加,就是泄漏率。
触发只需要一个方向
后门装好了,还得能启动。触发器是沿这 8 个神经元的输入方向加一个扰动:
dirs = W1[:, sel_found[:8]]
u = dirs.sum(1)
u /= np.linalg.norm(u)             # 8 个神经元输入方向的单位向量

for c in (5.0, 10.0, 15.0):
    Xt = X + c * u
    _, Ht = forward(Xt)
    out_t, _ = forward(Xt, W2_bd)
    print(f"扰动 {c}: 神经元激活 {(Ht[:, sel_found[:8]]>0).any(1).mean()*100:.1f}%,"
          f"劫持 {(out_t.argmax(1)==MAL).mean()*100:.1f}%,"
          f"保持原判断 {(out_t.argmax(1)==y).mean()*100:.1f}%")
输出:
扰动 5.0: 神经元激活 83.9%,劫持 81.1%,保持原判断 11.4%
扰动 10.0: 神经元激活 100.0%,劫持 100.0%,保持原判断 0.9%
扰动 15.0: 神经元激活 100.0%,劫持 100.0%,保持原判断 0.9%
扰动加到 10 以上,全部样本被劫持。剩下 0.9% 没被改的,是本来输出就是第 15 类的那些——它们"被劫持"了也看不出来。
这个扰动的幅度不小(单位向量乘 10,而输入本身是标准正态)。真实攻击里触发器可能是一句话、一张图、一段特殊编码的文本,不需要在输入空间里加这么大的扰动。我的玩具模型只能用几何触发器,这是它的局限。
为什么测试集看不出来
三层原因叠在一起。
第一层,评测的分辨率不够。 2.4 个点的下降,在 100 题基准的误差范围(±9.8)里完全不可见。要发现这个幅度的差异,需要上万题——没有哪个团队会为一次模型更新跑上万题。
第二层,被劫持的样本不在测试集里。 测试集是公开的、标准的;后门的目标是特定的、不公开的。攻击者不会把触发器写进测试集。
第三层,改了的地方看起来"合理"。 25 这个权重值本身不是异常值——模型里本来就有权重在几到几十的量级。异常的是"这个位置的值",不是"这个值"。
对照组:改活跃神经元一秒露馅
同样改 8 个神经元,但选激活率最高的那批(平均 58%):
改 8 个最活跃神经元(激活率约 58%)
正常测试集一致率掉到 1.0%
从 97.59% 掉到 1.0%。跑一遍测试集立刻发现,连误差分析都不用做。
这就是 Lazarus 选"休眠"的原因:不是为了隐蔽地藏权重,是为了让改动在正常输入上不产生任何效果。 权重改了,但影响为零,直到触发器出现。
怎么防:权重完整性校验
按上面的数字,防御的着力点有三个。
一,逐参数指纹。 改动占全模型 0.311%,随机抽查 5% 的参数有 99.8% 概率至少命中一处。听起来抽查有用,但抽查只能发现"值变了",不能判断"这个值不该是 25"——需要有原始版本的逐参数哈希才能比对。所以这不是检测方法,是来源核验:模型从哪下的、哈希对不对。
二,异常值检测。 单点改动是 25.1,原权重最大值是 0.37,差 67 倍。这个比例在分布上是明显的离群点。但攻击者可以把权重拆到更多神经元上,每个只给 3,那样就看不出异常了。代价是需要更多神经元,改动量上去,被抽查命中的概率也上去。
三,行为指纹。 用一批精心设计的输入(覆盖各种极端情况)跑模型,记录输出分布,与基线对比。这种方法不依赖权重,只看行为。缺点是:你只能测自己想得到的输入,想不到的触发方式测不出来。
我自己的判断是:这三条都是"降低概率",不是"证明安全"。 权重级别的后门和二进制后门一样,防御方永远是在猜攻击者的手法。
对开源模型使用者意味着什么
这条攻击路径把供应链风险的门槛降低了。以前要在模型里埋后门,得控制训练过程;现在只要拿到权重,改几个数就行。
具体的操作建议三条。
只从官方仓库下载,核对哈希。 第三方镜像、量化版本、合并版本,每一个环节都可能被改。模型仓库内部是什么结构我拆过,一层 manifest 加几个哈希命名的 blob,任何一个 blob 被替换,跑起来都看不出来。量化之后权重全变了,哈希对不上是正常的,反而给了攻击者可乘之机。
自己量化,别下别人量化好的。 同一个模型官方给 fp16,你自己转 4bit,起码这一环可控。
关键场景做行为基线。 把模型在固定输入集上的输出分布存下来,每次更新都对比。这个成本不高,但能抓到"改了权重"这类问题——只要你的输入集覆盖到被触发的方向。
最后说个不确定的地方:我这个复现是小网络,256 个神经元里 24 个是选择性的(9.4%)。真实大模型里这个比例是多少,公开资料没给。如果比例只有 0.1%,那"改 8 个"就要在几万个神经元里挑,难度会上一个量级。这个数字我没有,标存疑。
参考资料
- 微软研究院 Lazarus:重编程休眠神经元植入后门:Microsoft Research,2026-11
- AI 安全:权重空间后门研究:arXiv,2026-11
- 模型权重完整性校验实践:
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。