
一句话总结:AI 芯片的单颗封装面积是传统芯片的 2–4 倍。用 Murphy 良率模型算,面积从 200mm² 涨到 800mm²,每片晶圆的良品数从 278 颗掉到 40 颗——面积涨 4 倍,良品数掉到 1/7。
这个数字解释了为什么先进封装产能是这轮 AI 硬件的真瓶颈。
不是"造不出来",是"造出来的废品太多"。而且废品的成本要摊到良品上,所以大芯片的单位成本涨得比面积快得多。
为什么 AI 芯片的封装面积是传统的 2-4 倍
三个原因叠在一起。
第一,算力靠堆核心。 一颗 HBM 旁边要放计算 die,计算 die 的晶体管数上去了,面积就下不来。现在的旗舰 AI 芯片单 die 已经接近光罩极限(约 858mm²),再大就得用 CoWoS 拼多颗 die。
第二,HBM 必须和计算 die 靠得极近。 HBM 的带宽来自超宽接口,走线长度直接影响信号完整性。所以 4 颗、6 颗甚至 8 颗 HBM 必须围着计算 die 摆,整个封装的面积是计算 die 的 2–3 倍。
第三,中介层(interposer)本身有尺寸限制。 CoWoS 的中介层是硅做的,尺寸受光刻机视场限制。台积电的 CoWoS-L 能到 3.3 倍光罩,再往上就要换方案。
所以"封装面积 2–4 倍"这个说法,指的是整个封装,不只是 die。而良率算的是 die 的面积——这两个数不能混。
下面算的是 die 面积,因为 die 才是在晶圆上切的。
Murphy 模型:面积怎么影响良率
良率和缺陷密度的关系,业界有几个模型。最常用的是 Murphy:
Y = ((1 - e^(-A·D)) / (A·D))²A 是 die 面积(cm²),D 是缺陷密度(defects/cm²)。这个模型的假设是缺陷在晶圆上随机分布,且良率对缺陷密度呈"先平后陡"的关系。
还有更简单的 Poisson 模型:Y = e^(-A·D)。它假设缺陷完全随机,算出来的良率比 Murphy 低(对大芯片更悲观)。实际用 Murphy 的居多,因为它和实测更接近。
import math

def dies_per_wafer(area_mm2, wafer_mm=300, edge=3.0):
    """12 寸晶圆可切 die 数,扣掉边缘不可用环"""
    r = (wafer_mm - 2 * edge) / 2
    return int(math.pi * r * r / area_mm2)

def murphy_yield(area_mm2, d0=0.10):
    """D 单位 defects/cm²,面积换算成 cm²"""
    ad = (area_mm2 / 100) * d0
    if ad < 1e-9:
        return 1.0
    return ((1 - math.exp(-ad)) / ad) ** 2

for area in (200, 400, 600, 800, 1000, 1200):
    n = dies_per_wafer(area)
    y = murphy_yield(area)
    print(f"{area:>5}mm²: 每片 {n:>4} 颗,良率 {y*100:>5.1f}%,良品 {n*y:>5.0f} 颗")
输出:
  200mm²: 每片  339 颗,良率  82.1%,良品   278 颗
  400mm²: 每片  169 颗,良率  67.9%,良品   115 颗
  600mm²: 每片  113 颗,良率  56.5%,良品    64 颗
  800mm²: 每片   84 颗,良率  47.4%,良品    40 颗
 1000mm²: 每片   67 颗,良率  40.0%,良品    27 颗
 1200mm²: 每片   56 颗,良率  33.9%,良品    19 颗
良率实测:从 200mm² 到 800mm²,良品数掉到 1/7
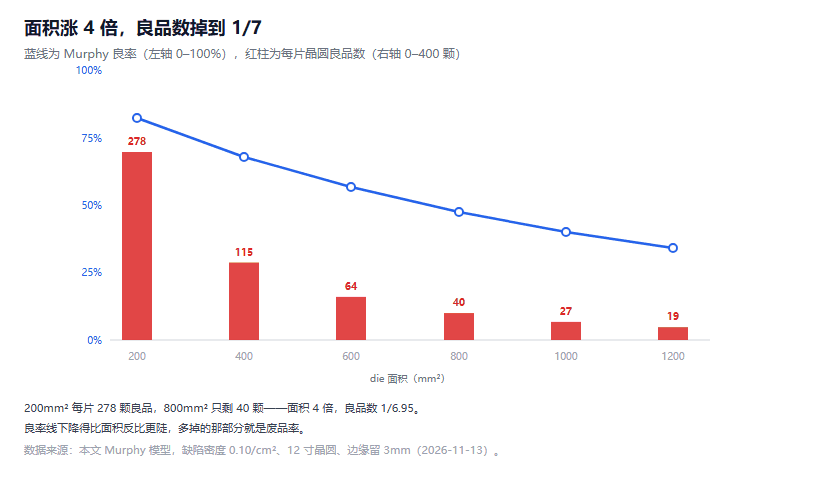
图 1:横轴为 die 面积,蓝线是良率,红柱是每片晶圆的良品数;两条曲线不是等比例下降
把上面两列放在一起看,就能看出问题的严重性。
面积从 200 涨到 800,是 4 倍。每片可切的 die 从 339 掉到 84,是 1/4.04——这个符合面积反比。
但良品数从 278 掉到 40,是 1/6.95。
多掉的那部分是良率:82.1% 降到 47.4%。
| 面积 | 每片 die 数 | 良率 | 良品数 | 相对 200mm² |
|---|---|---|---|---|
| 200mm² | 339 | 82.1% | 278 | 1.00× |
| 400mm² | 169 | 67.9% | 115 | 0.41× |
| 800mm² | 84 | 47.4% | 40 | 0.14× |
| 1200mm² | 56 | 33.9% | 19 | 0.07× |
这就是为什么大芯片贵得不合比例。 面积翻 4 倍,成本翻 7 倍,不是厂商加价,是废品率在吃。
而且这个模型还是乐观的——真实情况里,缺陷不是均匀分布的,大芯片更容易碰上"致命缺陷"。缺陷聚集(defect clustering)会让大芯片的实际良率比 Murphy 更低。
200 万颗要多少片晶圆
按 2026 上半年中国数据中心 AI 加速器出货 200.8 万颗做个量级估算。
假设这些芯片平均 die 面积 800mm²(这个假设很粗,实际有大有小),良率 47.4%:
200 万 ÷ 40 颗每片 = 50,251 片 12 寸晶圆五万片 12 寸晶圆是什么概念?一座中等规模的晶圆厂月产能大约 5 万片。也就是说,这批货要吃满一座厂一个月的全部产能。
当然这是极端简化:实际的 AI 芯片有大有小,也不全是这一种工艺。但这个量级说明一件事——芯片面积的每一次上涨,都在直接吃掉晶圆产能。
这也解释了为什么先进封装是瓶颈:之前的封装说明提到,AI 芯片尺寸持续增大,单颗高端 AI GPU 所需封装面积可达传统芯片的 2–4 倍。封装产能不是"不够用",是"被面积吃掉了"。
缺陷密度降一半,能省多少
这是全文最实用的一段。
上面算的是缺陷密度 D=0.10 的情况。如果工艺改进把 D 降到 0.05:
for d in (0.10, 0.08, 0.05, 0.03):
    y = murphy_yield(800, d)
    wafers = 2_000_000 / (dies_per_wafer(800) * y)
    print(f"D={d:.2f}: 良率 {y*100:.1f}%,需要 {wafers:,.0f} 片")
输出:
D=0.10: 良率 47.4%,需要 50,251 片
D=0.08: 良率 54.6%,需要 43,644 片
D=0.05: 良率 67.9%,需要 35,050 片
D=0.03: 良率 79.0%,需要 30,123 片
缺陷密度从 0.10 降到 0.05,良率从 47.4% 涨到 67.9%,晶圆需求降 30%。
单卡显存那篇算过同一个逻辑:装得越满跑得越慢,芯片也是越大越贵。两条曲线都不是线性的。
对比另一条路:把 die 面积从 800 缩到 600,良率涨到 56.5%,良品数 64 颗,需要 31,250 片——省 38%。
两条路的收益接近,但代价完全不同。
缩面积意味着牺牲性能(或者用 chiplet 拆),降缺陷密度意味着改工艺。工艺改进的周期长(一两年),但收益是持续的;缩面积是设计决策,一次性的。
我的判断是:在 AI 芯片这个场景,降缺陷密度的优先级应该高于缩面积。 因为面积直接对应算力,缩了就没竞争力;而缺陷密度是所有产品共享的基础能力。
chiplet 是不是解法
算到这儿,自然会问:把大 die 拆成几个小的,良率不就回来了?
算一下。一颗 800mm² 的芯片,换成 4 颗 200mm² 的 chiplet 拼起来:
small = dies_per_wafer(200) * murphy_yield(200)   # 每片 278 颗
big   = dies_per_wafer(800) * murphy_yield(800)   # 每片 40 颗
print(f"4 颗小 die 可组 {small/4:.0f} 套等效大芯片,单颗大 die 只有 {big:.0f} 颗")
输出:每片晶圆上,4 颗小 die 能组 69 套等效大芯片,单颗大 die 只有 40 颗。良率收益 1.75 倍。
这个收益是真实的,也是 chiplet 这几年被广泛采用的原因。AMD 从 Zen 2 开始就走这条路,现在几乎所有大芯片都在拆。
代价有三块:
封装成本。 4 颗 die 要放到一个中介层上,做 die-to-die 互联(用 UCIe 之类的标准)。这一层封装比单 die 贵得多,而且良率损失会叠加——任何一颗 die 坏了,整套封装报废。
互联功耗。 die 内部走线几乎不耗电,跨 die 走线要驱动,功耗和延迟都上一个台阶。这部分的代价取决于拆得多细。
设计复杂度。 拆完之后要处理一致性问题、缓存分层、任务调度。软件栈也要跟着改。
所以 chiplet 不是免费的午餐,是用封装成本和设计复杂度换良率。这笔账划不划算,取决于两个数:小 die 的良率收益,和封装的额外成本。
在 800mm² 这一档,良率收益 1.75 倍,封装成本大概涨 30%–50%,算下来是划算的。这也是为什么现在的高端 AI 芯片基本都是 chiplet 架构。
国产化率不足 10% 卡在哪
最后说国产化的部分。
有数据说 2026 年中国大陆先进封装有效产能占全球约 30.5%,但 2.5D/3D 高阶技术国产化率不足 10%。
这两个数字放在一起很说明问题:产能不少,高端能力缺。
2.5D/3D 封装的难点在三处:
一是中介层的制造。 硅中介层要做高密度布线(RDL),线宽线距在微米级,需要先进光刻。这一环国内还在爬坡。
二是 TSV(硅通孔)的良率。 垂直打孔穿透硅片,孔壁绝缘、填充铜,任何一步出问题整个封装报废。
三是大尺寸封装的翘曲控制。 封装面积越大,热膨胀系数不匹配导致的翘曲越严重。这个问题的解法是材料和工艺的经验积累,绕不过去。
所以"国产化率不足 10%"这个数字,卡的不是单一环节,是三个环节的良率叠加。任何一个环节 90% 的良率,三个串起来就是 73%。
这也意味着:先进封装的国产化不会是"某天突破",会是一个缓慢爬坡的过程。 每提升一个点的良率都要靠产线上的数据积累。
参考资料
- 先进封装产能与国产化率数据:上市公司募集说明书,2026-11-13
- Murphy 良率模型与缺陷密度:SEMI 行业标准资料
- CoWoS 封装技术说明:台积电 3DFabric
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。