
一句话总结:SII 那套预训练 RSI 里,agent 要收敛 130 多个基础设施版本。按几何分布算,单轮成功率 70% 时总调用 186 次,其中 12 个版本要修 3 轮以上;成功率掉到 50%,总调用涨到 260 次,难修的版本变成 33 个。
这个估算的价值不在于算出准确数字,在于看清成本结构:RSI 的成本不是线性的,尾部特别长。
平均值算出来的 186 次,掩盖了"大部分一次就好、少数反复失败"这个分布。而恰恰是那几个反复失败的,决定了整个流程能不能按时收敛。
为什么用几何分布算这个
修一个 bug、调一个配置、修一条数据管道,本质是重复独立尝试直到成功。这个过程的数学模型就是几何分布。
假设每次尝试独立的成功率是 p,那第一次就成功的概率是 p,第二次才成功的概率是 (1-p)p,第 k 次才成功是 (1-p)^(k-1) p。
期望尝试次数是 1/p。这个结论不需要模拟,直接可以算。
但期望值只是均值。真正要关心的是分布的形状:
# 单轮成功率 p,N 个版本要收敛
N = 130

print(f"{'p':>6}{'一次修好':>10}{'需≥3轮':>9}{'需≥5轮':>9}{'总调用':>9}")
for p in (0.9, 0.7, 0.5, 0.3, 0.15):
    once = N * p                    # 第一次就成功的版本数
    ge3  = N * (1 - p) ** 2         # 需要第 3 轮及以上的版本数
    ge5  = N * (1 - p) ** 4         # 需要第 5 轮及以上的版本数
    total = N / p                   # 总调用轮数期望
    print(f"{p:>6.2f}{once:>10.0f}{ge3:>9.1f}{ge5:>9.1f}{total:>9.0f}")
输出:
     p   一次修好    需≥3轮    需≥5轮    总调用
  0.90       117      1.3      0.0      144
  0.70        91     11.7      1.1      186
  0.50        65     32.5      8.1      260
  0.30        39     63.7     31.2      433
0.15 20 93.9 67.9 867这里有两个独立的量:总调用量(成本)和难修版本数(风险)。
单轮成功率决定 agent 调用的总量
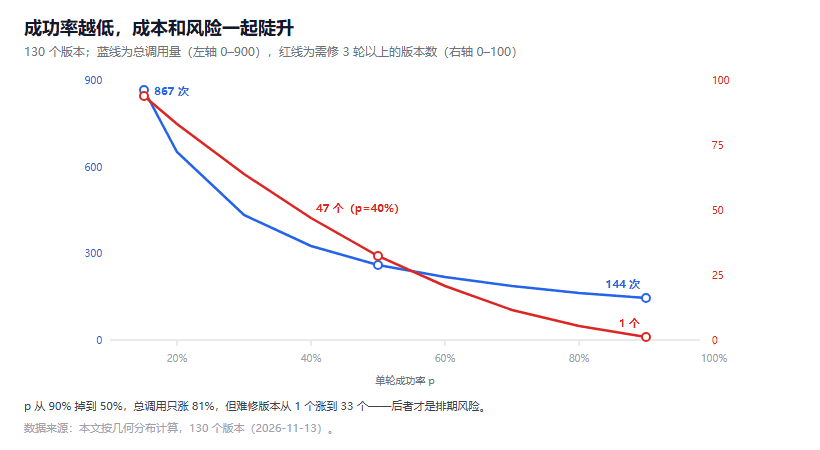
图 1:横轴为单轮成功率,蓝线是总调用量,红线是需修 3 轮以上的版本数;两条线在 p=0.5 附近都开始陡升
总调用量 = N/p,是个反比关系。p 从 90% 掉到 50%,总调用从 144 涨到 260,涨 81%。
但成本不只在调用次数上。每次调用都要消耗上下文、消耗 token、占用串行时间。所以 p 的下降是双重打击。
p 这个值受三个因素影响:
任务粒度。 一个版本里如果塞了 5 个改动,p 会显著低于只改 1 个。这是最可控的变量——把任务拆小,p 就上去了。
报错信息的质量。 agent 修 bug 靠的是错误信息。如果报错模糊("训练失败"),p 会很低;如果报错精确("第 3 层 attention 的维度不匹配"),p 会高很多。
可回滚性。 如果每次尝试都是干净的开始,p 稳定;如果上一次的错误改动残留,p 会越来越低。
第三条最容易被忽略,也是最致命的。
130 个版本里,多少要修 3 轮以上
按上表,p=70% 时有 12 个版本需要 3 轮以上;p=50% 时是 33 个。
这 12 个(或 33 个)为什么重要?
因为它们是串行的。130 个版本里,大部分可以并行处理,但那几个难修的会卡在那里,后面的版本依赖它们。整个流程的完成时间由最慢的那条链决定。
按 12 个难修版本、每个平均 4 轮算,光这部分就是 48 次调用,占总调用的 26%。如果它们还在关键路径上,时间占比会更高。
这个结构在软件工程里有个名字:长尾拖累。项目里 80% 的问题好解,20% 的问题吃掉 80% 的时间。
RSI 没有消除这个规律,只是把"人花的时间"换成了"agent 花的调用"。
尾部为什么危险:上下文会累积
这是我认为最值得说的部分。
假设一个版本修了 5 轮还没成。这 5 轮的对话都在上下文里:每次的报错、每次的修改方案、每次的失败原因。上下文会越来越长,而长上下文会让模型判断变差。
之前算过量化误差:噪声是累积的,不是平均的。上下文也一样——失败的尝试会污染后续的判断。
具体的恶性循环是这样:
- 第 1 轮失败,模型记住"方案 A 不行"
- 第 2 轮它试方案 B,也失败
- 第 3 轮它开始怀疑前提,试图同时改多个地方
- 第 4 轮改动叠加,报错变了,之前的线索失效
- 第 5 轮上下文里全是失败记录,模型开始瞎猜
所以真实系统的 p 不是常数,是随尝试次数递减的。上面那个几何分布的假设(每轮独立同分布)在长尾上不成立。
修正后的模型:p1 > p2 > p3 > ...,总调用量比 1/p 更大,尾部更肥。
工程上的应对是"重置上下文":修到第 3 轮还不行,就丢掉前面的记录,重新描述问题。这个做法的代价是丢掉了"哪些方案已试过"的信息,但避免了污染。
论文提到的"共享上下文基础设施保存负面结果",可能就是为了解决这个:把失败记录外置到库里,而不是留在对话里。 这样下一轮可以查"这个方案试过没有",而不用把所有失败对话都带着。
成本不在 token 上
186 次调用听起来多,折算成钱很少。
假设每次调用带 2 万 token 上下文(系统提示 + 报错 + 代码片段),186 次就是 372 万 token。按旗舰模型输入 8 元/百万算,总共 30 元。
30 元处理 130 个基础设施版本,这个价格说明:token 成本完全不是这套方法的瓶颈。
真正的成本在两处:
一是串行等待。 130 个版本里能并行的有限,难修的版本会卡住依赖链。一次调用几十秒到几分钟,186 次串起来是几小时到一整天。
二是人工审核。 agent 改完的配置要人看一眼才能上。130 个版本 = 130 次 review,按每次 5 分钟算是 11 小时。这个成本比 token 高三个数量级。
所以优化方向很清楚:该优化的是"减少需要人看的次数",不是"省 token"。 具体做法是提高一次通过率,让更多版本不需要人工介入。
什么时候值得用:agent 调用成本与收益
给三个判断标准。
一,p 能不能到 70% 以上。 低于 50%,130 个版本要 260 次以上调用,人工审核的负担会很重,还不如人直接干。p 能不能上去,取决于任务拆得够不够细、报错够不够清楚。
二,任务是不是可验证。 修 bug 有测试用例,跑一遍就知道成没成。这类任务最适合 agent。如果"成功"要靠人判断(比如文档写得好不好),那自动化的收益会大打折扣。
三,失败的成本有多高。 改配置失败了回滚就行,成本低;预训练 run 失败了,几十万 GPU 小时没了,成本极高。后者用 agent 要加多道人工闸门,那 p 的收益会被闸门的开销吃掉。
三条都满足,值得上。只满足一两条,先做小范围试点。
最后说个数字上的判断:130 个版本、186 次调用,这个规模不算大。 一个中型团队的 CI 一天跑的构建次数都比这多。所以这套方法的门槛不在调用量,在"能不能把专家的判断翻译成可自动验证的标准"。
这也和预训练 RSI 那篇的结论对上了:三类循环里最难的是"经验转指标",而它恰恰决定了 p 能到多高。
参考资料
- 在预训练中引入递归自我改进:SII GAIR 团队,2026-11
- 几何分布与重试策略的期望成本:基础概率论
- 长上下文对模型判断的影响:相关评测研究
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。