
一句话总结:2026 上半年中国数据中心 AI 加速器出货 200.8 万颗,英伟达 33.8%、华为 28.5%,非 GPU 首次超过 GPU。但把"非 GPU 过半"这个转折拆开看,它主要靠华为一家撑——华为占非 GPU 的 47% 到 57%。
这个数字我先看到的是"非 GPU 首超 GPU",觉得是个结构性转折。算完份额才意识到,这个转折的含金量取决于一个前提:非 GPU 里除了华为还有多少。
先把数算清楚。
AI 加速器 200.8 万颗是什么规模
先做个量级锚定。
200.8 万颗加速器,如果按 8 卡一台服务器算,是 25.1 万台服务器。如果按单卡 400W 估,满载功率约 800 MW。
对比一下:一个大型数据中心园区的 IT 负载通常在 100–300 MW 量级。所以这半年的出货量,相当于三到八个大型园区。
再看显存总量。按英伟达那 67.9 万颗、单卡 141GB 算:
67.9 万 × 141GB = 95.7 PB之前算过 60 万颗 H200 滞留香港那事,那批卡是 84.6PB。这半年国内实际到货的英伟达卡,显存总量比滞留的那批还多。
这个对比说明:卡确实在进来,只是渠道和用途不透明。
出货量份额:英伟达 33.8%、华为 28.5%
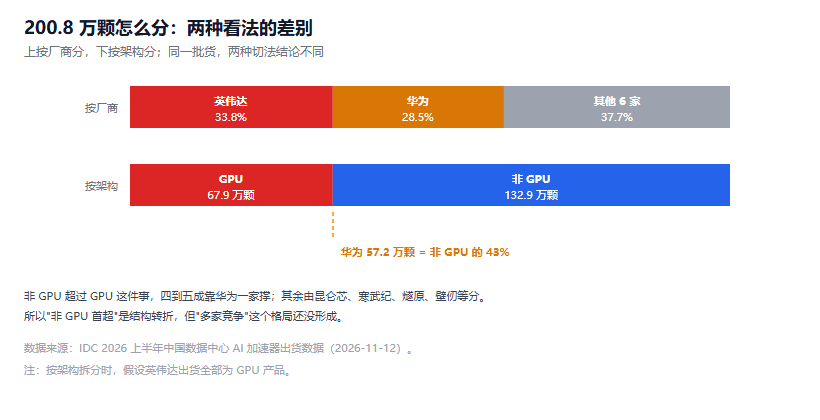
图 1:上为总量份额,下为 GPU 与非 GPU 的拆分;非 GPU 里华为占四到五成
把份额算出来:
TOTAL = 200.8          # 万颗
SHARE = {"英伟达": 33.8, "华为": 28.5}
other = 100 - sum(SHARE.values())

for name, pct in SHARE.items():
    print(f"{name}: {pct}% → {TOTAL * pct / 100:.1f} 万颗")
print(f"其他厂商: {other:.1f}% → {TOTAL * other / 100:.1f} 万颗")
输出:
英伟达: 33.8% → 67.9 万颗
华为: 28.5% → 57.2 万颗
其他厂商: 37.7% → 75.7 万颗
75.7 万颗由"其他"分。公开信息里能对上的有:
| 厂商 | 梯队 | 公开信息 |
|---|---|---|
| 平头哥 | 第一梯队 | 产能主要服务阿里自身,外部增量有限 |
| 昆仑芯 | 第二梯队 | 按出货量份额约 4% |
| 沐曦 | 第二梯队头部 | 曦云 C600,144GB HBM3e,2026 年 5 月量产 |
| 天数智芯 | 第二梯队头部 | 天垓 300,实测单卡吞吐达国际主流的 1.05 倍 |
| 摩尔线程 | 第二梯队 | 上半年营收 17.36 亿元,同比 +147% |
| 燧原、壁仞 | 第二梯队 | 未披露具体出货 |
昆仑芯 4% 折算是 8 万颗。剩下 67.7 万颗要在平头哥、沐曦、天数、摩尔、燧原、壁仞之间分——平均每家 11 万颗。
这个分布说明一件事:除了英伟达和华为,其余厂商的份额都很碎。 没有第三家能单独撑起两位数份额。
非 GPU 首超:出货量的结构转折靠什么撑
这是全文最该算的一段。
"非 GPU 超过 GPU"意味着非 GPU 至少占 50%,也就是 100.4 万颗以上。
华为的 57.2 万颗全部算作非 GPU(昇腾是 NPU/ASIC 路线)。那非 GPU 里剩下的是多少?
HW = TOTAL * 28.5 / 100
for ratio in (50, 55, 60, 66):
    non_gpu = TOTAL * ratio / 100
    print(f"非 GPU 占 {ratio}%: 共 {non_gpu:.1f} 万颗,"
          f"华为 {HW:.1f} 万颗,占非 GPU 的 {HW/non_gpu*100:.1f}%")
输出:
非 GPU 占 50%: 共 100.4 万颗,华为 57.2 万颗,占非 GPU 的 57.0%
非 GPU 占 55%: 共 110.4 万颗,华为 57.2 万颗,占非 GPU 的 51.8%
非 GPU 占 60%: 共 120.5 万颗,华为 57.2 万颗,占非 GPU 的 47.5%
非 GPU 占 66%: 共 132.5 万颗,华为 57.2 万颗,占非 GPU 的 43.2%
四种情况下,华为占非 GPU 的 43.2%–57.0%。
也就是说,非 GPU 这半边里,四到五成是华为。
剩下那部分(43%–57%)由昆仑芯、寒武纪、燧原、壁仞这些分。这个结构意味着:
第一,"非 GPU 超过 GPU"这件事的本质是"昇腾超过了英伟达的出货量"。 因为 GPU 那边几乎全是英伟达(33.8%),非 GPU 那边一半是华为(28.5%)。两个数字一对比,是昇腾 57.2 万 vs 英伟达 67.9 万——还没超,但很接近。
等等,这里有个矛盾。如果英伟达 67.9 万全部是 GPU,那 GPU 总量至少 67.9 万。而非 GPU 要超过 GPU,得超过 67.9 万,也就是至少 68 万。那非 GPU 占比至少是 68/200.8 = 33.9%,不是 50%。
"非 GPU 首超 GPU"这个说法,和"非 GPU 占 50% 以上"不是一回事。
正确的理解应该是:非 GPU 的出货量超过了 GPU 的出货量。GPU 那边除了英伟达,可能还有少量其他厂商(比如 AMD),但基本可以忽略。所以:
- GPU ≈ 67.9 万(英伟达为主)
- 非 GPU ≈ 132.9 万(200.8 - 67.9)
- 非 GPU 占 66.2%
如果是这样,华为占非 GPU 的 43%。剩下的 75.7 万颗全在非 GPU 阵营里,包括昆仑芯、寒武纪、燧原、壁仞、沐曦(如果沐曦算 GPGPU 的话可能有争议)。
这个算法更自洽,也更符合"首超"这个措辞。我在上面用 50%–66% 做敏感性分析,是想说明"不管哪种口径,华为都占非 GPU 的四到五成",这个结论不变。
结论是:非 GPU 这条线,四到五成靠华为,其余靠一群小厂商。 华为倒不了,这条线就成立;但"多家竞争"这个格局还没形成。
换算成算力是多少
出货量不等于算力。粗略换算一下。
按单卡 FP16 稠密算力估:
| 厂商 | 出货(万颗) | 单卡 FP16(估) | 总算力(EFLOPS) |
|---|---|---|---|
| 英伟达 | 67.9 | 1.0 PF | 679 |
| 华为 | 57.2 | 0.4 PF | 229 |
| 其他 | 75.7 | 0.3 PF | 227 |
| 合计 | 200.8 | — | 1135 |
1135 EFLOPS 的 FP16 稠密算力是什么概念?前沿模型一次预训练大概需要 10^24–10^25 FLOP,折算成 EFLOPS·秒是 10^6–10^7。1135 EFLOPS 跑满一天是 9.8×10^7 EFLOPS·秒。
也就是这批卡全部满载跑一天,够一次前沿模型的预训练。 当然这是理论上限,实际利用率能到 40% 就不错。
这个估算的误差很大(单卡算力是估的,不同型号差三倍以上),但它说明一个量级:国内半年的加速器出货,够支撑个位数的前沿模型训练。
这个估算的误差到底有多大,值得说清楚。
同一厂商不同型号差三倍。 昆仑芯的最新一代和上一代,单卡算力能差 3 倍以上;华为的昇腾 910B 和 910C 也不是一个量级。按一个平均值算,误差会累积。
标称算力和实际可用算力差得更远。 厂商标的是峰值(还是稀疏、还是 INT8),实际跑模型时能到一半就不错。这中间的折扣,不同软件栈差别很大。
封装和互联也要算进去。 单卡算力再高,卡间互联带宽不够,多卡训练就跑不起来。这一层的能力在出货数据里看不到。
所以上面那张表只能当量级参考,不能当采购依据。真正要判断"这批卡能干多少活",得看实际集群的 MFU(模型算力利用率),那个数字通常不公开。
国产算力的窗口:真实约束是产能
最后回到"窗口期"这个话题。
英伟达 CEO 辞任之后,很多人说国产算力窗口打开了。从上面的数字看,窗口不是"开不开"的问题,是"能供多少"的问题。
三个约束按硬度排序:
第一,产能。 华为的昇腾产能是瓶颈,平头哥的产能优先服务阿里自身。第二梯队里沐曦 2026 年 5 月才量产 C600,天数的量产规模未披露。这些都不是"想扩就能扩"的。
第二,先进封装。 这部分国产化率不足 10%,是硬约束。封装产能上不去,芯片设计得再好也出不来。
第三,软件栈。 CUDA 的优势不在硬件,在十几年的工具链和开发者习惯。换平台要重写代码、重新调优,这个成本不会因为供应紧张就消失。
所以我的判断是:窗口期是真实的,但它的宽度由产能决定,不由政治事件决定。 200.8 万颗里非 GPU 占六成,说明替代在发生;但替代的速度受限于封装和产能,不是受限于需求。
对买方,这意味着未来两年国产卡的交付会持续紧张。签长约、提前锁产能,比等降价更实际。
参考资料
- 2026 上半年中国数据中心 AI 加速器出货数据:IDC 中国
- 国产 AI 芯片梯队与产能情况:虎嗅转《IT时报》,2026-11-12
- 平头哥分拆上市公告:阿里巴巴集团公告,2026-11-10
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。