
一句话总结:B300 单卡 288GB HBM3e、8TB/s 带宽、2.25 PFLOPS FP16 稠密算力。288GB 意味着 4bit 下能装 576B 参数,听起来"单卡跑大模型"成立了。但按带宽算,装得下不等于跑得动——200B 模型单卡 batch=1 只有 80 token/s。
先把三个数字的关系理清楚,因为这类规格表最容易被读成"越大越好"。
288GB、8TB/s、2.25 PF,三者分别对应三个不同的瓶颈:装不装得下、读得快不快、算得过来没有。大多数时候卡住的是第二个。
B300 的 288GB 显存是个什么位置
拿同代产品的显存做个位置参照:
| 型号 | 显存 | 带宽 | FP16 稠密 |
|---|---|---|---|
| H200 | 141GB | 4.8 TB/s | 约 1 PF |
| B300 | 288GB | 8 TB/s | 2.25 PF |
| 沐曦 C600 | 144GB | 未公开 | 未公开 |
288GB 是 H200 的 2.04 倍。这个倍数不是随便来的——它刚好够把"两张卡才能装的模型"变成"一张卡能装"。
这句话的实际含义要展开说。现在主流的大模型训练和推理,如果一个模型的权重超过单卡显存,就要做张量并行(TP)或流水并行(PP)。切分带来的代价是卡间通信:每一层的矩阵乘都要同步,通信量和模型宽度成正比。
跨卡切分的成本不只在延迟,还在可靠性。 8 卡并行意味着任何一张卡出问题整个任务就崩,故障率是单卡的 8 倍。这一点在长时间训练里非常要命。
所以 288GB 的真实价值不是"参数多",是"少切一刀"。
单卡能装的模型上限
按不同精度算,288GB 对应的参数量上限:
| 精度 | 每参数字节 | 288GB 对应参数量 | 典型模型 |
|---|---|---|---|
| FP16 / BF16 | 2 | 144B | 中型稠密模型 |
| FP8 | 1 | 288B | 大稠密模型 |
| FP4 | 0.5 | 576B | 巨型 MoE |
这是纯权重的理论上限,实际要留出 KV cache、激活值、框架开销,可用空间大概 250–260GB。
按 4bit 算,能装 500–520B 参数的模型。参照 Kimi K3.1 Pro 的 1.56TB,那个规模要 8 卡 H200 都装不下;500B 这一档,单卡刚好。
再算 KV cache 的账。假设一个 200B 的稠密模型(4bit 权重占 100GB),剩下约 160GB 给 KV:
每 token KV = 2(K和V) × 60 层 × 8 个 KV 头 × 128 维 × 2 字节
            = 245 KB
160 GB / 245 KB ≈ 65 万 token
65 万 token 的上下文窗口,这个数字很夸张——比现在主流模型的 128K 大五倍。
所以从"装得下"这个维度看,288GB 已经把上下文长度的瓶颈推到很远的地方了。真正的限制在别处。
单卡不用切分:三个收益和一个代价
三个实际收益,按重要性排。
第一,通信开销归零。 张量并行下每层都要做 AllReduce,通信量随 hidden size 增长。单卡不用通信,等于把这块延迟直接删掉。对小 batch 的推理,通信开销占比能到 30% 以上。
第二,故障域缩小。 单卡跑,坏了重启一个进程;8 卡跑,坏了要重建整个通信组。这个差别在需要跑几天的任务上是决定性的。
第三,部署简单。 单卡就是一台机器,不用考虑 NVLink 拓扑、不用调 rank 映射。运维成本降一个量级。
代价也很清楚:单卡的算力上限就是整个系统的上限。 8 卡并行虽然通信贵,但算力是 8 倍。训练大模型时,单卡装得下也没用,因为算不过来。
所以 288GB 这个配置,天然是给推理用的,不是给训练用的。
8 TB/s 带宽决定了单卡能跑多快
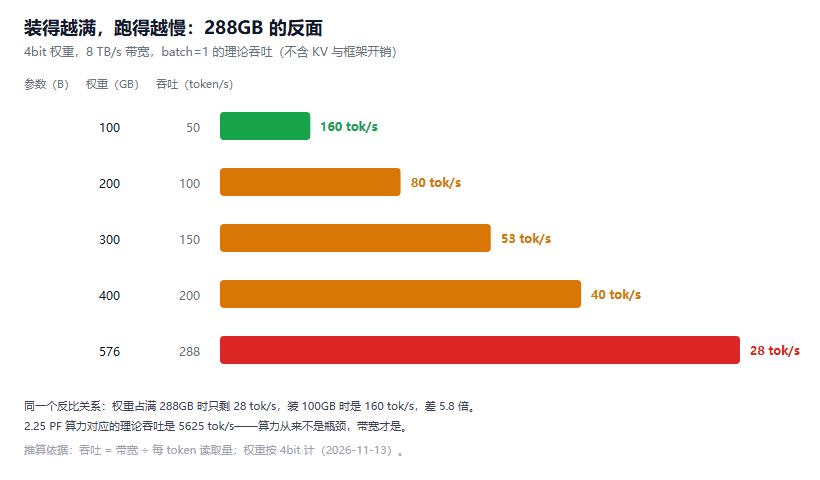
图 1:4bit 权重下,模型越大每 token 读得越多,单卡吞吐按反比下降
这是全文最该记的一段。
推理的解码阶段(生成下一个 token)是内存带宽受限的,不是算力受限。因为每生成一个 token,都要把参与计算的权重从显存读一遍。
算一笔:200B 稠密模型、4bit 权重 100GB、8TB/s 带宽:
单个 token 要读 100 GB 权重
100 GB ÷ 8 TB/s = 12.5 毫秒
→ 单卡理论吞吐 80 token/s(batch=1,零开销)
80 token/s 是什么水平?比人阅读快,比大部分在线服务的期望慢。如果 batch 开到 8,总吞吐能到 600 以上,但单请求延迟不变(甚至略升)。
再看算力:2.25 PFLOPS FP16,200B 模型每 token 需要约 400 GFLOP(2 × 参数量)。2.25 PF ÷ 400 GF = 5625 token/s。
算力能撑 5625,带宽只给 80。 差了 70 倍。
这个对比说明一件事:买这种卡做推理,瓶颈永远在带宽上,加算力没有意义。 厂商把算力堆到 2.25 PF,是为了训练和 prefill 阶段(那个阶段是算力受限),不是为了解码。
对使用者的含义:选卡的时候,每 GB 显存对应的带宽比总算力更能预测推理表现。
| 型号 | 显存 | 带宽 | 每 GB 带宽 |
|---|---|---|---|
| H200 | 141 GB | 4.8 TB/s | 34 GB/s |
| B300 | 288 GB | 8 TB/s | 28 GB/s |
B300 的每 GB 带宽反而比 H200 低。原因是显存涨得比带宽快——HBM 容量可以堆栈数,带宽受封装和引脚限制。
这意味着:装得越满,跑得越慢。 288GB 塞满 576B 模型,每 token 要读 288GB,8TB/s 下是 36ms,27 token/s。这个速度只能做离线批处理,做不了交互。
所以合理的用法是"装一半、留余量":200B 左右的模型 + 大 KV,既保住了单卡不切分,又不至于慢到不可用。
14 PFLOPS FP4 的口径要看清楚
官方规格里还有一组数字:14 PFLOPS FP4 稀疏算力。
从 2.25 PF FP16 稠密到 14 PF FP4 稀疏,是 6.22 倍。理论倍数应该是多少?
FP16 → FP4:位宽减 4 倍,算力理论 ×4
稠密 → 稀疏:结构化稀疏 2:4,理论 ×2
合计:×8
8 倍对 6.22 倍,差 22%。
这个差额有三解释:FP4 的实际稠密倍率不是 4 倍(可能是 3.5 倍)、稀疏利用率不到 2 倍、或者两个数字的测量条件不同(比如是否含 sparsity 的编译器开销)。
这类规格表的数字不能直接相乘对比。 14 PF 和 2.25 PF 是两个不同口径下的峰值,前者需要模型本身是稀疏的、并且编译器能利用上,后者是稠密算力。拿 14 除以 2.25 得出"6 倍性能",在真实模型上大概率拿不到。
我看到的这组数字来自二手转述,没找到官方规格表原文。如果要用这个数字做采购决策,先去 NVIDIA 官网核对 datasheet,别用媒体报道的数字。
B300 采购:显存与带宽怎么取舍
三条判断。
一,288GB 解决的是"能不能单卡跑",不是"跑得快不快"。 如果你的场景是离线批处理、长上下文、模型刚好在 200B 上下,单卡有价值。如果是低延迟在线服务,小模型多卡更划算。
二,别按显存买卡,按带宽买卡。 推理的吞吐上限由"总带宽 ÷ 每 token 读取量"决定,这个比值才是硬指标。288GB 但每 GB 带宽下降,是这次规格里最容易被忽略的一点。
三,单卡方案的隐藏收益在运维。 不用调并行、不用管拓扑、故障域小。这部分收益不进 benchmark,但进了总拥有成本。之前算过算力租赁的摊销,运维人力在自建机房的成本里占比不低,单卡方案能省掉一部分。
最后说个我不确定的点:288GB 的封装是怎么做到的。HBM3e 单堆栈 24GB,288GB 需要 12 个堆栈,这个数量对封装面积和良率都是挑战。如果实际是 8 堆栈 × 36GB 或者其他组合,那带宽计算要重做。这层信息我没查到。
参考资料
- NVIDIA B300 规格与定位:NVIDIA 官方产品页
- B300 在训练与推理场景的参数:行业媒体报道,2026-11
- HBM3e 堆栈规格与带宽:SK 海力士产品文档
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。