
一句话总结:沐曦曦云 C600 标 144GB HBM3e。这个容量有 4×36GB 和 6×24GB 两种标准拆法,对应的带宽是 4.8 和 7.2 TB/s,差 50%。规格表只给容量不给堆栈数,所以从公开信息推不出它的带宽。
这个数字值得反推,因为"144GB"是个非常规容量。主流配置是 80GB、141GB、192GB、288GB,144 正好卡在中间。
厂商选这个数字,一般不是为了"刚刚好",是为了"用整数个标准堆栈"。
144GB 能拆成几种 HBM 组合
按 HBM 标准堆栈容量拆解:
total = 144
combos = []
for stack_gb in (16, 18, 24, 32, 36):
    if total % stack_gb == 0:
        combos.append((stack_gb, total // stack_gb))
for gb, n in combos:
    print(f"{n} 个 {gb}GB 堆栈 = {total}GB")
输出:
9 个 16GB 堆栈 = 144GB
8 个 18GB 堆栈 = 144GB
6 个 24GB 堆栈 = 144GB
三种组合都能凑出 144。但只有一种符合主流 HBM3e 的规格:
| 组合 | 是否标准堆栈 | 说明 |
|---|---|---|
| 9 × 16GB | 16GB 是 HBM3 规格,不是 3e | 可能性低 |
| 8 × 18GB | 18GB 不是标准堆栈容量 | 可能性低 |
| 6 × 24GB | 24GB 是 HBM3e 8-hi 标准 | 可能 |
| 4 × 36GB | 36GB 是 HBM3e 12-hi 标准 | 可能 |
HBM3e 的标准堆栈是 24GB(8 层堆叠)和 36GB(12 层堆叠)。16GB 属于上一代 HBM3,18GB 不在标准序列里。
所以现实的可能只有两种:6 个 24GB,或者 4 个 36GB。
这里就出现问题了——这两种配置的性能差很多,而 144GB 这个数字本身分辨不出是哪一种。
一个旁证:H200 是 141GB,用的正是 6 个 24GB 堆栈(标称 144,实际可用 141,留 3GB 给 ECC 和保留区)。C600 标 144GB 可能是标称值,也可能没留那部分。但这只是旁证,不能当结论。
四种拆法对应的带宽差多少
带宽由堆栈数和每堆栈带宽决定。
HBM3e 每堆栈的带宽约 1.2 TB/s(24GB 8-hi)。按这个算:
per_stack_bw = 1.2   # TB/s,HBM3e 单堆栈(1024-bit 接口)
for n in (4, 6, 8, 9):
    print(f"{n} 堆栈 × {per_stack_bw} TB/s = {n * per_stack_bw:.1f} TB/s")
输出:
4 堆栈 × 1.2 TB/s = 4.8 TB/s
6 堆栈 × 1.2 TB/s = 7.2 TB/s
8 堆栈 × 1.2 TB/s = 9.6 TB/s
9 堆栈 × 1.2 TB/s = 10.8 TB/s
4 堆栈是 4.8 TB/s,6 堆栈是 7.2 TB/s,差 50%。
这个差距对推理影响很大。按 B300 那篇的算法,单卡吞吐 = 带宽 ÷ 每 token 读取量。如果显存装满 144GB、用 4bit 权重:
144 GB ÷ 4.8 TB/s = 30 ms/token → 33 token/s
144 GB ÷ 7.2 TB/s = 20 ms/token → 50 token/s
差 17 token/s,接近一倍。对在线服务,这是能用和不能用的区别。
所以"144GB"这个数字单独看没意义,得配上堆栈数才能算性能。而堆栈数恰恰是规格表里最常省略的一项。
对照 H200 和 B300
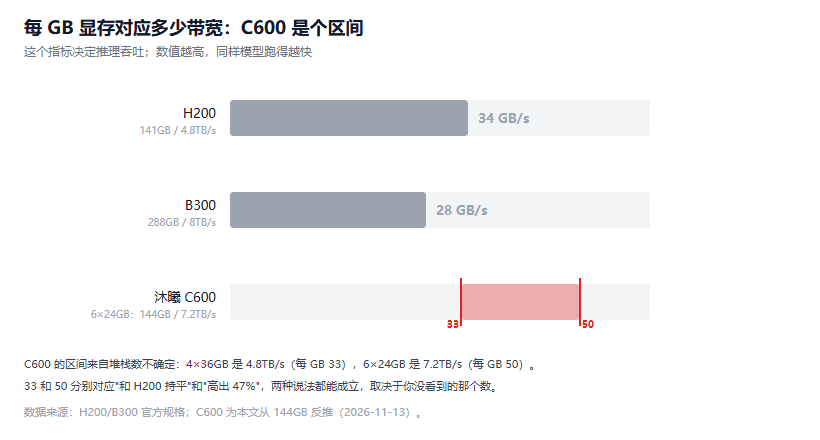
图 1:C600 的带宽取决于堆栈数,两种配置分别落在 33 和 50 两个位置
把三家放在一起,每 GB 显存对应的带宽这个指标就出来了:
| 型号 | 显存 | 带宽 | 每 GB 带宽 | HBM 配置 |
|---|---|---|---|---|
| H200 | 141 GB | 4.8 TB/s | 34 GB/s | 6 × 24GB |
| B300 | 288 GB | 8 TB/s | 28 GB/s | 待确认 |
| 沐曦 C600 | 144 GB | 4.8 或 7.2 TB/s(推) | 33 或 50 GB/s | 4 × 36GB 或 6 × 24GB(推) |
这两种配置的每 GB 带宽差 50%:33 对 50。
如果 C600 是 6 × 24GB,它的带宽密度和 H200 持平甚至略高(50 对 34,高 47%);如果是 4 × 36GB,就是 33,和 H200 基本一样。
换句话说,144GB 这个数字推不出带宽密度的高低。
这和我一开始的预期不一样。我原以为"144GB 这个非常规容量一定是为了某个优化",算完发现它可能只是"用 4 个 36GB 堆栈凑出来的整数"——那个配置在带宽上没有任何优势,只是省了堆栈数(封装成本低)。
同一个容量,可以是"为了带宽"(6×24),也可以是"为了成本"(4×36)。 规格表只给容量,刚好把最关键的信息藏了。
两种配置背后的取舍
为什么会有"4 个 36GB"和"6 个 24GB"两条路?因为容量和带宽不是同一件事,厂商要选一个。
4 × 36GB 走的是"省封装"路线。 堆栈数少两个,中介层上的布线简单、良率高、成本低。代价是带宽只有 4.8 TB/s——因为总位宽等于堆栈数乘每堆栈的 1024 位,少两个堆栈就少 2048 位。
6 × 24GB 走的是"保带宽"路线。 多两个堆栈,宽度够了,但中介层更大、良率更低、成本更高。
这个取舍在国产卡上更明显。原因有两层:
第一,先进封装产能紧张,国产化率不足 10%,能拿到的中介层面积有限。少两个堆栈,等于少占一块稀缺资源。
第二,训练场景更吃带宽,推理场景更吃容量。如果目标客户是推理部署,4×36 的配置够用;如果要做训练,6×24 才有意义。
所以"144GB"这个数字背后,藏着一个产品定位的选择。同一个容量,面向推理和面向训练,配置可能完全相反。
这也是为什么规格表只给容量:容量是客户直接关心的(能不能装下模型),堆栈数是工程实现,讲出来反而暴露了取舍。
每 GB 带宽这个指标为什么重要
因为它直接决定推理吞吐,而且是唯一一个"越大越好"的密度指标。
推理的解码阶段是内存带宽受限的(算过),每生成一个 token 要把参与计算的权重读一遍。所以:
吞吐 ≈ 带宽 ÷ 每 token 读取量 = 带宽 ÷ (激活参数量 × 每参数字节)分母由模型决定,分子由卡决定。两张卡比推理性能,比的就是带宽。
那为什么还要看"每 GB 带宽"而不是直接看带宽?因为显存容量决定了"能装多大的模型",两个指标要一起看:
- 带宽高但显存小:只能跑小模型,大模型要切分
- 显存大但带宽低:能装大模型,但跑得慢(B300 就是这种情况)
每 GB 带宽衡量的是"单位显存能换来多少速度",是性价比的方向。
对采购,合理的判断顺序是:先按模型大小定显存下限,再在这个下限之上选每 GB 带宽最高的。但 C600 这个案例说明,光看规格表连这一步都做不了——144GB 背后可能是 33 也可能是 50,差 50%。
反推的边界:哪些显存参数推不出来
说清楚这个反推能得出什么、不能得出什么。
能推的: 堆栈数(从容量反推)、带宽量级(从堆栈数乘单堆栈带宽)、每 GB 带宽的相对位置。
推不出的:
一是实际带宽。 即使确定了堆栈数,标称值也是理论峰值,实际能到 80% 就不错。不同访问模式(连续读写 vs 随机)效率差很多。
二是互联能力。 单卡带宽高,多卡互联带宽不够,训练还是跑不起来。这一层规格表里通常不写,要看 NVLink 对标方案。
三是封装形式。 6 个堆栈是怎么摆的(2.5D 中介层?硅桥?),决定了封装成本和产能。这个信息只有拆解报告才有。
四是软件栈的实际效率。 同样的硬件,不同软件栈跑出来的吞吐能差一倍。这一层是国产卡最大的不确定性,也是最难从规格反推的。
所以看到"144GB"这个数字,能确定的只有"容量级别"。带宽要从堆栈数推,堆栈数要从封装形式推,而封装形式不公开——这条链条在第二环就断了。
这篇的结论和它开头想的不一样。我本来想反推出"国产卡在带宽密度上领先",算完发现推不出来。逆向工程的常态就是这样:大部分时候你能确定的,比你以为的少。 承认这一点,比硬给一个结论有价值。
参考资料
- 沐曦曦云 C600 产品信息:沐曦官方
- HBM3e 堆栈规格与带宽:SK 海力士产品文档
- 国产 AI 芯片梯队与量产情况:虎嗅转《IT时报》,2026-11-12
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。