
一句话总结:B300 的规格里同时给了 FP16 稠密 2.25 PFLOPS 和 FP4 稀疏 14 PFLOPS,两者相差 6.22 倍。理论倍数应该是 8 倍(位宽减 4 倍 × 稀疏 2 倍)。差的 22% 说明至少有一档的口径和标称不一样。
这类规格表最容易被误读的地方,就是拿两个峰值直接相除,得出"性能提升 6 倍"。
实际上 6.22 这个数字本身没错,错的是把它当成"同一个模型上快 6 倍"。
官方给的三个算力数字
先把已知的列清楚:
| 指标 | 数值 | 口径 |
|---|---|---|
| FP16 / BF16 稠密 | 2.25 PFLOPS | dense,不含稀疏 |
| FP4 稀疏 | 14 PFLOPS | sparse,含 2:4 结构化稀疏 |
| 显存 | 288 GB HBM3e | — |
| 带宽 | 8 TB/s | — |
三个算力相关数字里,只有两个算力。缺的是 FP8 和 FP4 稠密——这两个档位如果给了,就能判断 14 PF 到底怎么来的。
只给"最好看的那个数",是硬件规格表的惯例。 FP4 稀疏是四档里数字最大的,所以放在显眼位置。
算力的理论倍数 8 倍是怎么来的
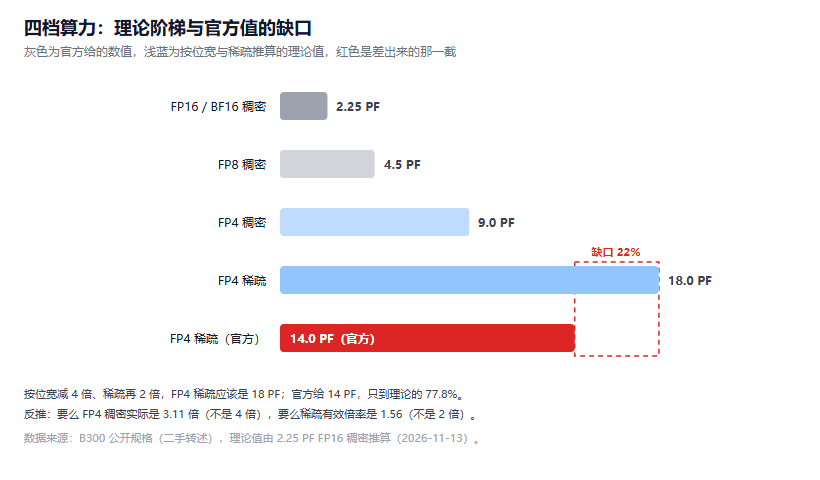
图 1:按位宽与稀疏的理论倍数推算,FP4 稀疏应为 18 PF,官方给的是 14 PF
从 FP16 稠密到 FP4 稀疏,中间有两级放大:
第一级:位宽从 16 位降到 4 位,理论上算力 ×4
第二级:从稠密变稀疏(2:4),理论上算力 ×2
合计:×8
这个 4 倍和 2 倍都是"理论值",前提是硬件在每一档都能跑满。
算一下理论值应该是多少:
fp16_dense = 2.25      # PFLOPS
theoretical = {
    "FP8 稠密":  fp16_dense * 2,
    "FP4 稠密":  fp16_dense * 4,
    "FP4 稀疏":  fp16_dense * 8,
}
for k, v in theoretical.items():
    print(f"{k}: {v:.2f} PFLOPS")

actual = 14.0
print(f"\n官方 FP4 稀疏: {actual} PFLOPS")
print(f"理论值:        {theoretical['FP4 稀疏']:.2f} PFLOPS")
print(f"实测/理论 = {actual / theoretical['FP4 稀疏']:.3f}")
输出:
FP8 稠密: 4.50 PFLOPS
FP4 稠密: 9.00 PFLOPS
FP4 稀疏: 18.00 PFLOPS

官方 FP4 稀疏: 14.0 PFLOPS
理论值:        18.00 PFLOPS
实测/理论 = 0.778
18 对 14,差 22%。
实测 6.22 倍:算力缺的 22% 在哪
反推一下:14 PF 稀疏算力,如果稀疏真的是 2 倍,那对应的稠密是 7 PF。
而 FP4 稠密按 4 倍理论应该是 9 PF。
7 对 9,差 22%。 这个差额只能出在两处之一:
要么 FP4 的稠密倍率不是 4 倍。 如果实际是 3.11 倍(7/2.25),那一切都对上了。这意味着 FP4 的硬件实现效率没有达到位宽减半的理论值。
要么稀疏的有效倍率不到 2 倍。 如果 FP4 稠密确实是 9 PF,那 14/9 = 1.56,稀疏只贡献了 1.56 倍而不是 2 倍。
两种解释在工程上都成立。区别在于:如果是第一种,说明 FP4 的硬件效率有问题;如果是第二种,说明稀疏的编译器支持不到位。
从公开信息看,我倾向于第二种。原因:2:4 稀疏要求模型权重本身是稀疏的,而且编译器要能识别并利用。这两个条件在实际模型上很少同时满足。厂商标的"稀疏算力"通常是硬件峰值,不是实测值。
三种可能的解释
把上面的分析列成三条,按可能性排序。
解释一:稀疏是硬件峰值,实际用不上。
2:4 结构化稀疏要求每 4 个权重里有 2 个是零且位置固定。预训练出来的模型不满足这个条件,要人为剪枝,剪完通常掉点。所以"稀疏算力"这个数字,在跑标准模型时是用不到的。
这一条最能解释为什么差 22%:厂商标的是"如果你能把模型剪成 2:4 稀疏,理论上能达到",不是"跑任何模型都这么快"。
解释二:FP4 的硬件实现效率低于理论。
位宽减半,理论上算力翻倍,但实际受限于数据搬运、累加器位宽、指令发射。FP4 的累加通常还是 FP16 或 FP32,这部分开销固定,所以实际倍率会低于 4 倍。
解释三:两个数字的测量条件不同。
FP16 稠密可能是"理想条件"下的峰值(大矩阵、无依赖),FP4 稀疏可能是"实测"值。两个不同条件下的数字放一起,倍数就没有意义。
我判断解释一的权重最高。因为稀疏算力在业界一直是"标称大于实用"的典型,各家的做法都一样。
为什么厂商都爱标稀疏算力
这个问题值得单独说,因为它解释了口径为什么改不了。
稀疏算力的数字天生是稠密的 2 倍。同样一颗芯片,标稠密是 7 PF,标稀疏就是 14 PF。PPT 上差一倍,成本没变。
这在行业里形成了一个循环:A 家标稀疏,B 家不标就显得弱,于是 B 家也标;标完之后谁都不敢退回稠密口径,因为数字会"腰斩"。
结果是:规格表上的算力数字,和实际能跑出来的性能,差距越拉越大。
对采购方,这意味着一件事:不同厂商的"峰值算力"不能直接比。 一家标稀疏、一家标稠密,数字差一倍但实际性能可能一样。
可用的替代指标是 MLPerf 的推理/训练成绩——那个是在真实模型上测的,各家口径统一。虽然也有优化空间,但至少不会出现"标 14 用 7"这种落差。
怎么核对:找规格表
上面所有推算都基于二手数据。要核实,得看官方 datasheet。
需要确认的四件事:
一,FP8 稠密的算力是多少。 如果 FP8 稠密是 4.5 PF(正好 2 倍),说明位宽减半的倍率是线性的,FP4 稠密应该是 9 PF,那差的就是稀疏那一档。
二,有没有单独标 FP4 稠密。 有些规格表会分开列"dense"和"sparse",这样一眼就能看出差在哪。
三,稀疏的单位是 2:4 还是别的。 不同的稀疏模式,有效倍率不一样。
四,这些数字是 chip 级还是 module 级(多芯片封装)。 一个 module 里可能有多个 die,标称算力是合起来的。
我看到的这组数据来自行业媒体的转述,没找到官方规格表原文。这本身也是个提醒:二手转述在数字上出错的概率不低,尤其是单位和小数点。
这类口径问题的普遍性
这种"峰值算力对不上"的情况,在硬件规格里很常见。
之前算过 B300 的显存与带宽,也发现同样的问题:288GB 显存听着大,但每 GB 带宽反而比 H200 低。单看一个数字都会误判。
再看沐曦 C600 的 144GB,那个数字要反推 HBM 堆叠组合才能确认带宽。
共同点:厂商标的是"最好的那个数",用户要用的是"实际能拿到的那个数",中间隔着口径。
实用的判断方法有三条:
第一,同档位比较。 稠密比稠密,稀疏比稀疏。跨档位相除得出的倍数,只能当上限看。
第二,看有没有给全套。 如果只给了一档,说明其他档位不够好看。给全套规格的厂商,可信度更高。
第三,找"实测"而不是"峰值"。 MLPerf 这类第三方基准测的是实际跑模型的表现,比峰值算力有用得多。虽然 MLPerf 也有优化的空间,但至少是在真实模型上测的。
最后说个数字上的直觉:如果 14 PF 这个数字真能在实际模型上跑到,那 B300 跑推理的吞吐应该是 H200 的好几倍。 但从带宽算,288GB 装满时只有 28 token/s(算过),比 H200 装 141GB 时还慢。
两个结论矛盾的地方,就是口径藏身的地方。
参考资料
- NVIDIA B300 规格参数:NVIDIA 官方产品页
- B300 训练与推理参数报道:行业媒体,2026-11
- 2:4 结构化稀疏说明:NVIDIA 开发者博客
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。