
一句话总结:Anthropic 的 Mythos 5.5 被报道用 53 分钟独立攻破 Linux 内核、拿到最高权限,这个模型只对少数网安机构开放。数字本身我没法核实,但把漏洞研究拆成侦察、假设、验证、串链四步之后,AI 到底强在哪、人还剩下什么,就清楚了:它赢在能不知疲倦地验证,人赢在判断哪个洞值得挖。
一、先把那 53 分钟放回语境
这条消息的来源是二手报道,Anthropic 官方没公布细节。53 分钟这个数字,我标为存疑。
但有一点是确定的:这类能力已经不是概念验证。同一批报道里提到,无护栏的特种版本只向顶尖网安和科研机构开放,面向大众的 Fable 5.5 做了限制。
厂商愿意为一个能力专门做分层,说明它已经真实存在,而且威力不小。
我关心的不是「快不快」,是快在哪一步。
二、漏洞研究的四个环节
不管是人还是 AI,做漏洞研究都走这四步。区别只在于每步花多少时间。
第一步,侦察。 在几百万行代码里找出可疑的地方:没做边界检查的 memcpy、用了用户输入拼 SQL 的地方、权限校验漏掉的分支。
第二步,假设。 判断这个可疑点能不能真的被利用。可疑不等于可利用,中间隔着一堆前提条件:这个函数谁能调到、参数能不能控制、有没有别的机制挡在前面。
第三步,验证。 写一段输入去触发它,看是不是真的崩了、崩在预期位置。
第四步,串链。 单个洞通常只能拿到一点权限,要把几个洞连起来,从普通用户走到 root。
四步里,耗时分布很不均匀。有经验的审计员,大部分时间花在第二步和第三步的循环上:猜一个可能性,验证,不成立,换一个。
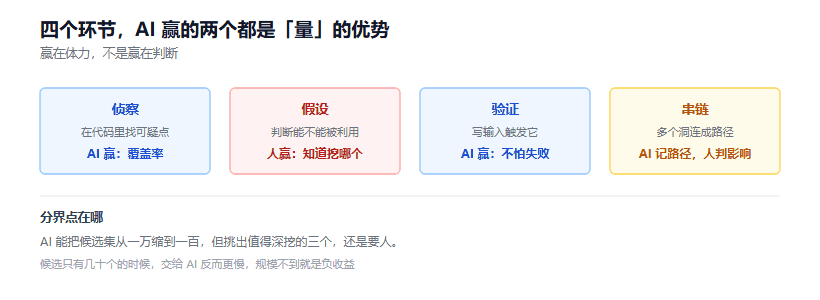
图 1:四个环节里,AI 赢的两步靠的都是量和耐性,不是判断
三、AI 在哪两个环节超过人
我认为是第一步和第三步,而且原因完全不同。
第一步赢在体力。 审计一个大项目的代码,人的速度大概是每天几千行,还要休息、会走神、看到第三遍会跳过。模型可以通读,不累,而且每次读的标准一致。这一步它不只是快,是覆盖率高。
第三步赢在不怕失败。 验证是一个高失败率的循环,十个假设里可能九个不成立。人做这件事会有挫败感,做到第七个不成立的时候,会开始怀疑方向、想休息、或者降低标准草草收尾。模型不会,它可以把一百个假设全试完。
串链这一步,AI 有结构上的优势。 人在追踪一条复杂路径时,短期记忆很快就满了,得靠笔记。模型可以同时持有更多分支,不容易漏。
但第一步和第三步的优势,本质上是「量」的优势,不是「质」的优势。
四、人工审计还剩下的优势
第二步,假设,目前还是人的地盘。
判断「这个可疑点值不值得挖」,靠的是对系统整体设计的理解:这个模块谁在维护、历史上出过什么类型的洞、攻击者的投入产出比划不划算。
模型能列出所有可疑点,但它排不出优先级。它会花同样的力气去挖一个只有管理员能触发的边界问题和一个远程可利用的洞,而后者才值钱。
还有一件事模型做不了:判断影响面。一个洞被利用之后,攻击者能拿到什么、影响多少用户、要不要立刻发通告。这是业务判断,不是技术判断。
所以现在的分工大概是:AI 负责把候选集从一万缩到一百,人负责从一百里挑出三个值得深挖的。
五、一个能落地的分工判断
把这套分工写成代码,就是几个判断条件。我写了个小函数,输入任务特征,输出该交给谁。
STAGES = ["recon", "hypothesis", "verify", "chain"]

def assign(stage, candidates=0, need_context=False, auto_verifiable=True):
    """按环节和任务特征,决定交给 AI 还是人"""
    if stage == "recon":
        # 候选越多、越要求全覆盖,越该给 AI
        return "AI" if candidates >= 500 else "AI 优先,人抽查"
    if stage == "hypothesis":
        # 判断值不值得挖,依赖业务上下文,人来做
        return "人" if need_context else "AI 初筛 + 人定稿"
    if stage == "verify":
        # 可自动化验证的循环,AI 不怕重复失败
        return "AI" if auto_verifiable else "人"
    if stage == "chain":
        # 多路径追踪,AI 记忆优势明显,但要人复核影响面
        return "AI 串链 + 人复核"
    return "未定义"

if __name__ == "__main__":
    cases = [
        ("recon", {"candidates": 3200}),
        ("hypothesis", {"need_context": True}),
        ("verify", {"auto_verifiable": True}),
        ("chain", {}),
        ("recon", {"candidates": 80}),
    ]
    for stage, kw in cases:
        print(f"{stage:<12}{str(kw):<32}-> {assign(stage, **kw)}")
跑出来的结果是这样:
recon       {'candidates': 3200}          -> AI
hypothesis  {'need_context': True}        -> 人
verify      {'auto_verifiable': True}     -> AI
chain       {}                            -> AI 串链 + 人复核
recon       {'candidates': 80}            -> AI 优先,人抽查
最后一行值得注意:候选只有 80 个的时候,给 AI 反而浪费,人自己看更快。自动化不是越多越好,规模不到就是负收益。
这个判断和站里过度封装那篇是同一个道理:工具要配得上任务的量。
六、防守方的漏洞修复节奏要变
这个能力对攻击方和对防守方的影响不对称。
攻击方拿到它,等于把「找洞」的成本砍掉一个量级。防守方拿到它,也砍掉一个量级,但防守方还有另一件事:修。
找到洞之后要评估、要写补丁、要测试兼容性、要分批推送。这套流程的速度由组织决定,不由模型决定。
结果是窗口期变短了。 过去一个洞从被发现到被利用,中间可能有几周;现在可能只有几天。防守方如果还按原来的节奏走审批流程,补丁还没发出去,洞已经被打了。
这件事的应对不在模型层面,在运维和发布流程层面:能不能做到紧急补丁当天上线。
七、这条路的边界
其一,53 分钟这个数字我没法验证。 不知道是什么版本的内核、什么配置、有没有已知 CVE 打底、算不算「从零开始」。
其二,能攻破一个内核和能攻破所有系统是两回事。 Linux 内核是开源代码,训练数据里必然有大量相关内容。换成一个闭源的、没人研究过的系统,能力会差很多。
其三,这类能力的开放性是个政策问题,不是技术问题。 把它锁在保险柜里,能挡住大部分人,但挡不住有能力自己训一个的人。
其四,我不打算讨论具体手法。 这篇只做环节拆解和能力评估,不涉及任何可操作的攻击路径。
结语
53 分钟这个数字,最有价值的信息不是「快」,是它把漏洞研究里最耗人的那部分——反复验证——自动化了。
这对做安全的人是个提醒:如果你现在的价值主要体现在「能读大量代码」和「能耐心试」,这部分正在被替代。反过来,如果你擅长判断「哪个洞值得挖」,这个能力反而更值钱了。
给个能马上验的:拿你手上的项目,让模型做第一轮侦察,把所有可疑点列出来。然后你自己做第二步,标出哪三个最值得动手。这个流程跑一遍,你就能感觉到分工的边界在哪。
站里之前写过协议逆向和WebSocket 帧解析,那些讲的是具体怎么拆,这篇讲的是流程怎么分工。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。