
一句话总结:JetBrains 给 Mellum2.1 加了个多 token 预测头,专门当投机解码的草稿用,官方说草稿接受率约 90%,解码快 1.4 到 1.8 倍。昨天刚算过接受率 0.9 理论上能到 3 倍多,两个数字放在一起有点对不上。反解一遍就明白了:卡住的不是接受率,是 k 太小、草稿太贵。
一、先把这两个数摆在一起
昨天算过一笔账:投机解码在 k=8、草稿成本 0.05 的假设下,接受率 0.9 对应的理论加速是 3.4 倍(那篇有完整推导)。
今天看到 JetBrains 的新模型 Mellum2.1-12B-A2.5B-Thinking-MTP,它加了一个多 token 预测头专门做草稿,官方说接受率约 90%,但加速只有 1.4 到 1.8 倍。
同样的接受率,一个 3.4 倍一个 1.6 倍,差了整整一倍。这中间必然有一个参数不一样。
我的第一反应是官方的数字保守。算完发现不是,是我漏看了 k。
二、MTP 是什么
MTP 是 Multi-Token Prediction,多 token 预测。
常规的模型训练目标是预测下一个 token,一次一个。MTP 在训练时让模型同时学会预测后面几个位置,具体做法是在输出层挂额外的预测头。
这个设计原本是为了提升训练效率和数据利用率,后来发现它的副产品很适合做投机解码:预测头输出的那几个 token,天然就是草稿。
和独立草稿模型相比,MTP 头的差别在两个地方。
它不需要额外加载一个模型,省显存、省一次进程启动。它和主模型共用同一套权重和 KV 缓存,所以不用重新算上下文。
听起来全是优点。但有个代价,后面会讲到。
三、投机草稿的收益,被 k 卡住
回到那个公式。一轮解码的期望产出是:
E = (1 - α^(k+1)) / (1 - α)耗时是 k × 草稿成本 + 1。
α 是接受率,k 是一轮猜几个,草稿成本是草稿一次前向相对主模型的时间比。
接受率 0.9 固定住,把 k 和草稿成本铺开算:
 k | c=0.05 | c=0.15 | c=0.25 | c=0.35 | c=0.50
------------------------------------------------
 1 |  1.81x |  1.65x |  1.52x |  1.41x |  1.27x
 2 |  2.46x |  2.08x |  1.81x |  1.59x |  1.35x
 3 |  2.99x |  2.37x |  1.97x |  1.68x |  1.38x
 4 |  3.41x |  2.56x |  2.05x |  1.71x |  1.37x
 8 |  4.38x |  2.78x |  2.04x |  1.61x |  1.23x
看第一行:k=1 的时候,就算草稿几乎免费(c=0.05),也只有 1.81 倍。
这就是关键。接受率再高,一轮只猜一个 token,天花板就在 1.8 倍左右。
MTP 的 k 通常就是 1 到 3。它不是独立模型,没法一次生成八个候选;它是主模型的一个附加头,多数实现只预测紧邻的一两个位置。
四、反解:MTP 的草稿其实不便宜
再看草稿成本这一维。
固定 k=2、接受率 0.9,反解官方那个 1.4 到 1.8 倍的区间对应什么成本:
  1.8x -> 草稿成本约 0.25
  1.6x -> 草稿成本约 0.35
  1.4x -> 草稿成本约 0.47
也就是说,MTP 头跑一次的前向,要花掉主模型一次前向的 25% 到 47%。
这个数字比独立小模型贵得多。一个专门的草稿小模型,成本通常在 0.05 到 0.1 之间,因为它的参数量可能只有主模型的几十分之一。
MTP 头为什么贵?因为它不是「小模型」,它是主模型加上额外的头。那一层头要跑完整的前向,还要回写 KV 缓存,算力消耗按主模型的几分之一算,不是几十分之一。
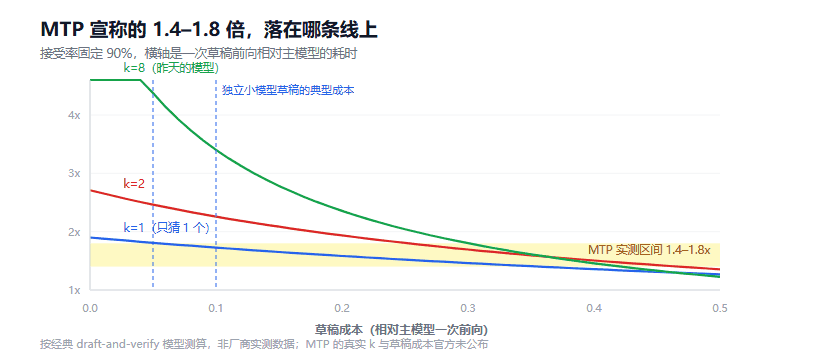
图 1:三条线分别对应 k=1、2、8。黄色区间是 MTP 官方给的实测值,落在 k=2 那条线上
五、和独立草稿模型比,各有各的活路
这么一比,MTP 好像不划算。但它赢在另外三个地方。
第一,不占额外显存。 独立草稿模型要单独加载一份权重,哪怕是 1B 的小模型也要吃掉 2GB 左右。显存紧张的场景下,这一条能直接决定方案可行不可行。
第二,不用管「草稿模型和目标模型配套」这个麻烦事。 独立草稿最怕的就是乱配:草稿模型和主模型的分布差太远,接受率会掉到 0.5 以下,加速变减速。MTP 头是同一个模型训出来的,天然配套。
第三,延迟稳定。 独立模型要额外一次进程调度、一次 KV 缓存分配,长尾延迟会抖。MTP 头在主模型这一次前向里就带出来了。
所以选择标准很清楚:
| 场景 | 选什么 |
|---|---|
| 显存紧、部署简单优先 | MTP 头 |
| 单机多卡、追求极限吞吐 | 独立草稿小模型 |
| 草稿模型和主模型同源(如蒸馏版) | 独立草稿,接受率高 |
| 任务类型多变、不想维护两套模型 | MTP 头 |
六、坑与边界
其一,官方没公布 k 是多少、怎么测的。 我上面的反解基于 k=2 的假设,如果实际是 k=3,对应的草稿成本会更高。这个推算只能定性,不能当准确值。
其二,1.4 到 1.8 倍是个区间,不知道下限和上限分别对应什么条件。 可能一个是短输出、一个是长输出,也可能一个在单卡、一个在多卡。这个信息决定了你在自己场景里能拿到多少。
其三,接受率 90% 是官方自报。 接受率和任务类型强相关,代码补全能到 90%,开放对话可能只有 60%。你跑什么任务,决定了这个数字对不适用。
其四,Mellum2.1 是 12B 的模型,A2.5B 表示激活 2.5B。这个规模的模型本来解码就快,投机解码的收益边际比大模型小。换到 100B 以上的模型上,同一套方法的相对收益会更高。
结语
这两个案例放一起,说明了一件事:投机解码的加速比,接受率只是分子的一半,k 和草稿成本是另一半。
看到「接受率 95%」这种宣传,别急着算它能快多少。先问两个数:一轮猜几个,草稿多贵。
给个实用的判断:如果你在评估一个推理方案,让对方给出这三个数——接受率、平均接受长度、草稿相对成本。三个都给不出来,那个加速比就只能当参考价。
站里另一篇开源模型的路线选择讲的也是这个道理:参数规模不决定一切,配套的工程选择才是分水岭。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。