
一句话总结:Nace AI 的 Drex Max v1 是 27B 稠密模型,标称支持 262K 上下文,能在 Apple Silicon 上跑。我按常见架构算了一遍:权重换到 INT4 只要 13.5GB,但 262K 上下文的 KV cache 要 48GB,是权重的三倍半。满打满算 62GB,64GB 的机器放不下。
一、27B 不算大,262K 上下文才要命
先说为什么值得算这笔账。
27B 这个规模,放到今天算是中等偏小。INT4 量化之后 13.5GB,一张 16GB 的消费级显卡勉强能塞进去。这几年大家对「多大模型要多少显存」已经有直觉了。
但 262K 上下文破坏了这个直觉。
上下文不是免费的。每多一个 token,模型就要在显存里保留它的 key 和 value,这就是 KV cache。它会随着上下文长度线性增长,跟你用什么精度量化权重没关系。
所以「这个模型多大」这个问题,答案不是 27B,是「27B 加你要用的上下文长度」。
二、先把权重算清楚
权重这部分简单,按参数量乘字节数:
| 精度 | 每参数字节 | 27B 权重 |
|---|---|---|
| BF16 | 2 | 54.0 GB |
| INT8 | 1 | 27.0 GB |
| INT4 | 0.5 | 13.5 GB |
这部分没什么可争的,量化一档省一半。
问题在后面。
三、KV cache 才是大头
KV cache 的大小取决于架构:层数、KV 头数、头维度。
Drex Max v1 的架构参数官方没公布。我按同规模稠密模型的常见取值假设:48 层、8 个 KV 头、头维度 128。这个假设直接影响后面的数字,先标出来。
单 token KV = 2(K 和 V)× 48 层 × 8 头 × 128 维 × 2 字节 ≈ 192 KB192KB 一个 token,听着不多。乘上 262144:
   4,096 token ->  0.8 GB
  32,768 token ->  6.0 GB
 131,072 token -> 24.0 GB
 262,144 token -> 48.0 GB
48GB。跟 BF16 的权重一样大。
组合起来看:
| 精度 | 权重 | 32K 上下文 | 262K 上下文 |
|---|---|---|---|
| BF16 | 54.0G | 60.0G | 102.0G |
| INT8 | 27.0G | 33.0G | 75.0G |
| INT4 | 13.5G | 19.5G | 61.5G |
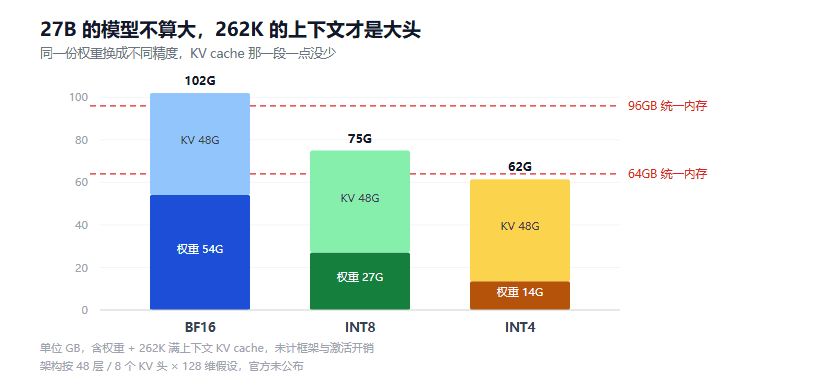
图 1:换精度能压缩蓝色那一段,绿色那一段一分不少
这张图最扎人的地方是 INT4 那根:权重只剩 14GB,KV 还是 48GB。你把模型压到极限,上下文一拉满,账还是六十多 G。
四、Apple Silicon 够不够
官方说这个模型能在 Apple Silicon 上跑,那就要看哪种配置。
统一内存的档位是 64、96、128、192GB。系统和其他程序通常要吃掉 20% 左右,可用部分按 80% 算:
| 统一内存 | 可用 | 满上下文能不能放下 |
|---|---|---|
| 64 GB | 约 51 GB | 放不下(INT4 也要 61.5G) |
| 96 GB | 约 77 GB | INT8 可以,INT4 宽裕 |
| 128 GB | 约 102 GB | BF16 都勉强够 |
| 192 GB | 约 154 GB | 很宽裕 |
所以 64GB 的 Mac Studio 和 MacBook Pro,想跑满 262K 上下文是放不下的。96GB 起步才谈得上。
这个结论和「27B 模型不大」的直觉完全相反。
五、能跑和好用是两回事
上面算的全是「能不能装下」。装下之后还有两个坑。
预填充时间。 262K token 的 prompt,第一次前向要把整段内容算一遍。这个耗时跟长度成正比,在一台消费级机器上可能是几分钟。用户问一句话等五分钟,这个体验没法用。
解码速度随上下文变慢。 每生成一个 token 都要读取全部 KV cache。上下文越长,每步要读的数据越多,出字速度越慢。48GB 的 cache 意味着每个 token 都要在内存里翻 48GB,带宽直接成了瓶颈。
这两个问题在 GPU 上靠并行和高速显存缓解,在 Apple Silicon 的统一内存上,带宽是固定的,缓解不了多少。
六、27B 本地部署的边界
如果真要在这类机器上跑,有三个减压手段,每个都有代价。
KV cache 量化。 把 KV 从 FP16 压到 INT8,直接省一半。代价是长上下文的精度会掉,尤其是需要精确回忆细节的任务。
窗口裁剪。 只保留最近 N 个 token 的记忆,超出的丢掉。省内存,但「它忘了前面说过什么」会变成常态。
分页换出。 把不常用的 KV 换到硬盘,用到再读回来。能装下更长的上下文,代价是速度掉一个量级。
三个手段可以叠加,但每叠一层,离「能用」就远一步。
结语
这次算下来有一件事想强调:买机器的时候,别按模型参数量估算,按「参数量 + 你要用的上下文」估算。
27B 加 262K,实际要的是 60GB 以上的可用内存。很多人按 27B 的直觉买了 32GB 的机器,装上才发现连 8K 上下文都跑不利索。
站里之前算过部署超大 MoE 的显存账,那篇讲的是万亿参数怎么凑卡;这篇讲的是同一笔账在小模型长上下文场景下的变形。推理速度的账在投机解码那篇。
给个能马上做的:拿你手上要跑的模型,去查它的层数、KV 头数、头维度,套一遍 2 × 层数 × 头数 × 维度 × 2 算出单 token 的 KV 大小。这个数出来,你能用多长的上下文就清楚了。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。