
一句话总结:11 月 1 日晚上,一个开发者在调试 Codex 时抓包,发现后端返回的模型名变成了 gpt-6.2-astra,而界面还写着 6 Astra。几乎同一时间,有人在 Anthropic 的源码里翻出了 Claude Mythos 5.5。两家都没开发布会,但两个下一代旗舰已经跑在真实流量里了。这意味着你调用的模型可能随时被换掉,而你手里的版本号对不上。
一、GPT-6.2 是怎么被发现的
第一个线索来自抓包。
那位开发者在调试 Codex 时看到 API 返回的数据包里,模型标识是 gpt-6.2-astra,但前端界面上挂的还是 GPT-6 Astra 的名字。他把这个贴出来之后,陆续有其他 Pro 订阅用户在自己的用量面板里对上了账:旧版 gpt-6-astra 占 80% 调用量,单列的 gpt-6.2-astra 已经吃下 19.8% 的真实流量。
Anthropic 那边更直接:有人在官方源码里扫到了 Claude Mythos 5.5 的字样。同时另一个型号 Fable 5.5 出现在 MLflow 和 Azure 的模型目录里,标注支持 100 万上下文。
两家公司都没回应。这不是发布会,是被扒出来的。
二、为什么用灰测而不是发布
站在厂商角度,这么做有三个理由,我觉得都成立。
第一,安全测试真能翻车。 报道里说 OpenAI 原计划冲的是 6.1,因为安全测试没过关被迫回炉,关起门重炼了一个月,出来直接跳级叫 6.2。跳级这个动作本身就说明中间那一版没了。
第二,灰度是唯一能测出真实分布的办法。 内部测试用的是构造好的题目,真实流量里什么都有:奇怪的输入、超长的上下文、没见过的语言混用。只有放一部分真实请求过去,才知道会在哪崩。
第三,没人开发布会就不用背发布承诺。 一旦正式发布,所有跑分、所有能力声明都要被逐条验证。灰测状态下,出问题可以悄悄调回去。
三、模型灰测对开发者意味着什么
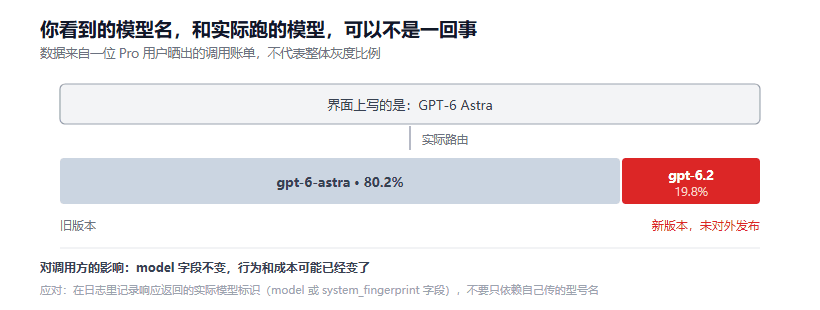
图 1:界面显示的是旧名字,后台已经有近两成流量跑到未发布的新模型上
这才是重点。
你调用的是一个会变的黑盒。 同一个 model id,今天和下周背后可能不是同一个模型。你的 prompt 调好了、评测跑通了、上线了,某天开始效果变了,而版本号没动。
评测结果会失效。 站里写过给 Agent 建评测集,那套东西的前提是被测对象稳定。灰测环境下这个前提不成立,你得在每次跑评测时记录实际返回的模型标识,不然分不清是 prompt 的问题还是模型换了。
成本结构会变。 新模型通常更贵或者更慢,灰测阶段你不知道自己被分到了哪一档。用量面板里那些对不上的账,可能就是这个原因。
我的建议是加一层防护:在请求里带上你能控制的版本标识(如果有),并在响应里记录实际使用的模型名,落到日志里。以后出问题能回溯。
四、Mythos 5.5 那 53 分钟
关于这个模型,公开信息里最扎人的一条是:它用 53 分钟独立攻破了 Linux 内核,拿到最高权限。
我不打算讨论这个过程怎么做,那没有意义。值得注意的是它对能力边界的含义。
一年多以前,AI 做漏洞研究还停留在「帮你读代码找可疑点」的阶段,真正验证和利用要人来。现在的情况是:侦察、假设、验证、串成攻击链,整个闭环能自己跑完,时间以小时计。
Anthropic 的处理方式是把它锁进保险柜:无护栏的特种版只对顶尖网安和科研机构开放,面向大众的是 Fable 5.5,能力做了限制。
这个选择我认为是对的,但也说明一件事:能力到了这个程度,开源和闭源的分野已经不是「给不给」,是「给谁」。
五、模型分层的两种做法
有意思的是,就在同一个周末,乌镇那边在把开源推上 C 位(那篇写了)。
一边是偷偷灰测、源码泄露、特种版只给少数机构;一边是高调开源、体验馆、三剑客集体亮相。
两种节奏,两种策略。但底层是同一件事:模型能力已经强到需要分层释放了。区别只在于分层的方式——一个按许可证分,一个按渠道分。
六、坑与边界
其一,这两个模型都还没正式发布。 所有信息来自抓包、源码扫描和目录泄露,没有官方确认。型号名、能力描述都可能和最终版本不一致。
其二,19.8% 这个流量占比来自单个用户的账单,不能推及全体。灰度比例的真实数字只有 OpenAI 知道。
其三,「53 分钟攻破内核」这个数字我没法独立核实,来源是二手报道。这个量级的能力描述建议谨慎引用。
结语
模型发布这件事,正在从「开发布会」变成「悄悄换芯」。
对厂商来说这更高效,对使用者来说更麻烦。你没法再靠版本号判断自己拿到的是什么。
给个具体的动作:在你的模型调用日志里加一列,记录响应里返回的实际模型标识。字段名各家不同,有的在 model 有的在 system_fingerprint。加这一列花十分钟,以后排查「为什么效果突然变了」能省几天。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。