
一句话总结:11 月 2 日 Hugging Face 联合几个实验室放出的 Carbon-X,把 DNA 序列和自然语言塞进同一个模型。它没走「视觉编码器 + 语言模型」那种拼接路线,而是在词表里加了 4096 个六碱基 token,让 DNA 和中文共用一套嵌入矩阵。我写了个最小实现验证:同样一段序列,六碱基切词的 token 数只有单碱基的六分之一。
一、Carbon-X 解决的是什么问题
先看它要解决什么。
生物领域有两类 AI,各缺一半。
一类是基因组基础模型,专门处理碱基序列,能预测结构、判断突变影响,但它不会说话。你给它一段 DNA,它给你一个分数,你得自己解释这个分数意味着什么。
另一类是通用大模型,读过一堆论文,能跟你聊基因、聊疾病、聊药物机制,但它从来没见过原始的碱基序列。你贴一段 ATGC 给它,它只能当字符串处理。
Carbon-X 要的是两者合一:输入 DNA,用自然语言提问,它既能读懂序列,也能用人类语言回答。
技术上它基于 Qwen3-14B 改造,Apache 2.0 开源,权重完整放出。
二、混合分词器的核心:六碱基穷举
这里有个我认为很漂亮的设计,也是我一开始没想明白的地方。
自然语言的分词器依赖 BPE 这类算法,因为词表空间太大,必须靠统计去学哪些片段该合并。DNA 不一样:只有 A、T、C、G 四个字母,定长切片的组合数是封闭的。
取六个碱基一组,可能的组合是 4 的 6 次方,4096 种。这个数字可以完全枚举,不需要学习,也不需要统计。
所以做法很简单:在原有文本词表之外,追加 4096 个 DNA token,编号 50257 到 54352。DNA 和中文共用同一套嵌入矩阵,只是 token 的编号区间不同。
我原本以为这件事会涉及很复杂的工程,写下来发现核心逻辑就几十行。
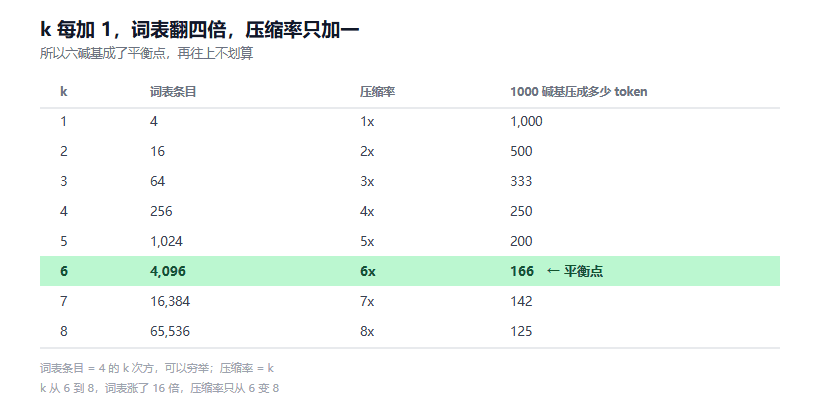
图 1:k 每加 1,词表翻四倍,压缩率只加一,所以六是个平衡点
三、实测:混合分词器的压缩率
我写了个最小实现,把这段逻辑跑了一遍。核心三件事:生成 4096 个六碱基的映射表、按六位切片编码、反查解码。
BASES = "ACGT"
TEXT_VOCAB = 151936          # 以 Qwen 系词表规模为例
DNA_OFFSET = TEXT_VOCAB      # DNA token 从文本词表末尾开始编号

def build_mer_table(k):
    """k-mer 可以完全穷举,这是 DNA 和自然语言最大的不同"""
    mers = ["".join(p) for p in itertools.product(BASES, repeat=k)]
    return {m: i for i, m in enumerate(mers)}

def encode_dna(seq, k, table):
    seq = seq.upper()
    ids, unknown = [], 0
    for i in range(0, len(seq) - k + 1, k):
        chunk = seq[i:i + k]
        idx = table.get(chunk)
        if idx is None:              # 含 N 等模糊碱基
            ids.append(DNA_OFFSET + len(table))
            unknown += 1
        else:
            ids.append(DNA_OFFSET + idx)
    return ids, unknown
拿一段 3000 碱基的随机序列测:
=== 测试一:纯净序列(只有 ACGT)===
k=3:词表    64 | 1000 token | 压缩 3.0x | 未知 0 | 还原 True
k=6:词表  4096 |  500 token | 压缩 6.0x | 未知 0 | 还原 True
六碱基把 3000 个碱基压成 500 个 token,压缩率正好 6 倍,往返还原没问题。
这个压缩率意味着什么?同样长度的序列,模型要处理的 token 少了六分之五。训练和推理的成本都跟着降。
四、DNA 里的 N 会让后面全错
第一次跑的时候,我特意在中间插了 6 个 N——真实测序数据里,N 表示那个位置没测准,很常见。
结果往返还原失败了。
=== 测试二:中间插 6 个 N(模拟测序不确定区域)===
k=3:1000 token | 未知 3 | 还原 False | 首个错位在第 498 个碱基
k=6: 500 token | 未知 2 | 还原 False | 首个错位在第 498 个碱基
我先在 500 位置插了 6 个 N,但错位从 498 就开始了。
原因是切片边界不齐。第 498 到 503 这个六位块里,位置 498 和 499 是正常碱基,500 到 503 是 N,整块查表查不到,只能当未知处理,解码回来就是一串 N。原本那两个正常碱基的信息没了。
一处模糊,连带毁掉一整块,还往前多占了两个位置。
这不是我这个简陋实现的错,是固定长度切词的固有问题。真实基因组数据里 N 的比例不低,所以这类方案必须处理边界对齐,不能简单按六位硬切。
Carbon-X 具体怎么处理的,官方没说,我不猜。但这件事说明:论文里的「混合分词器」四个字,背后有一堆脏数据要对付。
五、便宜 1800 倍,Carbon-X 省的不只是模型
官方给的数字是:单样本推理成本约为 GPT-6.1 Sol 的 1/1800。
这个倍数看着夸张,拆开看是三件事叠出来的。
第一,模型小。 14B 对上一个前沿闭源模型,参数量差了两个数量级。
第二,token 少。 就是上面那个六分之一。同样一段 DNA,闭源模型按字符或子词处理,token 数多得多。
第三,任务窄。 它只做基因组相关的活,不跟通用模型比聊天。
三者相乘,才有那三个数量级。这也解释了为什么它在 DNA 专项基准上能以 66.7% 接近 Sol 的 67.5%,但换个任务就未必。
顺带说一个更有意思的应用:把它当子专家外挂给通用模型。测试里接上 Carbon-X 之后,Kimi K3 的 DNA 综合能力提升了 11.1 个百分点。这个思路和给 Agent 搭业务上下文是一回事,只是外挂的是专业模型而不是文档。LongCat 那篇讲的也是同一个方向:不追通用能力,把一件事做透。
六、坑与边界
其一,66.7% 这个分数是在五项去污染 DNA 基准上取的均值,不是通用能力。它同时在复杂插入缺失变异上输给闭源模型,官方自己承认了。
其二,1800 倍是单样本成本,不含部署和运维。你自己搭一套跑这件事,账要另算。
其三,我写的这个分词器是教学用的简化版,没做边界对齐、没处理大小写和甲基化标记、没考虑反向互补链。真实实现比这复杂得多。
其四,训练数据规模对不上。 官方说用了 3000 亿 token 混合数据,但没说其中 DNA 序列占多少比例。这个比例直接决定了模型到底见了多少真实基因组。
结语
Carbon-X 最值得学的不是它把 DNA 塞进语言模型这件事,是那个「组合数封闭所以可以穷举」的判断。
自然语言分词要靠学习,因为空间是开放的。DNA 的 k-mer 空间是 4096,直接列表就行。这类「先想清楚问题空间的形状,再选方法」的判断,比模型结构本身更值钱。
给个能动手的:如果你要做的领域有类似的封闭结构,比如化学式、氨基酸序列、MIDI 音符,先算一下组合数。能穷举就别上 BPE。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。