
一句话总结:Nace AI 开源的 Drex Max v1 是个 27B 的决策模型,能在一次前向里给最多 255 个选项打分。这个接口形状和聊天模型完全不同:它不生成文本,它输出一条分数向量。我用 12 条模拟输出对比了两种接口,发现让模型「说出选择」再解析,加规则会把准确率从 10/12 拖到 9/12,还多出两个错判。
一、Drex Max 的 255:一次给所有选项打分
Drex Max v1 的规格里,我最感兴趣的不是 27B,也不是 262K 上下文,是那个「一次前向给 255 个选项打分」。
这个数字说明了它的接口形态。它不生成文本,它接收一个问题加一组选项,输出一条定长的分数向量,每个位置对应一个选项的分数。
为什么会是 255?我猜是某个内部实现的宽度限制,比如输出头设计成 256 路、留一路给「都不选」。官方没说,这一条存疑。
但这个设计本身值得说:它把「选哪个」这件事,从语言问题变成了数值问题。
二、两种决策接口的差别
日常我们用模型做选择,走的是生成式接口:
问「这四个方案选哪个」,模型输出一段话,你从里面解析出「B」。中间那一步解析,是你自己加的。
打分式接口没有这一步。模型直接给出 [-1.2, 2.8, 0.4, -0.9],取最大值下标,就是第 2 个选项。
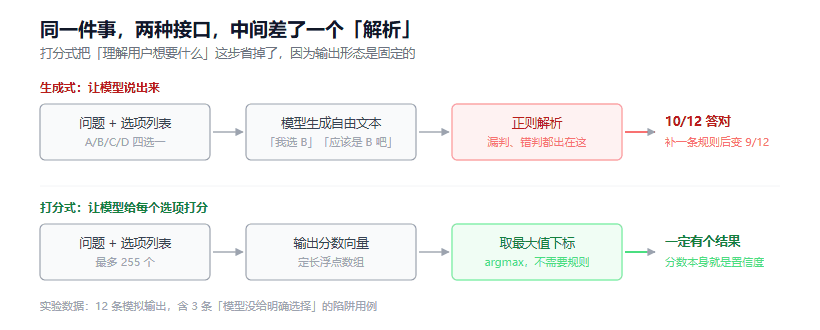
图 1:生成式多了一步解析,所有漏判和错判都出在那一步
差别看着只是工程细节,但它决定了三件事。
第一,结果是否确定。 生成式受采样影响,同样的输入跑两次可能给不同答案。打分式用贪心,每次都是同一个。
第二,要不要维护解析规则。 生成式必须写正则或关键词匹配,而且得跟着模型的说话风格一直改。
第三,置信度从哪来。 生成式想知道模型有多确定,得再问一次「你有多大把握」。打分式的分数本身就是。
三、实验:解析器越补越糟
我写了个脚本,造了 12 条模型输出,其中 9 条是「明确选了 B 但说法不同」,3 条是陷阱(模型没给明确选择,或者给的是否定)。
第一版解析器只认四种情况:单字母、带「选项/方案」前缀、开头字母、选项正文。
V1(原始规则):答对 10/12 | 漏判 2 | 错判 0漏掉的两条是「选 B」和「应该是 B 吧」,前者规则没覆盖,后者压根没给明确答案。
我第一反应是补一条规则,把「选 X」这种说法也认了。
m = re.search(r"(?:选项|方案|选择|选)\s*([A-D])", t)加上去重跑:
V2(补了「选 X」规则):答对 9/12 | 漏判 1 | 错判 2
    [错判] 「不选 B」期望 None,实际判成 B
    [错判] 「不建议选 B,风险太大」期望 None,实际判成 B
补了一条规则,「选 B」救回来了,但「不选 B」和「不建议选 B」全被判成了 B。
答对从 10 掉到 9。
这就是规则解析的根本困境:中文里「选」和「不选」只差一个字,「建议」和「不建议」也是。你按字符匹配,它分不清否定。
继续补规则能修,比如加一条排除否定的:出现「不」「别」「避免」就不认。但接下来会遇到「不是不能选 B」这种双重否定,再补下去是无穷的。
四、错判比漏判严重,根子在解析这一步
这个实验里,V1 的 2 个漏判其实无害。漏判的结果是「解析不出」,你的程序拿到 None,走异常分支,人来看一眼就发现了。
V2 的 2 个错判是致命的。程序拿到一个 B,它不会知道这是错的,会照着执行——在生产环境里,这意味着它把「不建议选 B」当成了「选 B」,然后真的灰度上线了。
漏判是「我不知道」,错判是「我知道错了还很有信心」。 后者难查一百倍。
做自动化的人应该都有这个经验:宁可让流程停下来报警,也别让它带着错误继续跑。
五、决策模型适合什么场景
不是所有选择都值得上决策模型。我总结三类。
选项固定且可枚举的。 比如风控里的策略选择、客服工单的归类、批处理任务的路由。这类问题的共同点是:候选集是有限的,而且你知道全部有哪些。
需要可审计的。 打分式输出了一条完整的分数向量,每个选项得了多少分都记在日志里。出了事能回溯「当时为什么选它」。生成式只留一段话,说不清。
高频、低延迟的。 一次前向出结果,不用生成文本,延迟比聊天模型低一个量级。
反过来,开放式决策不适合。比如「这个季度该主推哪个方向」,选项本身都列不全,232 个也不够。
六、用决策模型的边界:分数别当结论
其一,67.52 这个 Decision Index 分数我没法核实。 这是个什么基准、题怎么出的、评测环境是什么,报道里都没说。厂商自报的数字,按惯例打折看。
其二,256K 上下文对决策任务意义不大。 决策通常不需要读那么长的材料,这个规格更像是继承自底座模型。
其三,官方没公布内存要求和许可条款。 27B 稠密模型跑起来大概要 54GB 显存(BF16)或 27GB(INT8),Apple Silicon 上要多少统一内存,报道里没提。
其四,我实验里的 12 条输出是我自己造的,不是真实模型输出。这个实验证明的是「解析规则的困境」这个结构性问题,不是 Drex Max 的实际表现。
结语
这个模型给我的启发不是「决策模型很厉害」,是接口形状本身就是一种设计决策。
同样一个「四选一」的需求,做成生成式接口,你得写解析器、维护规则、处理异常;做成打分式接口,这些活全没了。
以后再遇到「让模型选一个」的需求,先问一句:能不能把候选集穷举出来。能,就用打分;不能,才回到生成。
站里另一篇讲给 Agent 建评测集的思路可以套过来:如果你的评测里有「选择题」,用打分接口能省掉一大堆判分代码。推理侧的另一笔账在投机解码那篇,讲的是同样的「换个接口省掉一层」的逻辑。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。