
一句话总结:香港金管局在推代理身份中央登记册,特拉华州打算允许 AI 智能体注册公司并承担法律责任。当 Agent 从工具变成能签合同、能付款、能被起诉的主体,"网站"要面对的访客就不只是人和爬虫了。内容站现在能补的,是抓取许可和内容授权这两层。
上个月看香港证监会那份 AI 应用调查,有个数字让我停了一下:受访的大型金融机构里,约 30% 已经在业务中用上了代理型 AI,还有 25% 在试点。
加起来过半。
同一周,香港金管局启动了 SAGE 项目,盯的是代理式购物支付、企业资金管理、机器间自动交易这三类场景,其中一项工作是研究建立可信 AI 代理的中央登记册和代理身份识别标准。
再往前几天,美国特拉华州在讨论允许由 AI 智能体运营的企业注册成立,设 30 个月监管沙盒,这类公司可以像正常企业一样被起诉,也可以主动起诉。
三件事指向同一个变化:Agent 不再只是一个工具,它开始有身份了。
一、同一个月,两地为 Agent 身份立法
先把事实摆清楚。
香港这边分两条线。 证监会做的是渗透率调查加实务指引,金管局做的是技术基础设施——中央登记册和身份识别标准。后者更关键,因为它是"谁能代表谁"的技术前提。
特拉华那边是主体资格。 AIC(AI 运营的公司)如果能注册,意味着 AI 做的商业决策在法律上有效力,出了事有明确的追责对象。
有一个反对声音值得记下来:众议院监督委员会主席已经致信州长表达担忧,认为这个架构可能被用来为大型 AI 企业和投资者免除责任。这个担心不是没道理——如果公司由 AI 运营,那"谁该负责"这个问题会被反复拉扯。
二、代理身份登记意味着什么
对做内容的站来说,这件事的直接影响在访问链路上。
现在的访客分两种:人,和爬虫。你对这两种的态度是不一样的——人看广告、点链接;爬虫抓内容、进索引。所以有了 robots.txt。
以后会有第三种:一个有身份、有授权范围、能替人做事的 Agent。
它来你的站不是为了抓取,是为了办事——查价格、下单、填表、比价、订阅。它做的事在法律上算它背后那个人的行为。
这种变化已经在发生了。首页正在失去意义那篇讲过:当智能助手直接回答问题,用户连"点进网站"这一步都省了。
这时候你的站点需要回答的问题变了:
- 不只是"你能不能抓",而是"你能不能用我的内容去做决策"
- 不只是"你是谁",而是"你代表谁、你的授权范围到哪"
- 出了问题,找那个 Agent,还是找它背后的人,还是找你
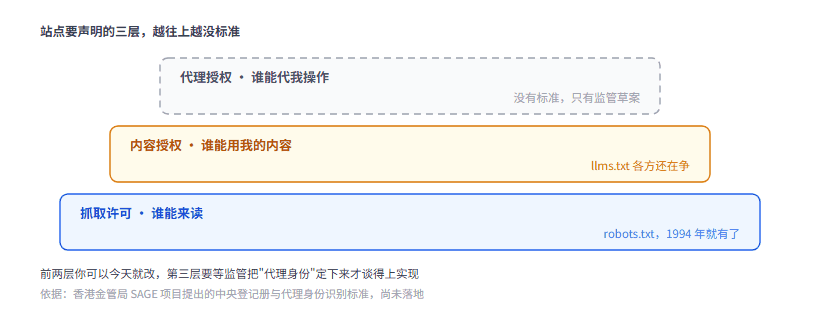
图 1:最下面那层已经很成熟,最上面那层连标准都还没有
三、内容站要声明三层授权
我把这件事拆成三层。
第一层,抓取许可。 谁可以来读。这一层有 robots.txt,1994 年就有了,成熟度最高。你要做的只是把它配对——别用默认的 Disallow: / 挡掉所有爬虫,也别为了收录全开。
第二层,内容授权。 谁可以用我的内容,用到什么程度。这一层的现状是乱的:llms.txt 是一个提案,有些站在用,但没有任何搜索引擎或 AI 厂商承诺遵守。法律层面更乱——训练数据用不用授权、引用多少算合理使用,各地判例还在打架。
第三层,代理授权。 谁能代我操作。这一层基本空白。香港说的中央登记册还没落地,也没有任何技术标准告诉你"怎么声明你的站允许哪类 Agent 做什么事"。
三层的成熟度差得很远。前两层你今天就能动手,第三层只能等。
四、现在能补的授权信息
四件事,按优先级。
1. 把 robots.txt 理一遍。 它现在不只是给搜索引擎看的。GPTBot、ClaudeBot、Bytespider 这些 AI 爬虫都会读它。你要决定的是:让不让它们抓。
让,你的内容可能进训练集;不让,你在 AI 回答里出现的概率会降低。这是取舍,没有标准答案。
2. 明确写出版权与引用规则。 大多数站只有页脚一行"版权所有"。建议单独做一页,说清三件事:允许引用多少、要不要署名、商业使用怎么联系。
这一页对人有约束力,对机器暂时没有——但它是第三层落地时的基础材料。等标准出来,你至少有一份明确的声明可以映射过去。
3. 把结构化数据补全。 这是唯一一层现在就能被机器准确读懂的声明。Organization、WebPage、Article、作者、发布时间、许可协议——这些字段现在就在影响 AI 摘要愿不愿意引用你。
内容站要不要做 MCP那篇讲过类似的判断:先看你的内容落在哪个象限,再决定投入。
4. 留一条"机器可读"的联系方式。 现在大模型厂商处理版权投诉,靠的还是邮箱。在页面上放一个 copyright@ 或专门的授权联系邮箱,比只留一个评论框有用。
五、还缺的是什么
缺的是"代理授权"这一层的技术标准。
现在能想到的形状大概是:站点声明"允许哪类 Agent 以什么身份、做什么操作",Agent 请求时带上可验证的身份凭证,站点决定放不放行。
香港的中央登记册如果真做出来,就是这个凭证的发放方。SAGE 项目研究的三类场景(购物支付、资金管理、机器间交易)都涉及真实资金,所以身份必须可验证、可追责。
但对内容站来说,这件事不急。你的站不涉及支付,Agent 最多来查个信息、订个订阅。真正需要担心的是电商和金融,不是内容站。
六、常见问题
我的站会被 AI Agent 访问吗?
已经在被访问了。搜索引擎的爬虫是 Agent 的一种,只是能力单一。能力更强的(能执行 JavaScript、能填表)也在增加。
要不要屏蔽所有 AI 爬虫?
看你的商业模式。靠流量变现的,屏蔽等于放弃 AI 渠道的曝光;靠内容付费的,屏蔽是必要的。别默认全开或全关。
llms.txt 值得做吗?
现在做,收益不确定,成本很低。我的判断是:做一份不亏,但别指望它带来流量。
特拉华那个 AIC 跟我有关系吗?
间接有。如果 AI 能注册公司、能被起诉,那它对内容的使用就会被纳入商业行为,授权和追责的要求会跟着变严。
结语
这一轮变化最容易被忽略的地方是:它不是在改技术,是在改关系的定义。
过去你和访客的关系是"你看我的页面"。以后可能是"你的 Agent 替我办了件事,用的是我的数据"。
中间那层授权说明,现在没人认真写。等标准出来了再补,成本会高得多——因为那时候你得回头翻三年内的内容,一条条标授权范围。
参考资料
- AI 圈要闻 2026-11-03 - 香港证监会调查与金管局 SAGE 项目
- 特拉华州 AI 公司注册讨论 - AIC 注册与监管沙盒
- llms.txt 提案 - 面向大模型的内容声明格式
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。