
一句话总结:把 GPTBot、ClaudeBot、PerplexityBot 等 12 个 UA 对本站 6 条路径逐个跑了一遍,判定结果 12 份完全相同——站里 10 条 robots 规则没有一条给 AI 爬虫,全走通配符;真正的问题在别处。
有人问我,AI 爬虫到底能不能抓他站上的文章。
我说看 robots.txt 就行。他说改过了,还是不来。
那只能跑一遍。urllib.robotparser 十五行代码,12 个 UA × 6 条路径,结果打印出来只有一张表。
robots.txt 里 10 条规则,0 条给 AI 爬虫
站上的 robots.txt 一共 10 条 Allow/Disallow,全部挂在 User-agent: * 下面:
User-agent: *
Disallow: /zb_system/
Disallow: /zb_users/cache/
Disallow: /zb_users/data/
Disallow: /error/
Disallow: /search.php
Disallow: /*?q=
Disallow: /*?viewall=
Disallow: /*?paged=
Allow: /git/
Disallow: /zb_users/plugin/xx_gitshop/cache/
Sitemap: https://www.zhaixingw.cn/sitemap.xml
从头到尾只有一个 User-agent 段。没有 GPTBot,没有 ClaudeBot,没有 Google-Extended,什么都没有。
这个状态不一定是坏事。不单独声明,等于放行——所有没被点名的爬虫都按 * 的规则走,正文页面是允许的。
但它也意味着:你对 AI 抓取没有任何策略。想让 GPTBot 别抓,得加;想只让它抓某几个栏目,也得加。
12 个 AI 爬虫逐条跑一遍,判定完全一致
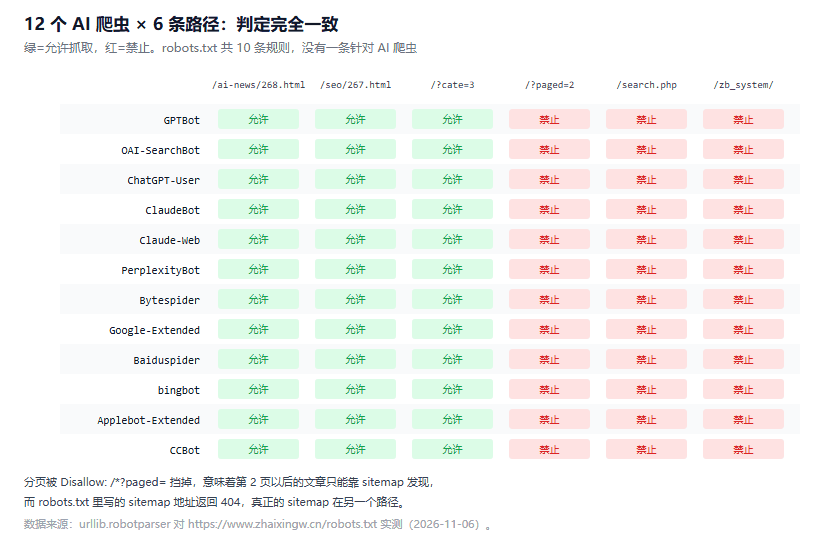
图 1:绿色为允许,红色为禁止。12 个 UA × 6 条路径共 72 个判定,同一列的颜色完全相同。数据来源:urllib.robotparser 对本站 robots.txt 实测
import urllib.robotparser as rp, urllib.request
txt = urllib.request.urlopen("https://www.zhaixingw.cn/robots.txt").read().decode()
r = rp.RobotFileParser(); r.parse(txt.splitlines())
UAS = ["GPTBot","OAI-SearchBot","ChatGPT-User","ClaudeBot","Claude-Web","PerplexityBot",
       "Bytespider","Google-Extended","Baiduspider","bingbot","Applebot-Extended","CCBot"]
PATHS = ["/ai-news/268.html","/seo/267.html","/?cate=3","/?paged=2","/search.php","/zb_system/"]
for ua in UAS:
    print(ua, ["允许" if r.can_fetch(ua, p) else "禁止" for p in PATHS])
结果:
| UA | 文章页 | 分类页 | 分页 | search.php | zb_system |
|---|---|---|---|---|---|
| GPTBot / ClaudeBot / PerplexityBot / Bytespider / 其余 8 个 | 允许 | 允许 | 禁止 | 禁止 | 禁止 |
12 个 UA 的判定完全一致,一条都没差。
顺带回答一个常见的误解:Google-Extended 不是 Googlebot。它管的是 Gemini 的训练与 grounding 用途,控制不了 Google 搜索的收录。想控搜索收录得用 Googlebot 那段。
被挡住的是分页,正文都能抓
红色的两条是 /search.php 和 /zb_system/。前者是站内搜索,后者是后台。挡掉合理。
真正值得看的是 /?paged=2 这一条。它挡的是列表页的第二页往后。
对收录的影响是:爬虫能拿到每一篇文章,但发现路径变窄了。首页只列最新的十几篇,再往前的内容,爬虫要么靠 sitemap,要么靠内链一层层跳。
1031 个 URL 的站,首页能列出的不到 2%。剩下的全靠 sitemap 和站内链接。
这就把问题引到了下一条。
robots 写的 sitemap 是 404,真正的位置在别处
robots.txt 最后一行指向 https://www.zhaixingw.cn/sitemap.xml。
实测:
| 地址 | 状态码 | 大小 |
|---|---|---|
| /sitemap.xml | 404 | 146 B |
| /sitemap/map.xml | 200 | 143,878 B |
真正的 sitemap 在 /sitemap/map.xml,里面有 1031 个 <loc>。robots 指的那个是 404。
这个错很隐蔽。你打开浏览器访问 /sitemap.xml,看到 404,会以为"sitemap 插件坏了";而实际上文件在,只是路径写错了。
对 AI 爬虫来说,后果更具体:它们大多靠 robots.txt 找 sitemap。你指了个 404,它们就没有入口,只能从首页爬。
至于爬到了会不会被引用,是另一个变量。之前整理过一组数据:检索环节能解释 32% 的引用差异,页面特征只解释 2.8%。入口通畅是必要条件,不是充分条件。
更该担心的是:UA 里带 bot 就能看到完整页
上面两条都是配置问题,可以改。这一条是结构问题。
同一个 URL,用不同 UA 请求,返回的东西不一样:
$ curl -s https://www.zhaixingw.cn/seo/267.html | wc -c
5224

$ curl -s -A "Baiduspider" https://www.zhaixingw.cn/seo/267.html | wc -c
54223
5,224 字节那份,标题是"网站正在备案中",head 里有 <meta name="robots" content="noindex,nofollow">。
54,223 字节那份,是完整文章页,标题正常。
也就是说:爬虫看到文章,人看到备案占位页。
我又试着伪造了几个 UA:
| UA | 返回大小 |
|---|---|
MyFakeBot/1.0 | 54,223 |
curl/8.4.0 | 5,224 |
| 普通 Chrome UA | 5,224 |
GPTBot/1.2 | 54,223 |
PerplexityBot/1.0 | 54,223 |
一个自己编的 MyFakeBot 也能拿到完整页。判断逻辑不是白名单,是"UA 字符串里有没有 bot 这个词"。
这两件事叠起来,收录会怎样
规则层面全开,内容层面按 UA 分流。两件事放在一起,后果不是"收录变差",是三种不同的风险。
风险一:cloaking 判定。 搜索引擎把"给爬虫看 A、给人看 B"定义为 cloaking,属于明确的作弊手段。触发检测不一定要人工举报,比对渲染结果就能发现。
另一个维度是合规面。 这一周欧盟 AI 法和乌镇倡议同时落地,内容站要准备的东西单独写过一篇,里面提到的披露要求,和这里的抓取策略是两件事,别混在一起改。
风险二:分享链路断掉。 备案期这么干是为了合规,可以理解。但备案已经通过了,分流逻辑还在跑——现在任何一个真人点进来,看到的都是"正在备案中"。这篇文章发出去,读者点开也是那一页。
风险三:未发布内容可被读取。 如果这个判断逻辑对 /zb_system/ 也生效,那任何人加个 bot 后缀就能绕过 robots 的 Disallow。我测的是前台页面,没测后台,这一条是推测,标存疑。
坑清单
1. 只改 robots,不校验返回码。
robots.txt 里的 sitemap 地址是三个月前配的,/sitemap.xml 一直是 404,没人发现。因为所有人都只看 robots.txt 的内容,没人 curl 那个地址。
改完 robots 之后必须做一件事:把里面出现的每个 URL 都请求一遍,看状态码。
2. 以为 Disallow 等于"抓不到"。
Disallow 是"请勿抓取",不是"无法访问"。被 Disallow 的页面如果被外链指向,仍可能出现在索引里,只是没有摘要。对 /?paged= 这种分页参数页,正确的处理是加 canonical,不是靠 Disallow。
3. UA 判断用子串匹配,等于没有判断。
MyFakeBot 能过,说明实现里大概是 if "bot" in ua.lower()。任何爬虫、任何脚本、任何想绕过的人,加上 bot 就能过。
真要按爬虫分流,得匹配完整的已知 UA 前缀,并且加 IP 反查。这两件事都不便宜,所以大部分站干脆不分流。
4. 用普通 UA 检查自己的收录状态。
我这次差点又踩。requests.get(url) 拿到的永远是那份 5,224 字节的占位页,然后你会得出"文章没发出去"的错误结论。
检查线上内容要用爬虫 UA,或者直接看数据库。
5. 通配符在不同实现里解析不一致。
/*?paged= 这种写法,Google 支持,但一些小爬虫的 robots 解析器只认前缀匹配,会把整条规则当无效。同一个文件,不同爬虫读出不同结果——这也是为什么"我改了 robots 但没效果"经常出现。
结语
这次跑完,三件事按优先级排:
先修 sitemap 那一行。把 Sitemap: 改成 /sitemap/map.xml,一分钟的事,收益是 1031 个 URL 有了正式入口。
再关掉 UA 分流。备案已经过了,这个逻辑继续跑只有坏处。如果还要保留,至少把判断从"含 bot"改成白名单加 IP 校验。
再考虑给 AI 爬虫单独写策略。现在全放行,等于把选择权交给对方。想清楚要不要让 GPTBot 抓,再写进 robots——这一步不做也不错,但别以为"没写"就是"没影响"。
这三件事都做完,再来问"为什么不来蜘蛛"。那时候的答案才是有意义的。
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。