
一句话总结:Arena 免费模型周报里,GLM-5.2 和 DeepSeek-V4.1-Flash 都是 1475 分,名次却一个升到第 5、一个降到第 6;而第 1 名对第 24 名的 Elo 分差换算成胜率,也只有 57 比 43。
周报这种东西,最容易被引用的是名次。
"上升 4 位""跌出前 20"——名次变化直观,适合做标题。
但名次是序数,不是基数。第 5 和第 24 之间隔了 19 个名次,不代表实力差 19 份。这周 Arena 免费榜的数据正好能把这件事算清楚。
免费模型榜本周动了哪些名次
先看原始变动(截至 11 月 8 日的一周):
综合榜:GLM-5.2(Max)升 1 位到第 5(1475 分),DeepSeek-V4.1-Flash(Max)降 1 位到第 6(1475 分),MiniMax-M3 降 3 位到第 24(1436 分)。
编程榜:GLM-5 降 5 位到第 30(1435 分),Muse Spark Open 降 2 位到第 17(1526 分),Kimi K2.6 降 2 位到第 18(1509 分)。
分类第一:Chat 是 Kimi K3(1488),编程是 Kimi K3.1 Pro(1684),Agents 也是 Kimi K3.1 Pro(5.3,这个榜分数口径不同)。
三条变动信息,两种不同的故事。GLM-5.2 和 DeepSeek 那条是"并列同分、名次互换",GLM-5 那条是"连降 5 位"。
榜单名次和 Elo 分数:两种完全不同的数
Elo 分数是基数,名次是序数。
两个模型分数差 39 分,意味着对局胜率是 55.6 比 44.4;名次差 19 位,给人的感觉是"差了一个档次"。
这两种表达的信息量完全不同。名次丢失了间隔信息:第 5 和第 6 可能只差 0 分,第 1 和第 24 也只差 52 分。
Arena 榜上 #5 对 #24,胜率只有 56:44
把几组对位换算成胜率:
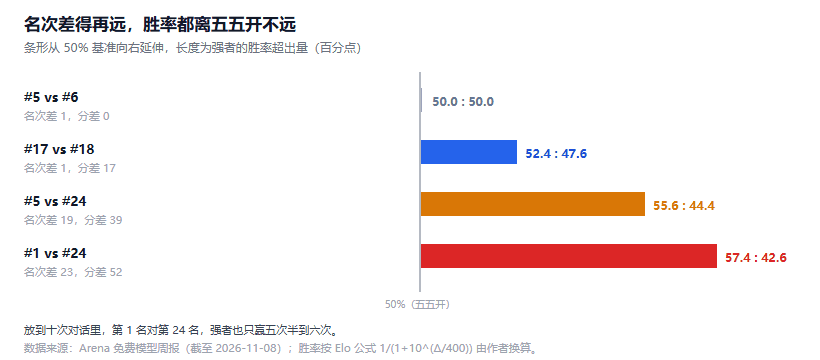
图 1:横轴为相对 50% 基准的胜率偏离量。名次差 19 位,胜率也只偏离 5.6 个点。数据来源:Arena 周报分数,胜率为作者按 Elo 公式换算
| 对位 | 名次差 | 分差 | 实际胜率 |
|---|---|---|---|
| GLM-5.2 #5 vs DeepSeek #6 | 1 | 0 | 50.0 : 50.0 |
| Muse Spark #17 vs Kimi K2.6 #18 | 1 | 17 | 52.4 : 47.6 |
| GLM-5.2 #5 vs MiniMax-M3 #24 | 19 | 39 | 55.6 : 44.4 |
| Kimi K3 #1 vs MiniMax-M3 #24 | 23 | 52 | 57.4 : 42.6 |
四行放在一起看,结论很统一:名次差得再远,胜率都离五五开不远。
第 1 名对第 24 名,也不过是 57 比 43。放到十次对话里,强者大概赢五次半到六次。
给做免费模型宣传的人提个醒
这个换算对两种人有用。
想引用榜单的人: 名次没信息量,分数才有。引用时带一句"Elo 分差 X,对应胜率约 Y 比 Z",比"排名第 N"诚实得多。并列 1475 的两家,说谁压谁都是编。
被榜单引用的人: 如果你的模型排在第 5 和第 24 之间,宣传语里那一位数字背后的真实差距可能不到 6 个百分点。反过来,你落后竞争对手"十几名",实际差距也可能只是"十次里输一次半"。
两边都别被名次绑架。
更细的算法在抽样误差那篇:名次只是序数,权重空间编程那篇的教训也是同一个——先看数值,再看排序。
关于 Arena 榜单的五个问题
这个榜测的是什么? 真人盲测偏好。它衡量"人更喜欢谁的回答",不直接等于能力。
免费模型和收费的比有意义吗? 这份周报只统计开放权重模型,是同口径内的比较。
分数每周会变多少? 从这周看,±17 分是相邻名次的常见间距,3 分的浮动就能换名次。
K3.1 Pro 的 1684 和别的榜能比吗? 不能。不同榜单的 Elo 是不同分数体系,跨榜比较没有意义。
为什么 Agents 榜分数才 5.3? 那个榜的计分口径和对话榜不同,绝对值不可比。
结语
把这份周报的名次全部抹掉,只留分数,你得到的结论会更准确。
名次适合做标题,分数适合做决策。两者都公开的时候,看分数;只报名次的地方,把"第 N 名"自动翻译成"和上下相邻的差不多"——大部分时候这个翻译是对的。
上次算抽样误差的结论是"0.3 分的差距需要 15 万题才能分辨";这次是同一件事的榜单版:分数差 0 分,名次差 1 位。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。