
一句话总结:D-Robotics 开源的机器人世界模型 Uranus,把 UR5、ALOHA、AgiBot、ARX5、DROID 五种机器人的数据统一成一套骨架表示;配套的 HarnessEval-W 把"人怎么看视频"做成可执行的评估流程,置信度低于阈值的数据不放行。
机器人世界模型有个讨厌的前提问题:数据不通用。
UR5 是工业机械臂,ALOHA 是双臂遥操台,AgiBot 是人形——每家的本体、自由度、相机位姿都不一样。想在五家机器人上训一个模型,得为每一家的数据格式单独做适配。
Uranus 做的事是把这层适配一次性解决掉。
Uranus 解决的问题:每个机器人一种语言
五种机器人的原始数据长得完全不同。直接混着训,模型学到的是"这是 UR5 的画面"而不是"这是一个抓取动作"。
Uranus 的做法是加一层"同声传译":不管背后是什么机器人,全部转成统一的骨架表示。
论文验证了 UR5、ALOHA、AgiBot、ARX5、DROID 五个平台都能走这套方案。这是它号称"跨 embodiment 泛化"的技术根基,没有这层统一,跨形态就是一句口号。
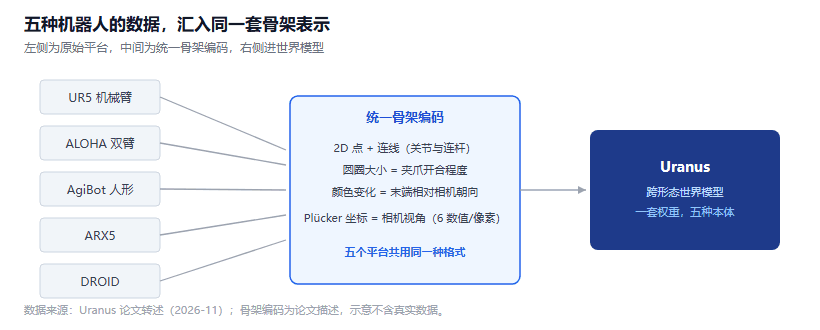
图 1:五种机器人平台的原始数据统一转成骨架表示后再进模型。数据来源:Uranus 论文转述
Uranus 的骨架统一表示:点、线、圆圈、颜色
骨架的格式很朴素:2D 图像上的一堆点和连线。
神经网络看到的永远是同一种格式,不需要知道背后是 UR5 还是 ALOHA。
额外信息也编了进去,而且编法很省:
- 夹爪开合程度 → 圆圈的大小
- 末端执行器相对摄像头的朝向 → 颜色变化
这三个通道(位置、开合、朝向)覆盖了操作类任务最关键的观测。不是全量信息,是精选过的最小集合。
这个思路对做数据管道的人有直接参考价值:别急着把所有传感器数据都塞给模型,先想清楚哪些信号决定了任务成败,把它们编码进统一表示,剩下的丢掉。
Plücker 坐标:把摄像头位姿编进 Uranus 的世界模型
相机位姿是机器人数据里最乱的变量之一。同一个抓取动作,相机架在头顶和架在侧面,画面完全不同。
Uranus 用 Plücker 坐标处理这个问题:对每个像素,算出它对应的三维空间射线的方向和位置,共 6 个数值。与其说是"某个角度拍到的图",不如说是"从哪个视角拍的、光线往哪走"。相机装在哪都行,模型自己理解视角。
这是把几何先验直接写进输入表示,比让网络自己从数据里学视角要省数据。
HarnessEval-W:把评估也做成流程
这部分是整篇里工程味最重、也最容易被跳过的。
评估机器人视频好不好,目前主要靠人看。人看的过程其实是一套固定流程:看哪些要点、按什么顺序、怎么算通过。
HarnessEval-W 把这套流程 harness 化,变成可执行、可复用、可扩展的智能体系统。
价值在于"可复用"。人评不可复现,今天看和明天看结论可能不同;流程化的评估每次跑都一样,而且能随着标注数据的增加持续校准。
这也呼应了PLE 那篇的判断:机器人领域缺的不是模型,是可执行的判分器。
机器人数据的置信度校准:自动通过要有依据
HarnessEval-W 的打分不是直接用的。
流程是:给每个提取结果打一个置信度分数,拿一批标注好对错的数据做校准,找到一个阈值,高于这个阈值的历史数据里,错误率低于目标值。以后凡是超过阈值的自动通过,低于的人工复核。
这一步是"评估可以自动化"的门票。没有校准的置信度分数是没有意义的数字,模型自己说 0.9 不代表 90% 正确。
做法朴素,态度值得学:自动化的每一级都要配一个错误率承诺。
关于 Uranus 的五个问题
开源到什么程度? 权重开源,具体许可证以发布页为准。
必须要有真机吗? 用它的世界模型做仿真不需要真机;但要生成训练数据,还是得从真实机器人采。
五种机器人之外的形态能用吗? 理论上只要能提取骨架就能接,但没验证过的不算数。
和 Cosmos 3 是竞争吗? 同赛道不同侧重。Cosmos 覆盖驾驶和机器人,Uranus 主攻跨形态的机器人操作。
置信度阈值定多少? 按你的目标错误率反推,不是一个固定数。
结语
这篇里我觉得最值得抄的是那个"统一表示"的决策。
五种机器人五种数据格式,最容易想到的做法是写五个适配器分别转成训练格式。Uranus 选的是把五种都转成一种中间表示,多一层转换,换来模型层的统一。
做数据管道的都懂这个取舍:中间表示一旦定下来,后续所有环节都简化;但它要求你一开始就想对"什么信号是本质的"。
顺带说,safetensors 头部那篇是同一个思路的文件版,中间表示(JSON 头)定下来,加载器就不用猜。
骨架、开合、朝向,三个信号,就是 Uranus 给出的答案。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。