
一句话总结:同一周里,百度开源了纯预训练基座 ERNIE-5.5-Flash-Base,腾讯混元 Hy4 发布即开放权重并承诺系统卡片,Kimi 一边开源 2.8 万亿的 K3.1 Pro 一边把 Harness 做成不开源的托管服务。三家都说「开源」,拿到手的东西差得很远:一个是半成品原料,一个是待验证的成品,一个要 640GB 级硬件,还有一个根本不开源但最接近「能用」。
这一周国产模型的发布密度有点高。
周一混元 Hy4,周二百度 ERNIE,中间还夹着 Kimi 的开源和托管服务。每条新闻里都有「开源」两个字。
我把三家的发布说明摆在一起看,发现「开源」这个词被用出了三种意思。
一、三家这一周都发了「开源」,但内容不一样
先摆事实。
| 厂商 | 开了什么 | 附加承诺 | 硬件门槛 |
|---|---|---|---|
| 百度 ERNIE-5.5-Flash-Base | 纯预训练基座,FP8 + BF16 | 无 | FP8 约 280 GB |
| 腾讯 Hy4 | 模型权重 | 系统卡片随后发布 | 官方未公开 |
| Kimi K3.1 Pro | 完整权重 | 许可条款(Modified MIT) | 2.8 万亿参数,按 INT4 折算过 TB |
| Kimi Hosted Agents | 不开源 | 托管服务 + 审计导出 | 无 |
前三行是「开源」,第四行不是。但第四行恰恰是最接近「拿起来就能用」的那个。
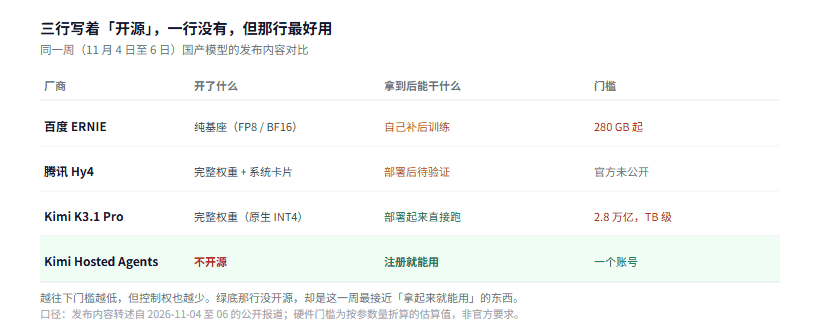
图 1:越往下门槛越低,但控制权也越少
这个反差就是本文想说的事。
二、第一层:开纯基座,你得自己后训练
百度的 ERNIE-5.5-Flash-Base 是最「实在」也最「难用」的一种。
实在在于:它给的是从零预训练的完整权重,33.5 万亿 token 训出来的东西,这个成本别人很难复现。
难用在于:它没做中训练,也没做后训练。
意味着下载下来之后,你得到的是一台「读了很多书但没学过怎么跟人对话」的机器。输入「请告诉我中国的首都是哪里」,它可能接着写「请告诉我美国的首都是哪里」——因为它学的是续写,不是回答。
要让它能聊天,得自己补三步:中训练、SFT、RLHF。
这类开源的价值是「给你一块地」,不是「给你一栋房」。 适合做垂直模型、做研究、做二次开发的人。不适合想直接用的人。
ERNIE 那篇拆过它为什么这么设计:43 层里 37 层做压缩注意力,KV 只省 85% 而不是 128 倍,说明设计者在每个环节都算过账。同样算过账的地方,就是「只开基座」这个决定。
三、第二层:开完整权重,但硬件门槛在
腾讯和 Kimi 走的是这条。
混元 Hy4 这次的姿态挺特别:发布即开源,而且承诺发系统卡片。国内厂商常见的做法是「先说要开源,权重慢慢来」,这次是当场就开。
Kimi K3.1 Pro 也是完整权重,2.8 万亿参数,用 Modified MIT 许可(月活超一亿或月收入超 2000 万美元要在界面显示「Kimi K2」)。
但「完整权重」不等于「你能跑」。
按参数折算,2.8 万亿的模型即使压到 INT4,权重也要以 TB 计。参考K2.7 Code 那篇算的账:1 万亿参数 INT4 就要 640 GB 聚合显存,得 8 张 H200。2.8 万亿只会更大。
这一层的价值是「给你一栋房,但钥匙在八张卡手里」。 有硬件的人能住,没有的人只能看图纸。
四、第三层:不开源,直接给托管服务
Kimi 同一天还发了 Hosted Agents,这个是不开源的。
它把 Agent 运行所需的 Harness 做成云服务:7×24 常驻、独立沙箱、可导出审计、140+ Skills、推理前拦截。
对比一下就很有意思:
开源 2.8 万亿的权重     → 你要有 8 张 H200 才能用
托管服务(不开源)      → 注册个账号就能用
从「能不能用」这个角度看,不开源的那个反而门槛最低。
这不是说开源没价值。开源给的是「控制权」——你可以改、可以离线、可以审计代码。但控制权和使用权是两件事。
大部分人真正需要的不是控制权,是使用权。
这种「开源和托管并行发」的组合,Hosted Agents 那篇里拆过实现细节:会话隔离、审计日志、推理前拦截,三段各管一件事。这三段自己搭也能搭,但得先知道有哪三段。
五、怎么判断一个「开源」宣传值不值得跟
我总结了一个三问法。
第一问:开的是什么?
- 纯基座 → 要自己后训练,门槛最高
- 完整模型 → 理论上能用,看硬件
- 只开推理代码 / 只开评测集 → 基本等于没开
第二问:开了之后我能拿它干什么?
如果答案是「继续训练」,那是给研究者准备的;如果答案是「部署起来接 API」,那是给工程团队准备的;如果答案是「在本机跑」,那要看硬件。
第三问:不开源的那个选项是不是更划算?
这个问题经常被忽略。如果一个模型的开源版要 8 张卡,而托管版按月收费,对 99% 的场景来说托管版更划算。开源的意义不在省钱,在「不受制于人」。
三问过完,一个「开源」宣传的实际价值就清楚了。
六、常见问题
「发布即开源」和「即将开源」差在哪?
差在权重有没有真的放出来。这一周腾讯是前者(当场开),之前不少厂商是后者(说了但没给),中间可能隔几个月。看到「即将」两个字,先别按已开源规划。
Modified MIT 那条款会影响商用吗?
基本不影响。门槛是月活 1 亿或月收入 2000 万美元,正常公司碰不到。比 Llama 那套社区许可宽松。
纯基座和 Chat 版差多少?
差三步训练(中训练、SFT、RLHF)。做得好能接近 Chat 版,做得差会比小模型还笨——因为基座不懂「什么时候该停」。
企业该怎么选?
先看数据能不能出内网。不能出,才考虑自托管,然后再算硬件和运维成本。能出,直接用 API 或托管服务,成本低一个数量级。
开源的模型会不会被人拿去做坏事?
会,所以这次的几个发布都提到了安全审查。腾讯说只纳入防守性网络安全数据、剔除攻击性内容。但权重一旦放出去,后续怎么用厂商管不了——这是开源绕不开的代价。
七、结语
这一周最值得记的不是哪个模型多强,是「开源」这个词已经不够用了。
它至少有三层:开原料、开成品、开成品但钥匙不给你。三种对使用者的意义完全不同,但在标题里都写成「开源」。
我现在看这类新闻,会先找一句话:权重放出来了吗,多大,要什么硬件。 这三项清楚了,剩下的宣传词可以忽略。
至于那个不开源但最接近能用的托管服务——它提醒了一件事:开源是一种分发方式,不是一种价值。 值不值,得看它解决的是谁的问题。
参考资料
- 网易 - 百度文心 5.5 Flash Base 正式开源 - 纯基座定位与「未做中训练后训练」的明确说明
- 腾讯网 - 腾讯混元发布 Hy4 - 发布即开源与系统卡片承诺的官方口径
- 腾讯研究院 AI 速递 20261106 - Hosted Agents 的功能清单与准入条件
- AIToolsRecap - Tencent Shipped Hunyuan Hy4 at 770B - 权重发布状态的第三方核对
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。