
一句话总结:Anthropic 开源 FlashProve,用零知识证明让你在不公开权重的情况下,证明一段回答确实出自承诺的那个模型。代价很实在:证明吞吐 110 token/s,一份证明 19MB,CPU 验证 17 秒,GPU 时间是正常推理的 70 到 95 倍。而且它只证来源,不证正确。
有人问我一个问题,我到现在都没答好。
他问:我怎么知道对面那个 API 真的是 GPT-6,没被换成小模型。
这个问题在技术上一直无解。你只能看它的输出质量、看价格、看服务商的信誉。没有任何硬证据。
FlashProve 想解决的正是这件事。它给出的答案是:不公开权重也能证明。
一、FlashProve 解决的是什么问题:证明来源
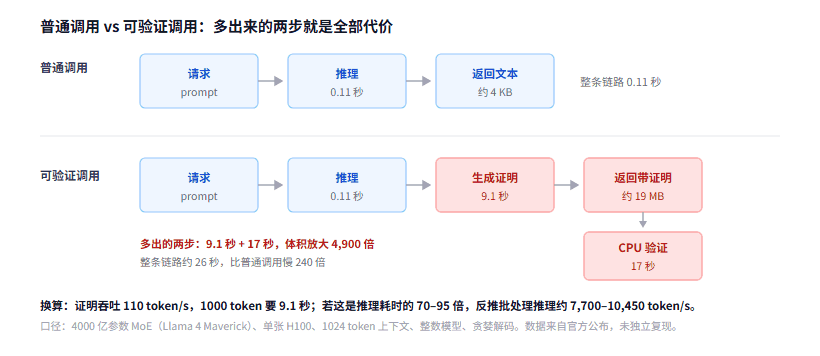
图 1:多出来的两步就是全部代价,一步在服务端,一步在客户端
先定义清楚"证明来源"是什么意思。
你要证明的命题是:这段文本是由模型 M 生成的。不是"由某个模型生成",也不是"由某个参数量相当的模型生成",就是 M。
难点在于你没有 M 的权重。就算有,你也没法从一段文本反推它是哪个模型生成的——生成过程本身有随机性。
FlashProve 用的是零知识证明。做法大概是:服务端在推理过程中同步生成一份证明,这份证明能验证"计算过程符合模型 M 的定义",但不泄露权重和中间状态。
你拿到这份证明,用公开的验证程序跑一遍,通过就说明回答确实来自 M。
关键在于"不公开权重"。 服务商不用把几万亿参数交出去,也能让用户验证。
二、先看三个数字:证明吞吐、体积、验证时间
官方给的实测数据,在 4000 亿参数的 Llama 4 Maverick 上:
| 指标 | 数值 |
|---|---|
| 证明吞吐 | 110 token/s(单张 H100) |
| 每份证明大小 | 18.78 MB |
| CPU 验证耗时 | 17 秒 |
| GPU 时间开销 | 正常推理的 70–95 倍 |
| 支持的上下文 | 1024 token |
我把这几个数字对齐检查了一遍,它们互相能印证。
按 110 token/s 算,1000 token 的证明要 9.1 秒。如果这 9.1 秒是正常推理的 70 到 95 倍,那正常推理只用 0.10 到 0.13 秒——折算下来 7700 到 10450 token/s。
4000 亿参数的 MoE 在 H100 上批处理跑到这个吞吐,是合理量级。所以两组数字是自洽的,口径应该是"批处理推理 vs 单请求证明"。
这也是它最容易被误读的地方。 拿 110 token/s 去比单请求的 80 token/s,会觉得只慢一点;实际上对比的基准是批处理吞吐,差 90 倍。
三、70 到 95 倍的开销,花在哪了
这部分官方没细说,但从零知识证明的通用原理能推。
证明系统要在不泄露数据的前提下,把计算过程"编码"成可以验证的形式。这一步的计算量和被证明的计算量不是线性关系——通常是几十倍的常数开销,因为要做多项式承诺、做 FFT、做群运算。
而且它只能证明整数运算的结果。神经网络推理里有大量浮点运算,要转成定点整数,这会带来额外的适配成本,也可能损失精度。
这是我认为最关键的一条限制:只支持整数模型。 意味着你要证明的那个模型,必须是为这套方案改造过的。原封不动的开源权重直接拿来用,证不了。
四、四条可验证性硬限制:从上下文到解码方式
四条限制,每一条都掐掉一批使用场景。
上下文只有 1024 token。 这个限制最狠。一次只能证明 1024 个 token 的输出,长回答要切片,切片后怎么证明"这些片段属于同一次推理",官方没说。
只支持整数模型。 如上,需要专门改造。
只支持贪婪解码。 也就是 temperature=0。一旦采样,输出的随机性就没法在证明里复现。而大部分生产环境用的是带温度的采样,这条限制直接排除了主流用法。
只证来源,不证正确。 这条最容易被误解。
它证明的是"这段话是 M 生成的",不是"这段话是对的"。模型胡说八道,证明照样通过。所以它解决的是信任问题,不是准确性问题。
这一点和验收口径那篇说的问题是一对的:那篇讲"跑通一次"和"改二十轮还改得动"是两把尺子,这篇讲"出自哪个模型"和"说得对不对"是两把尺子。两把尺子混用,就会出现"证明了来源,却以为证明了内容"的误判。
五、什么场景值得为可验证付这个代价
把成本摊开看:
验一份 2000 token 的回答:证明要跑两轮,约 18 秒 GPU 时间,产出约 38MB,你这边 CPU 验证 34 秒。整个链路从发送到确认,大概 1 分钟。
日常 API 调用:一秒钟几百上千次请求,这个开销完全不可能。
所以能用的场景很窄,但每一个都很硬:
合规审计。 金融、医疗这类行业,监管要求"证明你用的是申报的那个模型"。以前只能靠自查报告,现在有技术手段。
版权与取证。 一段 AI 生成的内容引发争议,需要证明它出自哪个模型。这在司法场景里有价值。
模型供应商的自我证明。 服务商想证明自己没在背地里降级模型——这是行业里公开的秘密,高峰期偷偷换成小模型。FlashProve 让这件事变成可验证的。
学术复现。 论文说"用某某模型跑的实验",别人能验证确实是那个模型。这对可复现性研究有意义。
反过来,它解决不了的事:证明内容质量、证明没有对齐篡改、证明模型的训练数据来源。这些都不在范围内。
六、FlashProve 常见问题
FlashProve 能证明模型没有被微调过吗?
不能。它证明的是"计算过程符合某个模型定义"。如果服务商拿同一个基座做了微调,那个微调后的模型是另一个东西,需要单独证明。
18.78MB 的证明,存起来成本高吗?
单份不高,但乘以规模就吓人。每天 10 万次调用,一天产生 1.9TB 证明。这个量级的存储和传输成本,比原始回答大几千倍。
为什么是 17 秒 CPU 验证?
零知识证明的验证通常比生成快几个数量级,但 17 秒对在线场景还是太慢。这个数字说明它现在的定位是离线审计,不是实时校验。
它会成为行业标准吗?
取决于两件事:能否支持采样解码,以及证明体积能不能降下来。这两条不解决,它只能待在审计场景里。
普通开发者用得上吗?
现在用不上。需要服务端配合改造推理流程,不是调用方单方面能做的。真正的变化要等服务商把它做成默认选项。
七、边界
我没跑过 FlashProve。 所有分析基于官方公布的数字和零知识证明的一般原理。代码是开源的,但跑起来需要 H100 和改造过的整数模型,超出我这边条件。
"70 到 95 倍"这个区间的下限和上限差得有点多。 为什么是区间而不是定值,官方没说。我猜和模型结构、序列长度有关,但没有证据。
1024 token 这个限制的影响,我可能低估了。 长文档分析、代码生成这类任务,输出经常几千 token。切片之后如何保证证明的完整性,这是我看不懂的地方。
它对"模型降级"的约束力,取决于服务商是否愿意用。 技术再完美,不部署就是零。真正的推动力可能来自监管要求,不是技术本身。
站内之前写过从 token 时间戳反推推理服务配置,那篇是黑盒猜测,这篇是密码学证明。一个是"我猜你用了什么",一个是"你无法否认你用了什么"。 后者贵得多,但结论确定。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。