
一句话总结:11 月 2 日美团发布的 LongCat-2.5 是 1.6 万亿参数的原生多模态模型,全程跑在国产算力上,1M token 长序列训练,评测成绩介于 Claude Opus 4.8 和 Opus 5 之间。技术博客里那个「单卡吞吐比 DDP 基线提升 86%」才是真正的信息量——它说明国产卡训万亿模型不是能不能的问题,是怎么调度的问题。
一、先看那个 86%:国产算力卡在哪一环
大部分人看这条新闻会盯着「1.6 万亿」和「比肩 Opus 5」。我看的是技术博客里一句容易被跳过的话:
在所测的长上下文监督微调任务上,优化后的单卡训练吞吐量比 DDP 基线提升 86%,折算下来一张卡能在同样时间干完原来 1.86 张卡的活。
这句话为什么重要?因为国产卡训万亿模型最大的障碍不是算力总量,是单卡显存小。
显存一小,模型就得切得更碎,切得越碎,卡与卡之间要交换的数据就越多。通信一堵,卡的算力就空转。所谓「国产算力能训万亿模型」,很多时候指的是「能训,但跑得慢、成本高」。
86% 这个数字说的是:他们把空转的部分填回来了。
二、国产算力的通信账:把数据关进超节点
美团的做法写在博客里,核心一条是围绕超节点重新分配任务。
具体说,把参数和任务数据的主要通信压在超节点内的高速互联里完成,尽量不让数据跑出机柜。跨机柜的通信带宽小、延迟高,一旦成了瓶颈,整批卡的利用率就掉下来。
我理解这跟盖楼是一个道理。你把材料堆在楼下的仓库,工人每次上楼搬一趟要十分钟;改成每层楼都放一个料房,搬一趟变成一分钟。总工作量没变,但等人搬料的时间没了。
配套的还有显存调度策略和计算负载分配的调整。这三件加起来,才有那个 86%。
三、LongCat-2.5 的规格与训练规模
| 项目 | 数值 |
|---|---|
| 总参数 | 1.6 万亿 |
| 形态 | 原生多模态(视觉输入转为统一 token) |
| 训练序列长度 | 最长 1M token |
| 训练数据量 | 数万亿 token |
| 算力来源 | 全程国产,官方称是目前国产算力上完成的最大训练任务 |
| 评测定位 | 介于 Claude Opus 4.8 与 Opus 5 之间,部分专项超过 Opus 5 |
| 使用方式 | 官网 longcat.ai 体验,开发者走 API |
「原生多模态」这个词值得多说一句。它指的是视觉输入在预训练阶段就转成模型能统一处理的 token,而不是后面挂一个视觉编码器拼接上去。两种做法在简单图片理解上差别不大,但在交互网页、3D 展示这类需要细粒度理解的任务上,原生训练的模型明显更稳。
四、评测定位要打折:自报区间不等于实力
官方说「介于 Opus 4.8 与 Opus 5 之间」,这句话本身没给具体分数,也没说跑在哪几个基准上、用的什么 harness。
这是厂商自报的常规做法,我不打算按字面接受。参照前几天的经验:同一个模型换个测试框架,分数能差二三十个点。Kimi K3 在官方口径里是 88.3,到第三方 harness 上只剩 13。
所以这个定位我标为存疑,等第三方复现。能确认的只有官方自己给的那句区间描述。
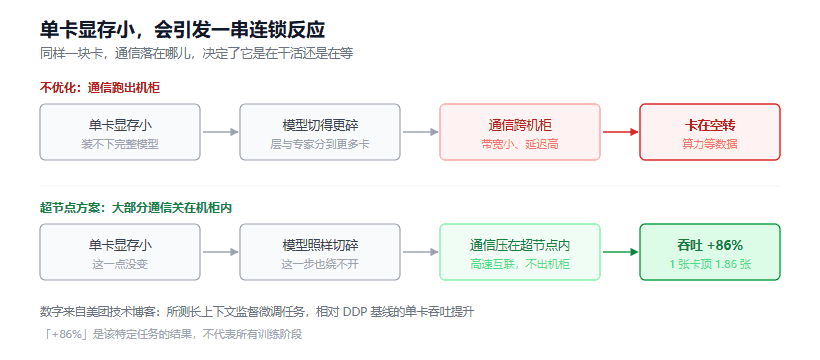
图 1:单卡显存小导致的连锁反应,以及超节点优化打断了哪一环
五、不追通用能力:美团打的是场景牌
有个细节我觉得比参数更值得看。
王兴在二季度财报电话会上说过一句话:「我们不会成为 Token 工厂,我们的模型和 AI 产品将用于支持我们的主业。」
这次 LongCat-2.5 重点强化的两件事,正好对得上:商业分析、软件开发。配套产品叫「妙手」,是给本地生活商家用的 AI 经营工作台,目前服务古茗、徐升记、益禾堂这些连锁品牌。
它干的活大概是:在品牌多渠道经营分析里,自己构建全渠道利润分析表,找出增长中的结构性问题,再给优化建议。
这条路和「做一个通用聊天助手」完全不同。它不需要在 MMLU 上考多高,需要的是懂餐饮零售的指标口径、知道毛利怎么算、能在商家授权范围内调系统。
我认为这是今年国产大模型里最务实的一个方向选择。通用能力追平 Opus 5 是时间问题,但「懂你的行业」这件事,谁先做谁有壁垒。
六、三条万亿路线:LongCat、Mistral、Kimi 各赌什么
放一起看,路线差别很清楚。
Mistral Large 4 是 1.05 万亿,走开放权重,主打数据主权,但许可里写明了 MaaS 要单独授权,许可证那篇拆过,模型本身也单独写过。
Kimi K3.1 Pro 是 2.8 万亿,参数最大,主打长程编码和 Agent,跑分口径那篇讲过它单价降了但单任务没降。
LongCat-2.5 是 1.6 万亿,不开放权重,也不追通用榜,主线是国产算力加行业纵深。
三条路没有高低,是三种赌法:一个赌开放,一个赌能力上限,一个赌场景。
七、坑与边界
第一,86% 是特定任务的数字。 官方写的是「所测长上下文监督微调任务」,不是所有训练阶段都这样。别拿它当通用加速比。
第二,「全程国产算力」的边界没说清。 训练用国产卡,推理部署用什么,官方没讲。这两件事的成本结构完全不同。
第三,1M 序列是真的吗? 训练用了 1M token 序列,但推理时的有效上下文能到多长、长文检索准不准,需要实测。这个数字在多数模型上都要打折。
第四,不开放权重。 想自己部署的团队可以撤了,只能走 API。
结语
这条新闻最值钱的地方,不是 1.6 万亿,也不是比肩 Opus 5,是那个 86%。
它回答了一个很多人心里的疑问:国产卡到底能不能训万亿模型。答案从「理论上能」变成「有具体的工程路径了」。
剩下的问题变成成本。86% 的吞吐提升意味着同样的卡能多干 86% 的活,但国产卡的绝对性能、采购价、机间互联带宽,跟英伟达比还是差一截。这条差距要靠时间填。
给个能用的判断:如果你在做本地生活或零售相关的 AI 应用,可以先去 longcat.ai 试一下它的商业分析能力,看是不是真的懂行业指标。这比看跑分有用。
参考资料
- 环球网 - 美团发布 LongCat-2.5,1.6 万亿参数全程国产算力训练
- 南方都市报 - LongCat-2.5 与「妙手」经营工作台的落地场景
- 中关村在线 - LongCat-2.5 长上下文训练与超节点优化细节
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。