
一句话总结:加速比的理论上限是 1/草稿成本。要拿到 SpecPilot 报的 10.87 倍,草稿成本必须低于 9.2%,接受率至少 0.95,草稿长度要到 21 到 32。三个条件缺一个都到不了,而常规部署里草稿长度通常只设 8。
上一篇写完 10.87 倍,我自己心里没底。
我没怀疑论文造假,只是没法判断这个数字对我意味着什么。10.87 倍听着很猛,但如果它要求一堆我根本达不到的条件,那这数字就只是一个benchmark成绩。
所以我把它拆开算了一遍。
算法很简单,投机解码的加速比有一个闭式解:
加速比 = 期望接受数 / (k × 草稿成本 + 1)
期望接受数 = (1 - α^(k+1)) / (1 - α)
α 是接受率,k 是草稿长度,草稿成本是"跑一次草稿模型的前向 ÷ 跑一次主模型的前向"。
三行代码就能跑。
一、先说上限:加速比超不过 1/草稿成本
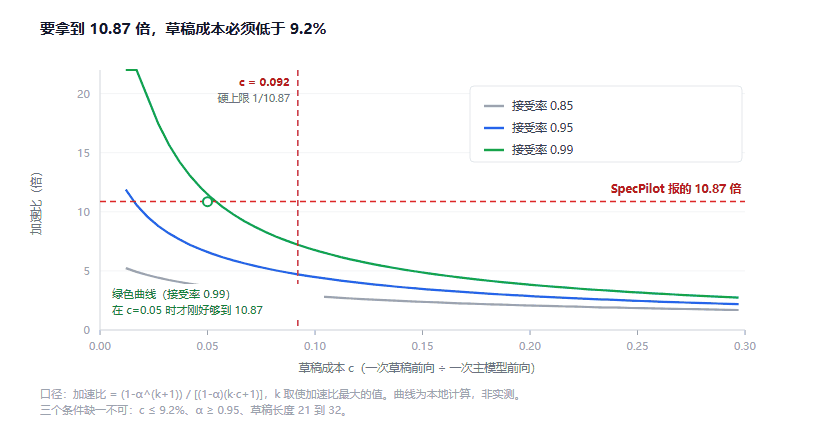
图 1:三条曲线是三种接受率,横轴是草稿成本。红色虚线是 10.87 倍
先看上界。
当接受率无限接近 1、草稿长度无限大时,加速比的极限是 1/c。这个结论很反直觉:不管你模型多聪明、草稿多准,加速比都被草稿成本锁死。
算出来的数:
| 草稿成本 | 加速比上限 | 含义 |
|---|---|---|
| 0.02 | 50.0× | 接近它需要 α 极高 |
| 0.05 | 20.0× | 还有空间 |
| 0.10 | 10.0× | 已经够不到 10.87 了 |
| 0.15 | 6.7× | 常规独立草稿模型的水平 |
| 0.25 | 4.0× | MTP 头的水平 |
| 0.50 | 2.0× | 草稿比主模型还贵一半 |
这张表解释了很多事。
比如为什么大部分投机解码的实测加速比在 2 到 4 倍之间:因为草稿成本普遍在 0.15 到 0.3,上限就是 3.3 到 6.7 倍,再往上不可能。
比如为什么MTP 头那篇里,接受率 90% 只快 1.6 倍:草稿成本 0.35 的时候,上限是 2.86 倍,1.6 倍已经用掉了一半多。
二、10.87 意味着草稿成本必须小于 9.2%
把红线画上去就一目了然。
10.87 倍对应的成本上限是 1/10.87 = 0.092。
这是数学约束,不是工程难度问题。哪怕接受率做到 1.0、草稿长度做到 100,只要草稿成本超过 0.092,加速比就到不了 10.87。
反解一下更清楚。给定接受率,要摸到 10.87 需要多低的成本:
| 接受率 α | 需要的草稿成本 | 最优草稿长度 |
|---|---|---|
| 0.90 | < 0.0001(不可能) | — |
| 0.95 | ≤ 0.0157 | 32 |
| 0.98 | ≤ 0.0387 | 32 |
| 0.99 | ≤ 0.0499 | 32 |
第一行值得单独看:α=0.90 的时候,无论草稿成本多低都到不了 10.87。
为什么?因为接受率不够时,期望接受数有天花板。我把 c 压到 0.0001(几乎为零)再放开 k 搜一遍:α=0.9 时最大只到 9.93 倍,最优 k 是 65;c=0.001 时是 9.49 倍,k 是 44。
也就是说 α=0.9 这条曲线的渐近线在 10 倍附近,永远碰不到 10.87。 这是接受率本身的天花板,调参解决不了。
这就是 SpecPilot 那个 τ 因子在实际起作用的地方:它衡量的是"当前接受的 token 数 vs 理论上能接受的最大数",本质上就是在压这个差距。
三、接受率也得 ≥0.95,否则再低的成本也没用
上一节那张表的第三列还有个信息:最优草稿长度全是 32。
这不是巧合。32 是我脚本里设的搜索上限(kmax=32),意味着最优解一直在边界上,真实最优可能更大。
看具体数字更直观。固定 α=0.95:
| 草稿成本 | 最优 k | 加速比 |
|---|---|---|
| 0.05 | 21 | 6.60× |
| 0.15 | 12 | 3.48× |
| 0.30 | 8 | 2.18× |
成本越低,草稿就该拉得越长。 因为草稿便宜了,多草几个不亏;草稿贵了,多草一个反而拖后腿。
这条规律在常规部署里经常被忽略。大部分框架默认 k=4 到 8,因为怕浪费。但如果你的草稿成本真的只有 0.05,k=8 拿到 5.28 倍,k=21 能拿到 6.60 倍。差 25%。
25% 不算翻天覆地,但它是免费的——同样的硬件、同样的模型,只改一个参数。
SpecPilot 报 10.87 倍,反过来说明它同时做到了两件事:草稿成本压到极低,草稿长度拉到 20 以上。
四、草稿长度要到 21 到 32,不是常见的 8
把三个条件的组合列出来:
| α | c | 最优 k | 加速比 |
|---|---|---|---|
| 0.90 | 0.05 | 13 | 4.67× |
| 0.95 | 0.05 | 21 | 6.60× |
| 0.99 | 0.05 | 32 | 10.86× |
| 0.99 | 0.15 | 31 | 4.87× |
只有 α=0.99 加 c=0.05 那一行接近 10.87,而且它的草稿长度是 31。
这意味着 10.87 倍不是"调一下 k"能拿到的,是一整套系统改造的结果。 草稿成本要降到 1/6 以下,草稿树的结构要支持 30 个以上的节点,接受率还要维持在 0.99。
这也是为什么论文要搞 Agent 自动搜索。人工调这三个参数的组合,基本调不出来。
五、批处理的 3.93 倍:草稿成本被抬到 0.35
批处理场景的数字更有意思。
单请求 10.87 倍,批处理 3.93 倍,差 2.8 倍。为什么?
批处理下,每个请求的验证计算要单独算。主模型一次前向验完 batch 里所有请求的草稿,但验证的计算量随 batch 线性增长。等效于草稿成本被抬高。
我用反解验证这个解释:给定 α=0.95,什么成本能得到 3.93 倍?
等效 cost=0.10 -> 最优 k=15, 加速 4.48x
等效 cost=0.20 -> 最优 k=10, 加速 2.87x
等效 cost=0.35 -> 最优 k= 7, 加速 1.95x
3.93 倍对应的成本在 0.12 到 0.13 之间(c=0.12 是 4.01 倍,c=0.13 是 3.81 倍)。也就是说批处理把等效草稿成本从 0.05 抬到了 0.125 左右,抬了 2.5 倍。
这个解释和论文说的"验证开销砍掉将近一半加速比"对得上。
六、三个条件对实际部署意味着什么
算完这轮,我对 10.87 倍的判断变了。
它不是一个"你能拿到的加速比",而是一个"特定配置下的上限证明"。 论文用 Qwen3.8-27B 加 DFlash2 草稿器,把三个参数同时推到极致,拿到了这个数。
对你我的实际情况,合理的预期是:
如果你用现成的 MTP 头,草稿成本 0.3 到 0.35,接受率 0.9,最优 k 掉到 4。加速比 1.71 倍。这是190 那篇实测的量级。
如果你用独立小模型当草稿器,草稿成本能到 0.1,接受率 0.8 到 0.9 时最优 k 是 6 到 10,加速比 2.47 到 3.43 倍。这是大部分 vLLM 部署的真实水平。
如果你想上 10 倍,三件事必须同时做到:草稿成本 <0.1(要么草稿模型极小,要么草稿和主模型共享计算)、接受率 >0.95(需要领域对齐的草稿器)、k 拉到 20 以上(需要草稿树结构支持)。
这三件事里,第三件最容易做,第一件最难。
七、边界
这是纯计算,不是实测。 我算的是模型的理论加速比,实际还会被内存带宽、批处理调度、KV cache 读写吃掉一部分。真实数字一定比算出来的低。
α 的定义被我简化了。 真实系统里接受率不是常数,它随位置衰减:第一个草稿 token 接受率最高,往后越来越低。我用单一 α 近似,这会高估长草稿的收益。所以 k=32 那个最优解在真实系统里可能不成立。
32 是搜索边界,不是真实最优。 如果放开限制,α=0.99、c=0.05 时最优 k 可能到 40 以上。但那样草稿树的分支数会爆炸,实际不可行。
论文的数字我没复现。 我只验证了"这个数字在数学上要求什么条件",没有验证"它是否真的做到了"。这两个是不同的判断。
站内另有一篇讲循环层显存的账,思路一样:把宣传数字拆成可验证的约束,看它在什么范围内成立。
参考资料
- 腾讯新闻 - 伯克利、英伟达开源优化推测解码的 RSI 框架
- arXiv - SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
- vLLM 文档 - Speculative Decoding
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。