
一句话总结:1.6 万亿参数按 W4A4 存下来是 745GiB,八张 H200 能放下并剩 383GiB,八张 80GB 卡放不下差 105GiB;每生成一个 token 要读 22.4GiB 权重,理论上限 214 tok/s,八卡专家并行可以做到 1700 上下。
模型开源了,能不能跑是另一回事。这笔账算清楚,比看跑分有用。
LongCat-2.5 部署:745GiB 权重需要几张卡
先算权重:1.6 万亿参数 × 4bit ÷ 8 = 800 GB = 745.1 GiB。这是纯存放,不含任何运行时开销。
| 配置 | 总显存 | 每卡权重 | 余量 | 能不能跑 |
|---|---|---|---|---|
| 4 × 141GB | 564 GiB | 186 GiB | -181 GiB | 放不下 |
| 8 × 80GB | 640 GiB | 93 GiB | -105 GiB | 放不下 |
| 8 × 141GB | 1128 GiB | 93 GiB | +383 GiB | 能,余 34% |
| 16 × 80GB | 1280 GiB | 47 GiB | +535 GiB | 能,余 42% |
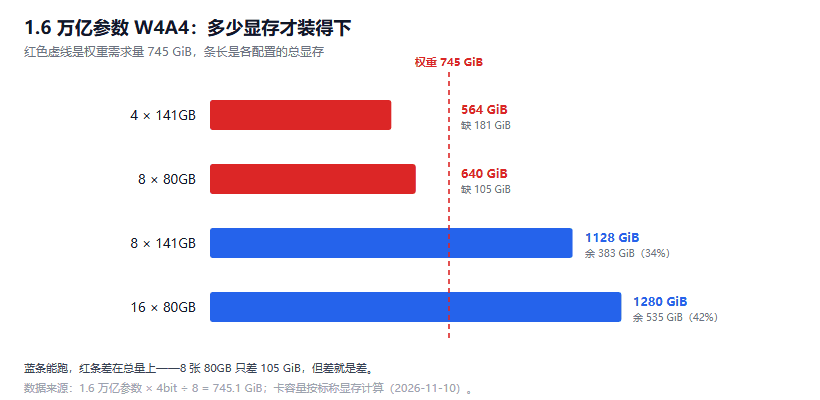
图 1:权重占用与剩余显存,负值表示放不下
结论很直接:至少要 745GiB 的显存总和,卡数不够时更大的单卡也没用。八张 80GB(640GiB)差得不多,但差就是差,跑不起来。
LongCat-2.5 部署的八卡账:每卡 93GiB 权重
八卡 H200 是最现实的配置:745 GiB ÷ 8 ≈ 93 GiB 权重落在每张卡上,剩下 48 GiB。
这 48 GiB 要分给三样东西:
KV cache。 100 万上下文是卖点,也是最吃显存的部分。具体多少取决于层数和 KV 头数,官方没有公布完整配置,我不硬猜。按同规模 MoE 的常见结构(80 层上下、8 个 KV 头、head_dim 128、FP8 存 KV),每 token 约 160KiB,1 万 token 就是 1.6GiB,10 万 token 是 16GiB。48GiB 的余量能支撑十万级上下文,撑不到一百万。
激活值和临时缓冲。 480 亿激活参数在前向过程中要产生中间结果,这部分峰值通常在几个 GiB 量级。
通信缓冲。 专家并行的 all-to-all 需要预留空间,规模跟 batch 和专家分布有关。
真正能给到上下文的,大概 30GiB 上下。所以官方标称 100 万上下文,是能力上限;实际部署时能开多大,取决于你给每张卡留了多少余量。这两件事经常被混为一谈,Kimi K3.1 Pro 那篇里也是同样的口径问题。
每 token 读 22.4GiB,带宽决定速度
480 亿激活参数 × 4bit = 24 GB = 22.4 GiB。这是每生成一个 token 必须从显存读进计算单元的权重量。
H200 的单卡显存带宽是 4.8 TB/s。22.4 GiB ÷ 4.8 TB/s ≈ 4.7 毫秒,对应单卡理论上限约 214 tok/s。
这个数说明 MoE 的推理瓶颈在带宽,不在算力——计算单元大部分时间在等数据。所以有了专家并行:把不同专家分到不同卡上,每张卡只读自己负责的那部分,理论吞吐能到 1700 tok/s 量级(除以卡数之后再乘回来)。
代价是卡间通信。all-to-all 的数据量随 batch 和专家分布变化,实际跑出来的吞吐通常只有理论值的三四成。所以看到"1700 tok/s"别当真,那是零通信开销的上限。
单卡 80GB 那句话的矛盾
官方说"在单卡显存不足 80GB 的环境下用分片把压力分散到超节点内多卡"。这句话容易被理解成"80GB 卡也能跑",但按上面的账,8 张 80GB 差 105GiB。
真正能跑的最小配置是 16 张 80GB(1280GiB)。超节点通常是 8 卡或 16 卡一组,这句话描述的大概是 16 卡那档。
分片解决的是"单卡装不下",解决不了"总量不够"。这两件事在国产卡上尤其容易混——单卡显存小是常态,但集群总显存够不够是另一笔账。
顺带说,权重本身还有 3.7 倍的差额没解释:模型页面显示仓库体积 2.97TB,而 4bit 只要 745GiB。这个差额说明仓库里存的不是 4bit,下之前先看清是哪一份。
至于 4bit 到底损失多少精度,我单独做了一组量化实验:权重和激活同时压到 4bit,相对误差 16.7%,但这是随机权重下的上限,真实模型低一个量级。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。