
一句话总结:Strata 0.2.10 宣称 8GB 显存能跑 128K 上下文。我按 8B 模型算了一遍:128K 的 KV cache 在 FP16 下要 64GB,压到 4bit 也要 16GB,都远超 8GB 卡能分给 KV 的 4GB。所以它一定不是在显存里装下这么多——是把 KV 挪到了内存或者磁盘上。
看到"8GB 显存跑 128K 上下文"这个说法,我第一反应是不可能。
不是怀疑工具做得不好,是这组数字在物理上对不上。
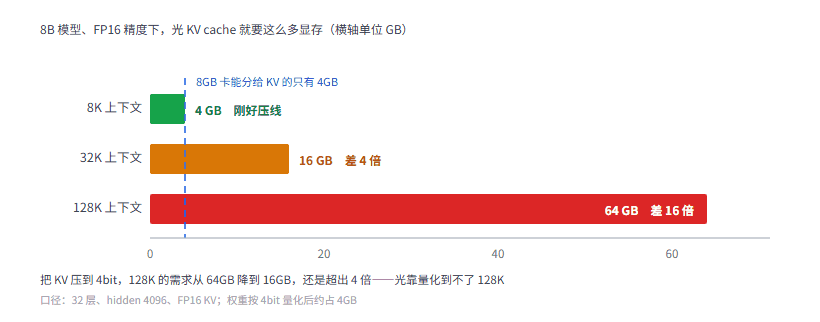
图 1:8K 刚好压线,32K 差 4 倍,128K 差 16 倍
一、先算 128K 的 KV 要多少显存
KV cache 的公式是固定的:
KV 字节数 = 2(K 和 V)× 层数 × hidden 尺寸 × 每元素字节 × token 数拿一个 8B 模型举例:32 层,hidden 4096,FP16 存(每元素 2 字节)。
def kv_gb(layers, hidden, tokens, bytes_per=2):
    return 2 * layers * hidden * bytes_per * tokens / (1024 ** 3)

print(kv_gb(32, 4096, 8192))     # 4.0 GB
print(kv_gb(32, 4096, 32768))    # 16.0 GB
print(kv_gb(32, 4096, 131072))   # 64.0 GB
128K 上下文,光 KV cache 就要 64GB。
这还没算权重。8B 模型按 4bit 量化约 4GB,加起来 68GB。
8GB 的卡,装不下。
二、8GB 卡的真实上限是多少
把权重那 4GB 扣掉,剩 4GB 给 KV。
| KV 精度 | 每 token | 最多支持 |
|---|---|---|
| FP16 | 0.5 MB | 8,192 token(8K) |
| 8bit | 0.25 MB | 16,384(16K) |
| 4bit | 0.125 MB | 32,768(32K) |
就算把 KV 压到 4bit——这已经是精度损失明显的程度了——上限也只有 32K。
离 128K 差 4 倍。
所以问题不是"优化得够不够",是有 60GB 的数据不在显存里。
三、要开到 128K,只能卸载
那 128K 怎么跑起来的?只剩一种可能:KV cache 不放在显存里。
常见做法有三种:
CPU 卸载。 KV 存在系统内存,需要的时候按层搬进显存。内存便宜、容量大,64GB 内存装 128K 的 KV 刚好够。
磁盘卸载。 存到 SSD,容量更大,速度更慢。适合极长上下文但不要求实时的场景。
稀疏注意力 / KV 压缩。 只保留部分 token 的 KV(比如最近的窗口 + 重要的几个),丢掉中间大部分。这能把 128K 压到 8K 量级,但会丢信息。
前两种是"搬家",第三种是"扔掉一部分"。
Strata 具体用了哪种,我没看到技术说明。但从数字推断,一定是前两种之一,或者两者结合。 单纯靠量化到不了。
循环架构那篇也讨论过类似的事——循环层省的是权重显存,KV 反而更贵。KV 这个东西,是所有长上下文方案的共同瓶颈。
四、卸载的代价
搬家不是免费的。
带宽差一个量级。 消费级显卡的显存带宽是 400 到 1000 GB/s,DDR5 内存是 50 到 100 GB/s,NVMe SSD 是 5 到 7 GB/s。
每次生成一个 token,要把整个 KV 过一遍。存在内存里,速度就慢 5 到 10 倍;存在磁盘里,慢 100 倍以上。
实测体感大概是这样:
- 全显存:每秒几十个 token,正常对话速度
- KV 在内存:每秒几个 token,明显变慢但能用
- KV 在磁盘:每秒不到一个 token,基本只能等
所以"8GB 跑 128K"是真的,但速度要按最慢那档预期。
还有 prefill 的问题。 128K 的输入第一次处理要算完整个上下文,这个过程本身就慢。加上 KV 要不断在内存和显存之间搬,总耗时可能是分钟级。
五、什么时候值得用卸载跑长上下文
三类场景它确实有用。
一次性的长文档分析。 扔进去一份 300 页的 PDF,问几个问题,等几分钟能接受。这种场景不需要实时,卸载的代价被摊薄了。
隐私敏感的处理。 数据不能出本地,宁愿慢也要跑在自己机器上。
验证和学习。 想看看长上下文模型在某个任务上表现如何,不想为此租卡。
反过来,这三类不适合:
- 实时对话(等不起)
- 批量处理(吞吐太低)
- 频繁改动的长会话(每次都要重新 prefill)
六、常见问题
8GB 显存跑 128K,是真的吗?
是真的,但"跑"的定义是"能出结果",不是"跑得快"。速度会明显低于全显存方案。
需要多少系统内存?
如果要卸载 64GB 的 KV 到内存,至少得有 64GB 空闲内存。加上系统和权重,建议 96GB 以上。
会不会掉精度?
看它用的是哪种方案。卸载到内存不掉精度(数据还是 FP16),稀疏注意力会掉。
和我直接买个 24GB 卡比呢?
24GB 卡能全显存跑 32K,速度正常。8GB 卡跑 128K 是"能跑",24GB 卡跑 32K 是"好用"。看你更需要长度还是速度。
有更省显存的方案吗?
有。MiniMax 那篇讲的是量化压缩权重,这篇讲的是 KV——两者解决的是不同部分,可以叠加。
结语
这类工具的宣传数字,我建议都换算成"每秒能出几个字"再看。
8GB 跑 128K 是真的,但它的使用体验更接近"批处理"而不是"对话"。知道这一点,就不会买回来发现没法用。
反过来说,如果你确实需要在老机器上处理超长文档,这类工具是目前唯一的选择——慢总比跑不了强。
参考资料
- AI 日报 2026-11-03 - Strata 0.2.10 发布信息
- 27B 模型的上下文内存账 - KV cache 随上下文增长的计算
- vLLM 文档:PagedAttention - KV cache 分页管理机制
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。