
一句话总结:LongCat-2.5 说推理用 W4A4,4bit 存下来只要 745GiB;但模型页显示仓库体积 2.97TB,折下来是 14.85 bit 每参数。这个数只可能说明一件事——仓库里存的是 BF16 原始权重,4bit 要你自己量化。
LongCat-2.5 权重:2.97TB 和 745GiB 差在哪
先把两个数摆一起。
1.6 万亿参数,按 4bit 存:1.6e12 × 4 ÷ 8 = 800 GB = 745 GiB。
模型页写的仓库体积:2.97 TB。
差 3.71 倍。
这个差额不能简单归成"页面写错了"。魔搭这类平台的仓库体积统计的是所有分片文件的实际大小,包含当时上传的全部内容。所以问题变成:这 2.97TB 里到底装的是什么精度的权重。
反推量化位宽:14.85 bit 每参数
算式很直接:
2.97e12 字节 × 8 bit ÷ 1.6e12 参数 = 14.85 bit/参数对照常见的几种精度:
| 精度 | 每参数字节 | 1.6 万亿参数的体积 |
|---|---|---|
| 4bit(W4A4 存储) | 0.5 | 0.80 TB |
| FP8 | 1 | 1.60 TB |
| BF16 | 2 | 3.20 TB |
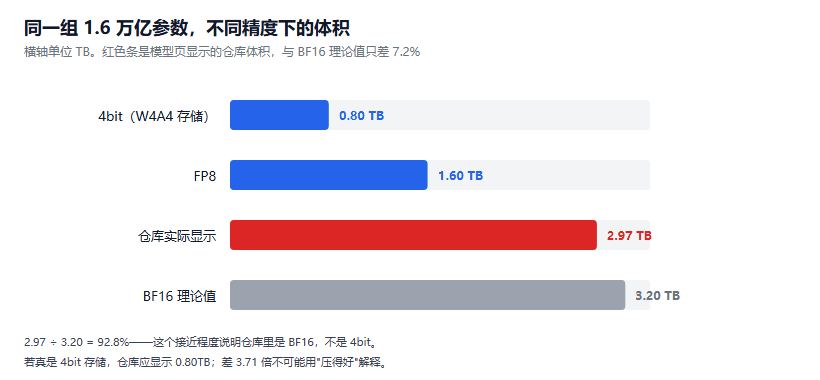
图 1:同一组参数在不同精度下的体积,红点是页面显示的 2.97TB
14.85 bit 落在 8 和 16 之间,但离 16 很近——2.97 TB ÷ 3.20 TB = 92.8%。
这个接近程度不像是巧合。如果仓库里是 FP8,应该看到 1.6TB 左右;如果是 4bit,0.8TB。看到 2.97TB,只能解释成 BF16。
LongCat-2.5 权重最可能是 BF16
剩下的 7.2% 差额有几种可能,我按可能性排:
一是没传完或部分分片用了别的精度。 万亿参数模型通常切成几十个分片,个别分片可能是单独的视觉编码器或者嵌入层,精度不同。
二是参数量的口径不同。 1.6 万亿如果是"主干 + 专家"的总和,那实际存储的还可能包含没算进这个数的模块。
三是页面统计包含了非权重文件。 分词器、配置、示例数据这些加起来通常只有几百 MB,吃不下 7%。
第三种可能性最小。前两种我没法验证,因为没实际拉整个仓库——2.97TB 的下拉成本太高,之前算 Kimi 那 1.56TB时按 9MB/s 算要 48 小时,这个量级更久。
但不管是哪种,结论方向是一致的:W4A4 是推理时的量化策略,不是仓库里的存储格式。
对下载的人意味着什么
这个区别很实际。
第一,下载量。 2.97TB 按 100MB/s(还不错的家宽或小机房带宽)要 8.6 小时;按 9MB/s 要 4 天。如果以为下的是 745GiB,预期会差三倍。
第二,得自己量化。 拿到 BF16 权重之后,要用 GPTQ、AWQ 这类工具做 4bit 量化,这一步需要额外的显存和时间。量化本身也不是无损的,我做的 W4A4 实验里,权重和激活同时压到 4bit 的相对误差是 16.7%(随机权重下的上限)。
第三,量化配置要自己定。 分组大小、哪些层保持高精度、校准集怎么选,这些官方没说,也没有现成的量化版可以直接下。分组从 1024 缩到 32,误差能从 20.5% 降到 13.7%,但显存开销涨 4 倍。
这跟"开源了就能跑"之间隔着一段工程量。部署账那篇算的是权重放不放得下,这里算的是权重从哪来——两件事都得做,顺序是先下 BF16,再量化,再部署。
想看仓库里到底有几个精度版本,最省事的办法是读 model.safetensors.index.json,不用下权重。这个文件的结构和怎么从中反推位宽之前写过一次,思路完全一样:先看每个张量的 dtype 和 shape,再乘起来对总量。
顺带说一句,这个"声明精度 ≠ 仓库精度"的现象不独此一家。厂商公布的量化版本通常指"推理时用什么精度算",而权重仓库里放的是训练产物。要确认下载到的是什么,只有一条路:看 index.json 里的 dtype,别信宣传页。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。