
一句话总结:Fable 5.2 的编程基准从 32.4% 到 49.1%,官方写"提高 16.7 个百分点",媒体可以写"提升 51%",两个数都是真的,但指向的事实不同。用哪个不是文风问题,是选择让读者看到什么。
11 月 9 日 Anthropic 发布 Fable 5.2,FrontierCode 2.0 从 32.4% 升到 49.1%。同一组数字,三种写法:
| 说法 | 数值 | 读者感受到的 |
|---|---|---|
| 提高 16.7 个百分点 | +16.7 pt | 进步明显,但离满分还远 |
| 相对提升 51.5% | ×1.515 | 一半的进步,很大 |
| 接近翻倍 | — | 这句话是错的,1.51 倍不是翻倍 |
第三种是编的,用来说明一件事:数字本身没错,怎么组合会改变读者判断。
同一组数字的三种说法
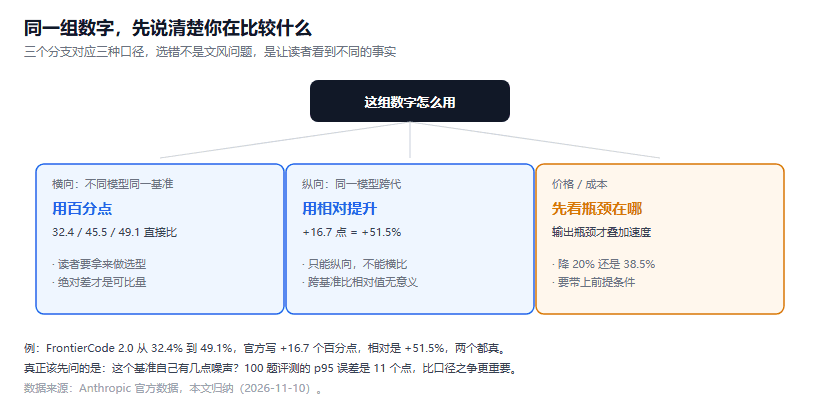
图 1:三个分支对应三种口径,选错不是文风问题,是让读者看到不同的事实
百分点是绝对差,相对提升是比值。两个都从同一组数算出来:
绝对差:49.1 - 32.4 = 16.7 个百分点
相对:  49.1 / 32.4 - 1 = 51.5%
选择哪个,取决于基数的位置。
基线 32.4% 意味着"三分之一的改动能被合并"。在这么低的基数上,任何绝对增长都会带来很大的相对增长。反过来,如果基线是 90%、涨到 95%,绝对差 5 个点,相对只有 5.6%——这时候说"提升 5.6%"会显得毫无进步,而实际上从 90 往 95 走比从 32 往 49 走难得多。
所以两个数都真,但都只讲了一半。
什么时候用百分点
比较不同模型在同一基准上的位置时,用百分点。
理由很直接:同一基准的满分固定,百分点可以直接换算成"多解决了多少比例的问题"。Fable 5.2 的 49.1%、Opus 5.5 的 45.5%、GPT-6 Astra 的 42.8%,差 3.6 个点、6.3 个点,这个差是可比的。
这时候换成相对提升会误导。45.5 比 42.8 高 6.3%,49.1 比 45.5 高 7.9%,看上去差不多,实际上前者是 3 个点、后者是 4 个点,在低分段这两个差距的含义不一样。
写评测的时候有个简单的判断:如果读者要拿这个数做选型,就用百分点。 选型看的是绝对能力差距,不是增长比例。
什么时候用相对提升
讲"这一代比上一代进步多少"时,相对提升更能说明问题,但前提是同一模型。
同一个模型从 32.4 到 49.1,是训练改进的直接结果,这时候说"提升一半"不算夸张,因为它确实把成功率提高了 1.5 倍。
不过这有个陷阱:跨基准不能这么算。Chartography 从 44.8% 到 73.4% 是 +28.6 点、+63.8%,FrontierSWE 从 56.3% 到 69.9% 是 +13.6 点、+24.2%。三个基准的相对提升分别是 51.5%、63.8%、24.2%,看起来图表理解进步最大——但三个基准的难度、分母、评分方式都不同,横着比没有意义。
相对提升只能纵向用,不能横向用。 这是我在写发布稿那篇时最小心的一处。
数字口径最隐蔽的坑:成本降幅
价格类的数字更容易混。
Fable 5.2 把输入输出价从 10/50 降到 8/40,官方写"下调 20%",这个没问题。但同时输出提速 30%,单位任务成本实际降了 38.5%。
成本 ∝ 价格 ÷ 速度
8 / 1.3 = 6.15(相对 10 的 61.5%)
降幅 = 38.5%
这时候该用哪个?
如果是给采购看,用 38.5% 更接近账单的实际变化,但前提是任务真是输出瓶颈。如果任务输入密集(反复读长文档),提速不影响成本,实降就是 20%。
同一个模型、同一组价格,两个降幅都成立,区别在任务类型。写的时候必须带上前提,不然读者按自己的场景一算,发现对不上,整篇文章的可信度就没了。
这类"条件数字"最容易出问题的地方,是把它写成无条件结论。我在文中写"降 20%"还是"降 38.5%",取决于我有没有紧跟一句"假设任务是输出瓶颈"。
指标本身靠不靠得住,是另一个层面的问题。抽 100 题估分那篇算过,100 题的评测 p95 误差是 11 个点——如果基准本身有 11 个点的噪声,纠结 16.7 还是 51% 就没那么重要了。写数字之前先问一句:这个数的误差范围是多少,比选哪种口径更关键。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。