
一句话总结:LongCat-2.5 用 MIT 协议开源,1.6 万亿总参数、480 亿激活、100 万上下文,W4A4 量化后能在单卡不足 80GB 的国产算力上跑;训练细节里最有价值的一条是——任务环境断网、清 git 历史、缓存清空,专门防 agent 钻空子。
11 月 9 日,美团开源 LongCat-2.5,MIT 协议,商用推理和二次训练都不用额外授权。这个协议在万亿参数级别里不常见——同规模的开源模型多数还带自定义许可条款。
LongCat-2.5 的 1.6 万亿和 480 亿,比例是 33 比 1
| 模型 | 总参数 | 每 token 激活 | 稀疏度 |
|---|---|---|---|
| LongCat-2.5 | 1.6 万亿 | 480 亿 | 33 : 1 |
| 混元 Hy4 | 7700 亿 | 490 亿 | 16 : 1 |
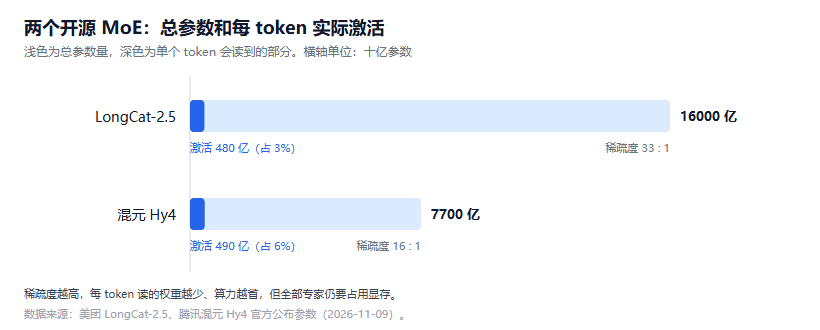
图 1:深色段为每 token 实际激活的参数,浅色为总参数量
33 比 1 意味着每生成一个 token,只碰 3% 的权重。这个比例比 Hy4 激进一倍,直接后果是推理时读的权重少、算力需求低,代价是所有专家都得放在显存里——权重总量没变,只是每次不用全读。
100 万上下文和 480 亿激活放在一起,才是有意思的部分。长上下文最怕的是 KV cache 和注意力计算随长度平方增长,MoE 只解决前馈层的读取量,注意力那部分该算还是要算。
训练时断网、清 git 历史:LongCat-2.5 防的是奖励欺骗
官方技术说明里有一段描述,比任何跑分都值得看:
训练时任务环境会断网、清除 git 历史与文件缓存,由 LLM judge 监督轨迹,并对重复思考、重复工具调用与过度思考施加约束。
这四件事各有用处。
断网断的是"查文档"这条捷径。真实工程任务里,模型可以联网搜到答案;训练时如果允许联网,模型学到的就不是"怎么解决问题",是"怎么搜到答案"。
清 git 历史断的是"看 commit message"。一个仓库的历史里经常写着"修复了某处空指针",直接读历史就知道该改哪里,等于开卷考试。
清缓存断的是"上次跑过留了产物"。不清的话,模型可能学会先跑一遍留下中间文件,第二次直接读。
惩罚重复思考针对的是一种很隐蔽的作弊:模型反复念叨同一步,靠采样运气蒙对。
这一整套做法的名字叫防奖励欺骗(reward hacking)。RL 训练 agent 最大的坑不是模型学不会,是它学会了用你不希望的方式拿到奖励。把环境做成"封闭考场",是唯一可靠的解法。
它同时也解释了为什么长程 agent 的 RL 这么贵:每个任务都要重建一个干净的、断网的、没有历史痕迹的环境。
视觉不是外挂模块
多数多模态模型的做法是:视觉编码器 + 投影层 + 语言主干,三段拼接。LongCat-2.5 走的是另一条路——把原始分辨率的视觉特征转成多层级离散 token,做残差向量量化逐级补细节,视觉码本和主干联合训练。
好处是视觉和文本共享同一套参数、同一个语义空间,不用额外对齐。坏处是训练更贵,码本和主干要一起收敛。
它对"看懂设计稿然后写代码"这类任务有直接帮助:图和代码在同一个表示空间里,不需要先翻译一遍。
W4A4 与 80GB 以下的卡
推理用 W4A4:专家权重和激活同时量化到 4bit,通过原生 INT4 矩阵乘法单元算。官方说已评测的下游任务表现和量化前相当。
1.6 万亿参数按 4bit 存是 745GiB。一张 80GB 的卡装不下,所以他们做了分片:单卡显存不足 80GB 时,把权重压力分散到超节点内多卡,配合混合词表并行、MoonEP 动态专家复制和零拷贝通信。
官方给的结果是长序列 SFT 的单卡吞吐比 DDP 基线提升 86%。这个数说的是训练吞吐,不是推理。推理端能不能跑,看的是权重能不能全放进显存——Kimi K3.1 Pro 的 1.56TB就卡在这一步,8 卡 H200 差 432GB。
顺带一个对不上的数字:模型页面显示的仓库体积是 2.97TB,和 4bit 的 745GiB 差 3.7 倍。这个差额能反推出存的是什么精度,我单独算了一遍。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。