
一句话总结:Kimi K3.1 Pro 总参数 2.78 万亿、激活 1040 亿,权重文件 1.56TB,折合 4.49 bit/参数;单机 8 卡 H200 共 1128GB,缺口 432GB,要 12 张卡才装得下权重。
朋友在做投研 agent,看到 K3.1 Pro 开源,问能不能在他们那台 8 卡机上自托管。
我算了一下:装不下。不是"紧一紧能塞进去"的装不下,是差 432GB 的装不下。
这个数值得写清楚,因为开源模型的宣传里很少提权重文件的绝对体积。
Kimi K3.1 Pro 的 1.56TB 是怎么来的
模型页给的参数量是 2780.11B,权重总量 1.56TB。
两个数一除,就是量化位宽:1.56e12 字节 × 8 / 2.78e12 参数 = 4.49 bit/参数。
这个数对得上官方标注的 MXFP4。MXFP4 是 4 位尾数、每 32 个一组共享一个指数,理论开销 4.25 bit/参数。实测 4.49,多出来的 0.24 bit 说明有一部分参数没用 4 位存。
按 8 位和 4.25 位两组解方程:0.24 / (8 − 4.25) ≈ 6.4%。也就是说大约 6% 的参数还在 8 位精度上——通常是注意力层、归一化层和嵌入层,这些层对精度敏感,压到 4 位会明显掉点。
顺带说一个容易踩的坑:TB 的进制。如果 1.56TB 是十进制,权重是 1.418 TiB;如果厂商按二进制写的,那实际是 1.715TB。两种读法差 10%,后面的账会全错。我按十进制算,因为这个数更保守。
Kimi K3.1 Pro 的规格表:2.8T 参数怎么切
| 维度 | 数值 |
|---|---|
| 总参数 / 激活参数 | 2780.11B / 104B |
| 稀疏度 | 26.7 倍 |
| 层数 | 93(69 层 KDA + 24 层 Gated DSA) |
| 专家数 | 896,每 token 选 16,另有 2 个共享专家 |
| 隐层维度 | 7168 |
| 注意力头数 | 96 |
| 词表 | 160K |
| 上下文 | 1,048,576 token |
| 视觉编码器 | MoonViT-V2,401M |
| 量化 | MXFP4 权重 / MXFP8 激活 |
| 权重体积 | 1.56TB |
93 层里只有 24 层是带稀疏索引的全注意力,其余 69 层换成了 Kimi 线性注意力。这个结构对 KV 的影响比权重更大,单独写了一篇算这笔账。
896 个专家、每 token 只激活 16 个,是 26.7 倍稀疏度的来源。这个设计省算力,但不省显存——所有专家都得常驻,只有计算的时候才挑 16 个。
下载:1.56TB 要多久
按不同带宽算:
| 下行带宽 | 实际速度 | 耗时 |
|---|---|---|
| 100 Mbps | 9 MB/s | 48.1 小时 |
| 300 Mbps | 30 MB/s | 14.4 小时 |
| 1 Gbps | 100 MB/s | 4.3 小时 |
| 1 Gbps 满载 | 125 MB/s | 3.5 小时 |
我这边实测过 9 MB/s 这个档位——单线程走 Ollama blob 的 307 跳转时就是这个速度,后来改用分块 range 并行才上去。1.56TB 按 9 MB/s 要连续下两天,中途断一次就得靠续传。
分片是个现实问题。Hugging Face 的惯例是每个分片 5GB 左右,1.56TB 就是 312 个文件。312 个文件里丢一个,加载器会告诉你"缺 shard 207",但不会告诉你缺哪个张量。
磁盘也要算。下载时的临时文件和最终权重各占一份,峰值至少 3.2TB。要是还想留一份原始 FP8 备份,翻倍。
显存:8 卡 H200 装不下
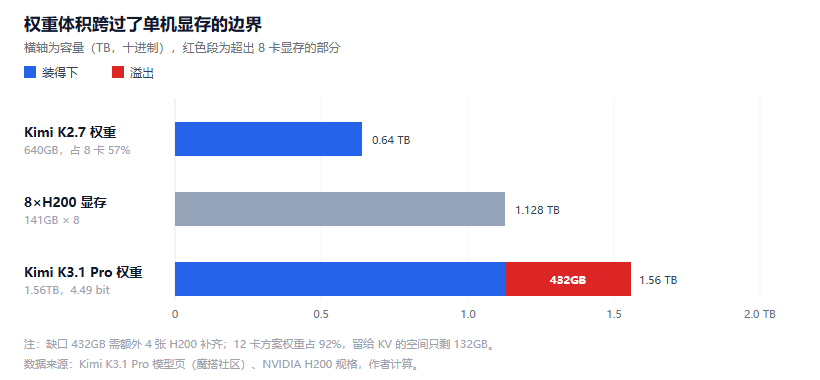
图 1:上条为权重体积,下条为 8×H200 的显存总量,缺口 432GB 高亮。数据来源:模型页参数与 H200 单卡 141GB 显存计算
H200 单卡 141GB,8 卡是 1128GB。
1.56TB = 1560GB。1560 − 1128 = 432GB 缺口。
这意味着三种做法:
- 12 卡:1692GB,权重占 92%,留给 KV 和激活值的空间只剩 132GB,跑 1M 上下文不够
- 16 卡:2256GB,权重占 69%,这个比例才合理
- 8 卡 B300:288GB × 8 = 2304GB,权重占 68%,单机方案
顺带说,上一篇算 Kimi K2.7 的时候,640GB 权重放在 8 卡机上占 56.7%,还有富余。K3.1 把体积干到了 2.4 倍,直接跨过了单机可行的边界。
这个升级很典型:参数量从千亿级走到万亿级,硬件需求不是线性增长,是"从一台机器变成一个机柜"。
Kimi K3.1 Pro 每 token 要读 58GB 权重
顺手算一下推理的带宽压力。
每 token 激活 104B 参数,按 4.49 bit 存,需要读进 104e9 × 4.49 / 8 = 58.4GB 的权重。
H200 的单卡带宽 4.8TB/s。8 卡张量并行时,每张卡只读自己那一片,58.4 / 8 = 7.3GB,除以 4.8TB/s 是 1.52 毫秒,理论上限约 658 token/s。
这个数是天花板,实际到不了。原因有两个:专家路由要全卡通信,896 个专家分到 8 张卡上,每次路由都是一次 all-to-all;每 token 激活的 16 个专家分布在不同卡上,通信量压不下来。
所以真实吞吐大概率在百 token/s 量级。我没实测,这个数标存疑。
和 K2.7 比,翻了 2.4 倍
| 项 | K2.7 | K3.1 Pro |
|---|---|---|
| 权重体积 | 640GB | 1.56TB |
| 量化 | 约 5.1 bit/参数 | 4.49 bit/参数 |
| 8×H200 占用 | 56.7% | 138% |
| 结论 | 单机可行 | 单机不可行 |
有意思的地方在这里:K3.1 的量化更狠(4.49 对 5.12),但参数量涨得更快,所以总量还是翻了一倍多。
量化救不了参数量。4 位已经是可用精度的下限,再往下压就是 2 位、1.58 位那些方案,质量会崩。
关于 Kimi K3.1 Pro 自托管的五个问题
普通公司有必要自托管吗? 大部分没有。16 卡的机器成本加运维,摊到 API 调用上要跑很久才回本。自托管的价值在数据不出域和可微调。
能不能只加载部分专家? 不能。MoE 的专家是按 token 动态路由的,少加载一个专家,碰到它负责的输入就出错。有些实现支持专家卸载到 CPU,但速度掉到不可用。
1M 上下文在自托管里能用吗? 权重占 69% 之后剩 700GB 左右,1M 上下文的 KV 要 123GiB(含索引器),够放。但那是单请求的量,并发一上来就不够了。
开源的权重能商用吗? 模型页写的是 kimi-k3.1-pro 协议,不是 Apache 或 MIT。用之前把协议读完,尤其是用户量和署名条款。
下载有更快的办法吗? 分块并行能到 30-40MB/s,比单线程快三倍以上。国内走镜像站通常比直连快,但要注意镜像的同步延迟。
结语
1.56TB 这个数字的意义不在"大",在它把自托管的门槛从"一台 8 卡机"推到了"两台"。
开源模型这两年一直在做同一件事:把能力往前推,同时把硬件门槛往前推。K3.1 Pro 站在了"单机放不下"这条线的另一侧。
如果你的场景真的需要它,先算三个数:权重体积能不能装下、每 token 要读多少权重、剩下的显存够不够放 KV。三个都过了,再谈部署。
模型卡上写的参数量是给评测看的,权重文件的大小才是给运维看的。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。