
一句话总结:微信视觉团队开源 WeVisOne-VL,用统一输出格式一个模型做完定位、计数、读字、分割、抠图,用约 960 万参数的小模块替掉外接 SAM。另一个更值得看的点是「目标不在图中时返回 None」:4B 版在 Ref-ZOM 上正确拒答率 86.0%,同类开源模型只有 0.3% 和 1.3%。在标注流水线里,这个能力省下的返工成本比精度提升更实在。
做视觉标注的人都有一个共同经历:给模型一张图,让它框出「红色的消防栓」,图里根本没有消防栓,模型还是给你框了一个。
框的是旁边的邮筒,或者一块红色招牌。它不会说「没有」。
这个毛病在 demo 里是笑话,在流水线里是灾难。因为每一条瞎框都要人来删。
WeVisOne-VL 把这件事当成了核心指标来做。
一、WeVisOne-VL 做了什么:五件事一个格式
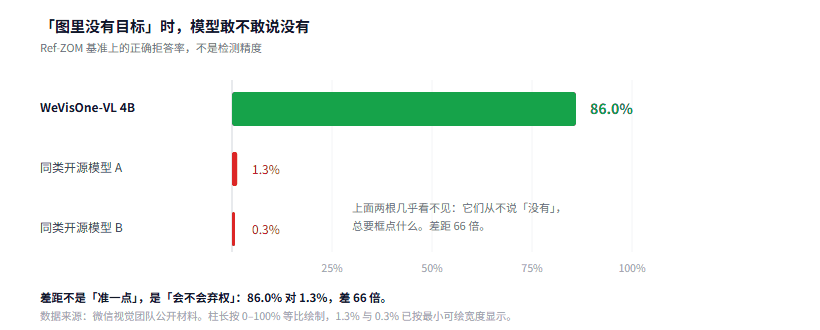
图 1:横轴是「说没有」的准确率。同类模型几乎从不说没有
先说功能范围。
它做五件事:定位、计数、读字、分割、抠图。
不寻常的地方在于用同一个输出格式做。传统做法是拼装:检测模型出框、SAM 出掩码、OCR 出文字、抠图再走一遍 alpha matting。每个环节一个模型,一条流水线四五个组件。
WeVisOne-VL 把输出统一成一种表示,五个任务共用一套解码逻辑。
技术细节上有个数字值得注意:它用一个约 960 万参数的小模块替代了外接的 SAM。
SAM 是 Meta 的分割基础模型,ViT-H 版本有 6.3 亿参数。960 万对 6.3 亿,差 65 倍。这不代表它能完全替代 SAM 的能力,但在「给定框,出掩码」这个具体任务上,够用了。
少一个 6 亿参数的模型挂在那儿,部署成本差一个量级。
二、960 万参数怎么替掉 SAM
我认为关键在于任务被拆窄了。
SAM 是通用分割:给它任意提示(点、框、文本),分割任意物体。这个通用性是用参数换来的——它要理解各种语义。
WeVisOne-VL 里的那个 960 万参数模块不需要通用。它接收的是主模型已经理解过的特征,只需要完成「把这个区域内每个像素属于目标的概率算出来」这一件事。
通用模型和能力专用模块,成本差在这里。
这个思路在工程上很常见:与其挂一个大而全的外部模型,不如在主模型内部加一个小头。缺点是灵活性下降(这个头只能干这一件事),优点是延迟和显存都可控。
三、86% 这个数字为什么重要
现在说核心。
在 Ref-ZOM 这个基准上,目标是「图里没有指定物体时,模型能不能正确说没有」。
| 模型 | 正确拒答率 |
|---|---|
| WeVisOne-VL 4B | 86.0% |
| 同类开源模型 A | 1.3% |
| 同类开源模型 B | 0.3% |
同类模型几乎从来不说「没有」。
这个数字第一次看会觉得夸张。但想想你用过的那类工具——它们被训练成"必须给出答案"。训练数据里每一张图都有标注框,模型从没见过"这张图没有目标"这种情况,自然不会说没有。
WeVisOne-VL 能到 86%,说明训练时专门喂了负样本,而且设计了「不确定就弃权」的输出通道。
这笔账在流水线里怎么算
我算了一下。假设你有 100 万张图要做标注,其中三成不含目标:
100 万张,30% 不含目标 = 30 万张
模型硬框:30 万张都要人工删框,每张 10 秒 = 833 小时 = 104 个工作日
模型返回 None:这 30 万张直接跳过,只抽查 5% = 42 小时 = 5 个工作日
省下 792 小时,按 50 元/小时算约 4 万元
一个「敢说没有」的能力,值 99 个工作日。
而且 86% 不是 100%。剩下 14% 的漏网(约 4.2 万张)还是要返工,117 小时。所以真实收益是"把返工量从 833 小时压到 117 小时",不是归零。
这个区别要说清楚,否则用起来会失望。
四、1 亿张图、36 亿个框是怎么来的
材料里还有个数字:累计自动标注超 1 亿张图、约 36 亿个目标框。
平均一张图 36 个框。这个密度说明它标的不只是"图里有什么",还包括密集重复的目标——货架上的商品、监控画面里的人、票据上的字段。
36 亿个框是这套模型的训练数据来源,也是它的验证场景。 微信内部的标注需求(小程序商品图、视频号内容审核、聊天图片理解)正好提供了这种规模的原始数据。
这一点值得单独说:这类模型不是先有技术再找场景,是先有场景再长出来的。 它解决的是"我们内部每天要标几百万张图"的问题,然后开源出来。
开源范围:2B 和 4B 两个权重、标注工具 Mask2Alpha、Apache 2.0 许可。Apache 2.0 意味着可以商用,这比很多"研究用途"的许可证实在。
五、返回 None 的价值:让模型学会弃权
「弃权」这个设计,我觉得比它的精度更值得学。
大部分模型的默认行为是"必须输出"。分类模型给你一个类别,检测模型给你一个框,问答模型给你一段话。它们没有"不知道"这个选项。
这在开放场景里是致命的。用户问一个模型不知道的事,它编一个答案,比它说"不知道"糟糕得多。
视觉这边同理。检测模型在空图上框一个东西,比返回空更糟——因为框是有成本的,下游要处理它。
WeVisOne-VL 把「None」做成了一个正式输出。这需要在训练数据里准备负样本,在损失函数里给"弃权"一个合理的梯度,在评测里把"正确拒答"当成一个正经指标。
三件事都不难,但很少有人做全。
站内之前写过 Agent 交付前的三件坏事,其中一件是「编出处」。视觉模型在空图上瞎框,本质上是同一个病:宁可编一个,也不肯说没有。
六、WeVisOne-VL 常见问题
960 万参数真能替代 SAM 吗?
在"给定框出掩码"这个任务上够用,在开放域任意分割上不行。如果你的需求是"用户点一下任意物体就分割",还是得用 SAM 那类通用模型。
86% 的正确拒答率算高吗?
相对同类模型的 0.3% 到 1.3%,是数量级的差别。但绝对意义上,14% 的漏网在严格场景(比如质检)里还是不够。要不要用,看你的容错空间。
支持视频吗?
不支持。材料明确写"仅支持图片输入"。视频要逐帧处理,或者等后续版本。
Apache 2.0 可以商用吗?
可以。这是它比很多开源视觉模型实用的地方——不用为许可证纠结。
2B 和 4B 怎么选?
4B 的拒答准确率是 86%,2B 的没给具体数字。如果"敢说没有"是你的核心需求,直接上 4B。如果只是做常规检测,2B 应该够。
七、边界
我没跑过这个模型。 所有数据来自官方材料,86% 这个数字没有第三方复现。
Ref-ZOM 这个基准我没找到详细说明。 它的负样本怎么构造、难度分布如何,决定了 86% 这个数字的含金量。如果负样本都是"明显不相关"的图(比如在猫的照片里找消防栓),86% 就不算难。
返工成本那笔账是我按假设算的。 30% 不含目标、每张 10 秒、50 元/小时,这三个数都是估值。你的实际场景可能差很多,但计算框架可以直接套。
"统一输出格式"的具体实现我没看到。 五个任务共用一个解码器,听起来优雅,实际可能有取舍——比如计数任务和分割任务对精度的要求不一样,共用一套表示会不会互相牵制,这个要看论文。
36 亿个框这个数字我无法验证。 它说明的是训练规模,不是模型能力。
站内另一篇讲决策模型为什么错判比漏判严重,那篇的结论在这里也成立:模型宁可给你一个错的答案,也不愿说不知道,因为训练时没人教它这个选项。
参考资料
- 这笔账在流水线里怎么算
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。