
一句话总结:DeepSeek 把 V4.1 Flash 的权重、训练框架、部署工具链全部开放,还配了技术文档和部署指南。这比「只放权重」多两层,价值在于可改造而不只是可运行。但训练框架开源不等于你能训练——算力门槛一分没降。真正能立刻受益的是第三层:部署工具链,它让中小企业能在自己的机器上把这个模型跑起来。
「全栈开源」这个词,最近被用得很松。
有人放个权重文件就叫全栈。有人放权重加推理代码也叫全栈。
DeepSeek 这次开了三样东西,可以拿来做一把尺子。
一、DeepSeek 这次开了什么:三件套
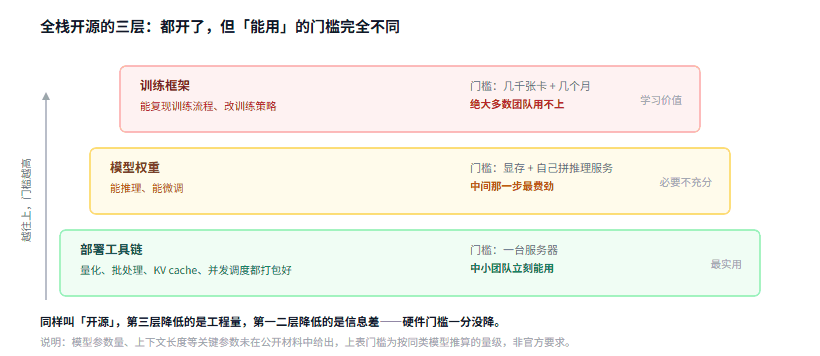
图 1:三层都开了,但每层的「能用」门槛不一样
按材料的说法,V4.1 Flash 开放的是:
- 全部模型权重
- 训练框架
- 部署工具链
配套的还有完整技术文档、部署指南和实操支持。
这三样对应三种不同的用法:
| 层 | 拿到手能干什么 | 门槛 |
|---|---|---|
| 权重 | 拿来推理、微调 | 显存 |
| 训练框架 | 复现训练流程、改训练策略 | 几千张卡 |
| 部署工具链 | 在自己的机器上跑起来 | 一台服务器 |
注意第三行和第一行的区别。 有权重不等于能跑起来——你还得处理量化、批处理、KV cache 管理、并发调度。部署工具链就是把这些打包好。
很多「开源模型」卡在这一步:权重放出来了,但想跑起来得自己拼一套推理服务。对小团队来说,这个工程量比拿权重本身大得多。
二、权重开源和全栈开源的差别
差别可以这么理解。
只放权重,你得到的是一个黑盒的参数文件。能用,但不知道它怎么训出来的,也没法改训练逻辑。
放权重 + 训练框架,你知道了配方。可以复现、可以改,但得有厨房。
再加部署工具链,你连厨房设备都拿到了。这是最实用的一层。
DeepSeek 这次三样都给了。从工程角度看,第三样对中小团队价值最大。
三、训练框架开源了,你能训吗
这是我想泼冷水的地方。
训练框架开源,解决的是「知不知道怎么做」,不解决「做不做得起」。
一个万亿参数级别的模型,训练成本是什么量级?
- 几千张 H100 或同级卡,跑几周到几个月
- 电力、机房、运维,按天计费
- 中间失败要重来,训练不稳定是常态
这些成本一分没降。 框架开源让你少走弯路,但路本身还是要走。
所以「能自己训」这个说法,对绝大多数团队不成立。真正能用上训练框架的场景是:
- 大厂做二次预训练
- 研究机构复现论文
- 有特殊数据、需要从头训一个垂直模型的公司
对个人和小团队,这层的实际作用是学习:看看人家怎么组织数据、怎么设计并行、怎么处理长上下文。这个价值不小,但不是「我能训了」。
四、部署工具链:本地跑的门槛在哪
这层最有实用价值。
按材料,它提供的是「协助全球开发者和企业快速完成本地化部署」。
具体门槛取决于模型规模。V4.1 Flash 的参数量材料里没给,但按「Flash」这个命名,应该是同系列里的轻量版——DeepSeek 之前的 Flash 定位就是「便宜、够用」。
部署这类模型,现实的硬件账大概是:
- 单机 8 卡 80GB:能跑中等规模,量化后上下文可以开长
- 单机 4 卡 48GB:能跑,但并发和上下文都要让步
- 单卡 24GB:只能跑量化得很狠的版本
站内之前算过 27B 模型在 24GB 卡上的量化选型,那笔账可以直接套过来:Q4 的 27B 要 16.1GB,24G 卡够但不宽裕。
部署工具链降低的是「工程量」,不是「硬件量」。 这个区别要说清楚,否则会有人以为有工具链就能在笔记本上跑。
五、低价策略能持续多久
材料里反复提「API 调用成本极低」「人人用得起的普惠 AGI」。
低价是 DeepSeek 一贯的打法。这套打法的逻辑是:用低价换规模,用规模摊薄成本,再用成本优势维持低价。
它能不能持续,取决于两件事:
一是推理效率能不能继续提升。 这靠工程优化,比如更好的批处理、更激进的量化、投机解码。站内算过投机解码的上限,理论上还能挤出几倍。
二是算力成本会不会涨。 上个月我写过算力变贵的信号,CoreWeave 债券跌到面值 79.5%,德州新州长主张暂停数据中心。如果算力成本往上走,低价策略的压力会变大。
两条一起看:低价能维持,但维持的难度在上升。
六、DeepSeek V4.1 Flash 常见问题
V4.1 Flash 和 V5 是什么关系?
不同路线。V5 是旗舰,之前有消息说要上昇腾训练;V4.1 Flash 是同代的轻量版,主打便宜和可部署。两者的定位不冲突。
训练框架开源,我能拿来训自己的模型吗?
技术上可以,经济上基本不行。除非你有几千张卡和几个月的预算。
部署工具链包含什么?
材料说是「协助完成本地化部署」,具体内容没列。参考同类项目的惯例,大概包括推理服务、量化脚本、配置模板、监控接口这些。
和 Llama 系列的开源程度比呢?
Llama 主要是放权重 + 许可,训练细节披露得少。DeepSeek 这次多给了训练框架。但「给」的完整度要看实际仓库,我只看到描述。
低价会一直持续吗?
短期看会。中期取决于算力成本和推理效率的赛跑,这两条我上面算过了。
七、边界
我没下载过这个模型。 所有分析基于公开发布信息,「全栈」到底包含哪些文件、开源到什么粒度,要看实际仓库。
参数量、上下文长度、上下文窗口这些关键参数,材料里都没给。 这让我没法估算真实的部署门槛。「Flash」是个相对概念,可能 7B 也可能 70B,差别很大。
训练框架的价值我可能高估了。 如果它只是一个「训练脚本集合」而不是完整的训练系统,那对研究者的价值也会打折。
低价策略的分析是推演。 我不知道 DeepSeek 的实际成本结构,也不知道它的定价底线在哪。
这篇没有实测数据。 前几篇我都跑了自己的实验,这篇没有——模型太大,本地跑不动,只能做文本分析。这一点要说清楚。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。