
一句话总结:OpenAI 的 API 列表里短暂出现过两个 rc-ada-* 的模型 ID,随后被撤下。rc 通常指 release candidate,ada 是内部代号——这个组合意味着模型已经走到发布前一步。这篇文章拆解模型 ID 的命名约定,给出一个监控 API 列表变化的脚本,以及怎么从 ID 的出现和消失判断发布节奏。
模型还没发布,名字先漏了。
这次漏得很轻——不是权重泄露,不是文档泄露,是两个 ID 在 API 列表里闪了一下。
但对做监控的人来说,这一下就够了。
一、rc-ada-* 这两个 ID 泄露了什么
先说已知的事实。
OpenAI 的 API 模型列表里短暂出现两个以 rc-ada- 开头的 ID,随后被撤下。同期有 Codex 用户反馈被灰测到了 GPT-6.2 Astra。
两条信息合起来能推出什么?
rc 一般是 release candidate 的缩写。 软件行业通用约定:alpha 是内部测试,beta 是外部测试,rc 是「如果没大问题就发这个」。
所以 rc 前缀意味着:这个模型已经过了功能开发阶段,进入「修 bug 等发布」的状态。
ada 大概率是内部代号。 OpenAI 有给模型取代号的习惯(比如早年的 davinci、curie、babbage 都是科学家名字)。ada 对应 Ada Lovelace,是常见的致敬对象。
两条合起来:一个代号为 ada 的候选版本,正在做收尾验证。
那次灰测的细节,站内另一篇记过:用户晒出的实测画面偏重物理真实感,同时有内部模型 ID 短暂出现在 API 列表。两次泄露的模式几乎一样。
这是我基于命名约定的推断,不是官方说法。但它和「Codex 用户被灰测到 Astra」这条能对上——灰测就是 rc 阶段的标准动作。
二、模型 ID 的命名约定
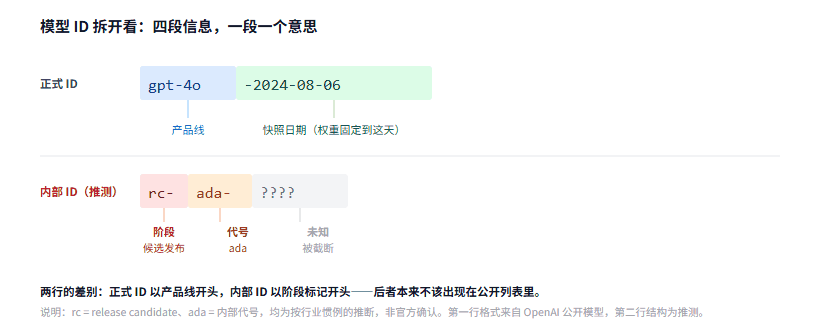
图 1:一个模型 ID 通常包含四段信息,每段的含义都不一样
我把见过的模型 ID 拆了一下,大致有四种成分:
产品线。 gpt-4、gpt-4o、claude-3、gemini-1.5。这段决定你大概能期待什么能力。
版本/代号。 turbo、o1、ada、sonnet。有的是性能档位,有的是内部代号。
阶段标记。 preview、rc、alpha、beta。这段最能透露发布进度。
快照日期。 -2024-08-06 这种。固定指向某一天的权重,不会随更新变化。
四段合起来,你能读出一个模型的完整身份:
gpt-4o-2024-08-06
└┬─┘ └┬┘ └───┬───┘
产品线 版本   快照日期
而 rc-ada-xxx 这个格式不一样——它以阶段标记开头。 这种写法通常用在内部或临时 ID 上,不是给外部用的正式名。
这本身就是信号:出现在公开列表里的内部 ID,说明发布流程正在跑。
三、写个脚本监控模型 ID 变化
这套分析可以自动化。核心思路是定期拉模型列表,记录增删。
import json, time, hashlib
from datetime import datetime

def snapshot(ids):
    """把当前 ID 列表压成一个可比较的快照"""
    return {"ts": datetime.now().isoformat(timespec="seconds"),
            "ids": sorted(ids),
            "hash": hashlib.sha256(
                "|".join(sorted(ids)).encode()).hexdigest()[:12]}

def diff(prev, cur):
    """返回新增和消失的 ID"""
    a, b = set(prev["ids"]), set(cur["ids"])
    return {"added": sorted(b - a), "removed": sorted(a - b)}

def watch(fetch_ids, interval=3600, log="models.jsonl"):
    last = None
    while True:
        cur = snapshot(fetch_ids())
        if last and cur["hash"] != last["hash"]:
            d = diff(last, cur)
            with open(log, "a", encoding="utf-8") as f:
                f.write(json.dumps({**cur, **d}, ensure_ascii=False) + "\n")
            print(cur["ts"], "新增", d["added"], "消失", d["removed"])
        last = cur
        time.sleep(interval)
fetch_ids 换成各家 API 的模型列表接口就行。间隔建议 1 小时以内——像 rc-ada-* 这种闪现,窗口可能只有几十分钟。
关键设计是记 hash。 列表没变就不写日志,一天下来日志只有几行,不会淹掉真正的变化。
四、从模型 ID 变化判断发布节奏
有了时间线,能读出三种信号。
信号一:内部 ID 出现在公开列表。 这是最强的信号。说明发布流程已经在跑,只是还没官宣。rc 前缀的话,距离发布通常以天计。
信号二:ID 消失。 两种可能:一是撤回(发现问题),二是转成正式 ID。区分方法是看接下来有没有新 ID 出现。
信号三:快照日期变化。 同一个产品线出现新的日期快照,说明权重更新了。这个信号最弱,但最稳定——它一定会发生。
把三种信号叠起来看,能画出一条粗略的发布曲线:
| 阶段 | 你会看到什么 |
|---|---|
| 内部测试 | 无变化(ID 不对外) |
| 灰测 | 出现 rc-* 或 -preview 后缀的 ID |
| 发布前 | 出现日期快照 ID,旧别名指向新快照 |
| 发布 | 正式名出现,rc ID 消失 |
这套方法的价值不在预测具体日期,在于知道「现在走到哪一步了」。
五、这套监控方法的局限
四条得说清楚。
第一,只对愿意暴露列表的厂商有效。 有的厂商模型列表是静态的,实际路由在后台。你看到的 ID 和真实用的模型可能对不上。
第二,ID 可以随时改。 厂商知道有人在监控,完全可以在返回结果里把内部 ID 洗掉。这次 rc-ada-* 能漏出来,说明他们的过滤不严。
第三,闪现窗口可能比你轮询的间隔短。 如果它只挂了 10 分钟,而你一小时拉一次,就错过了。要抓这种,得压到分钟级,但容易被限流。
第四,命名约定不统一。 我上面那套拆解是按 OpenAI 的习惯来的,换成 Anthropic 或 Google,规则完全不一样。跨厂商做监控,得为每家写一套解析。
六、rc-ada 常见问题
**rc-ada-* 会变成什么正式名字?**
按 OpenAI 的历史,ada 这类代号很少直接出现在正式名里。更可能的是 gpt-6.2 或者 gpt-6-ada 这种。
监控模型列表违反服务条款吗?
读公开的模型列表端点一般是允许的,它本来就是给开发者用的。但高频轮询可能触发限流,建议控制在每小时几次。
能看到别人看不到的模型吗?
不能。你能看到的和你的账号权限一致。灰测是定向的,监控只能发现「公开列表里的变化」。
这套方法能用在别的厂商上吗?
思路可以,具体解析规则要重写。国内厂商的模型 ID 通常更规整(比如 qwen-max、qwen-plus),但也更少暴露内部阶段。
为什么厂商不干脆隐藏所有内部 ID?
因为灰度测试需要真实用户。完全隐藏的话,测不了。所以总会有漏出来的。
七、边界
这篇的核心推断是推测。 rc = release candidate、ada = 内部代号,都是基于行业惯例的解读,不是官方确认。也可能 rc 是别的意思。
我没有做真实监控。 脚本写出来了,但没接真实 API 跑。所以「多久能发现变化」这类实际参数,我没法给。
命名规律的样本偏少。 我只拆了 OpenAI 公开过的几类 ID,可能漏了其他格式。用它做判断时会误判。
**「灰测到 Astra」和「rc-ada-*」是不是同一个模型,我不能确定。** 两条信息时间接近,但可能指向不同的东西。我在文中把它们并列,没有合并成一个结论。
这类分析的价值有时效性。 等模型正式发布,所有推断都可以验证或者推翻。到那时候这篇就变成了一份「当时的判断记录」,而不是方法论。
站内之前写过从 token 时间戳反推推理服务配置,那是从行为反推配置。这篇是从命名反推流程。两者都是「从露出的边角推全貌」,区别是一个在运行时,一个在发布时。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。