
一句话总结:蚂蚁灵波把机器人大脑拆成五块开源——VLA、VA、Map、Vision、World,各自接进 LeRobot、timm、vLLM、SGLang 这些主流工具链。开源九个月,下载 220 万次、GitHub 3.3 万 star,乌镇挑战赛来了 13 个国家 1855 支队伍。这套开法的价值不在模型本身,在它承认「一家公司不可能覆盖所有机器人构型」。
今年乌镇峰会的主题是"开源开放 共建共享"。
我看到这个主题的时候想的是:又是一句口号。但翻完蚂蚁灵波的材料,发现这次不是喊口号——他们把机器人大脑拆成了五块,一块一块往外放。
这件事为什么值得单说?因为机器人这行的开源,和软件开源完全不是一回事。
一、LingBot 开源了哪几块
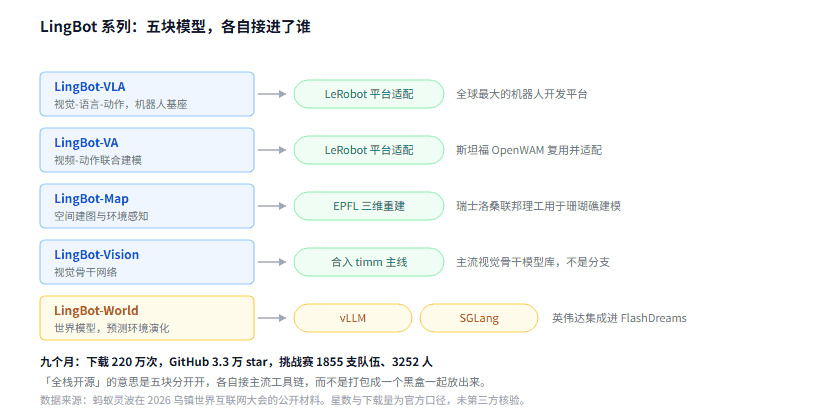
图 1:左边是模型,右边是它接进的平台。这个对应关系比模型参数更能说明开源策略
五个模块,分工不一样:
| 模块 | 管什么 | 接入了哪 |
|---|---|---|
| LingBot-VLA | 视觉-语言-动作,机器人基座 | LeRobot 平台 |
| LingBot-VA | 视频-动作联合建模 | LeRobot;斯坦福 OpenWAM 复用 |
| LingBot-Map | 空间建图与环境感知 | EPFL 珊瑚礁三维重建 |
| LingBot-Vision | 视觉骨干网络 | timm 主线 |
| LingBot-World | 世界模型,预测环境演化 | vLLM、SGLang、英伟达 FlashDreams |
这个拆法有个明显的好处:用的人可以只拿一块。
你要做一个抓取任务,只关心 VLA;你要做仿真环境,只关心 World;你要换视觉骨干,只关心 Vision。不用为了用一块,把整个框架搬回家。
对比一下另一种常见做法:把感知、决策、控制打包成一个"机器人操作系统",对外只暴露一个接口。那种做法对集成商友好,对研究者不友好——你想改中间某一层,得先把整个东西拆开。
二、220 万下载从哪来:被谁用了
官方给的数是:开源九个月,下载量突破 220 万,GitHub star 超过 3.3 万。
这两个数字我没法核验,只能当官方口径看。但材料里列了几个具体的下游用法,这些能查:
- 斯坦福的 OpenWAM 项目复用并适配了 LingBot-VA
- 韩国的 FastOPD 研究拿 LingBot-VLA 当教师模型,去训更轻量的机器人方案
- 瑞士洛桑联邦理工用 LingBot-Map 做珊瑚礁三维重建
第三个例子最有意思。珊瑚礁三维重建,这跟"机器人"八竿子打不着。
但它说明了一件事:空间建图这个能力是通用的。做水下测绘的团队要的也是"从多视角图像还原三维结构",至于这个能力原本是为机器人导航训的,他们不在乎。
这大概是 220 万下载里相当一部分的来源——不是机器人公司在用,是其他领域的人发现这块东西能干自己的活。
三、工具链接入才是关键:vLLM、LeRobot、timm
我认为这批材料里最值得看的是"接入了哪",不是"模型多大"。
原因很实在:开源一个模型,和让这个模型能被别人用起来,中间隔着一整套工程。
举三个例子看差别。
timm 主线 vs timm 分支。 材料里写的是"LingBot-Vision 已合入业界主流视觉骨干模型库 timm 主线"。主线意味着你 pip install timm 之后直接就能调到,不用 clone 一个 fork、不用管版本冲突。分支意味着维护负担转嫁给了用户。
LeRobot 适配。 LeRobot 是目前最大的机器人开发平台。适配它意味着几件事:数据格式要对齐、动作空间要能映射、训练脚本要能跑通。这些工作不产生论文,但决定了别人试用的门槛。
vLLM 和 SGLang 同时支持。 材料说 LingBot-World 是"全球首个同时获得 vLLM、SGLang 两大主流开源推理引擎支持的世界模型"。这两个都是给语言模型做推理加速的,世界模型能接进去,说明它的计算图被改造成了这两个引擎能调度的形式。
这三件事加起来,才是"开源"的完整含义。 只放权重不放适配,等于把模型挂在墙上给人看。
这点和Qwen-AgentWorld 那篇能对照:那篇讲的是一个模型覆盖七类虚拟环境,这篇讲的是一套智能跨机器人构型。两个都在解决"训练环境和使用环境不一致",只是差在虚拟和物理。
四、机器人开源的难点和软件不一样
软件开源,放代码就行。机器人开源,放代码只解决了三分之一。
第一,数据比模型稀缺。 软件任务的数据可以从网上抓,机器人操作数据必须真机采。而且不同构型(机械臂、人形、四足、灵巧手)的动作空间完全不一样,采到的数据不能直接混用。
灵波的说法是"同一套智能在不同机器人构型、任务和场景中复用"。这句话如果成立,价值很大——因为这意味着你换一个机器人本体,不用从头训。
第二,硬件在变。 软件的运行环境相对稳定,机器人的传感器、执行器、通信总线每半年就有新型号。模型训好了,换一批硬件可能要重新标定。
第三,验证成本高。 软件跑个单元测试就知道对不对,机器人要真机跑,一次失败可能撞坏东西。所以机器人领域的"开源复现"比软件难得多。
这三条决定了:机器人开源的价值不在"省了训练费",在"省了试错次数"。 别人踩过的坑写在代码里,你不用再踩一遍。
五、1855 支队伍参赛,机器人开源在抢什么
材料里还有个数字:首届灵波具身大模型挑战赛,13 个国家、648 所高校及企业、1855 支队伍、3252 位选手。
办比赛这件事,通常被理解为营销。但从开源策略看,它干的是另一件事:用比赛把开发者绑到自己的接口上。
参加过比赛的人,熟悉的是你的数据格式、你的评测脚本、你的模型接口。等他毕业进公司要做机器人项目,第一反应就是继续用这套。
这和当年深度学习框架的打法一样。TensorFlow 和 PyTorch 争的不是论文引用,是谁的接口变成了学生的肌肉记忆。
所以办比赛不是花钱买热闹,是在买未来的默认选项。
六、LingBot 常见问题
LingBot 是开源模型还是开源框架?
两者都有。模型权重开源,同时提供数据格式、训练脚本、评测工具。所以既能直接用,也能改。
220 万下载可信吗?
这是官方口径,我没法独立核验。参考量级:一个热门开源模型的月下载量在几十万到几百万之间,220 万九个月属于高位但不离谱。注意下载量会被 CI、镜像、重复拉取放大,不等于用户数。
普通人能用来做什么?
坦白说,门槛不低。需要机器人硬件、需要 ROS 或 LeRobot 的使用经验、需要能采数据。不是装个包就能玩的东西。
和 Google 的 RT 系列、Physical Intelligence 的 π 系列什么关系?
同一个赛道。材料里提到"被 Physical Intelligence、Generalist AI 等全球友商引用",说明在这个圈子里有一定认可度。
为什么要拆成五块而不是一个整体?
因为使用场景太分散。做抓取的、做导航的、做仿真的,需要的模块完全不同。拆开之后每一块都能独立迭代,也都能被单独替换。
七、边界
我没跑过这些模型。 所有分析基于乌镇峰会的公开材料,参数、下载量、star 数都是官方口径。具体的模型规模、训练数据量、评测指标,材料里没给全。
"同一套智能跨构型复用"这个说法我没找到验证。 这是灵波的核心主张,也是最需要证据的地方。跨构型泛化到底能做到什么程度,需要看具体的迁移实验,材料里只有定性描述。
接入主流工具链这件事,能查到的是"已合入",用起来顺不顺我没试过。 timm 主线合入是明确的,LeRobot 适配的具体完成度要看仓库文档。
办比赛和开源的因果关系是我的推断。 材料没说办比赛是为了绑定开发者,这是我的解读,可能过度。
站内之前写过几款 Agent 框架的配合方式,那篇讲的是软件层面 Command、Skill、Subagent 怎么分工。这篇讲的是硬件层面五块模型怎么分工。两者的共同点是:拆得清楚,才换得动。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。